Turnitin Similarity Score vs AI Score: Два разных отчета
Показатель similarity и AI score отвечают на разные вопросы, поэтому работа может получить низкий результат по одному и высокий по другому, и при этом ни один из показателей не будет ошибочным. Что измеряет каждый, что его запускает и что высокий показатель доказывает и не доказывает.

В отчёте указаны два числа: показатель сходства 3 процента и показатель ИИ 88 процентов. Естественно предположить, что они должны измерять одно и то же, а значит, низкое число должно означать, что и высокое число, вероятно, тоже неверно. Но это не так. Turnitin similarity vs AI score представляет собой сравнение двух отдельных систем, которые проверяют два разных аспекта, и одна и та же работа может получить низкий результат по одной шкале и высокий по другой, при этом ни одно из чисел не будет ошибкой.
Это более старая система, чем ИИ, созданная для выявления текста, совпадающего с уже существующим. Она новее, добавлена в тот же Similarity Report как собственный независимый показатель и предназначена для оценки того, выглядит ли проза как сгенерированная машиной, независимо от того, совпадает ли она с чем-либо вообще. Согласно собственной документации Turnitin, они полностью независимы и не влияют друг на друга. Всё остальное в этой статье.

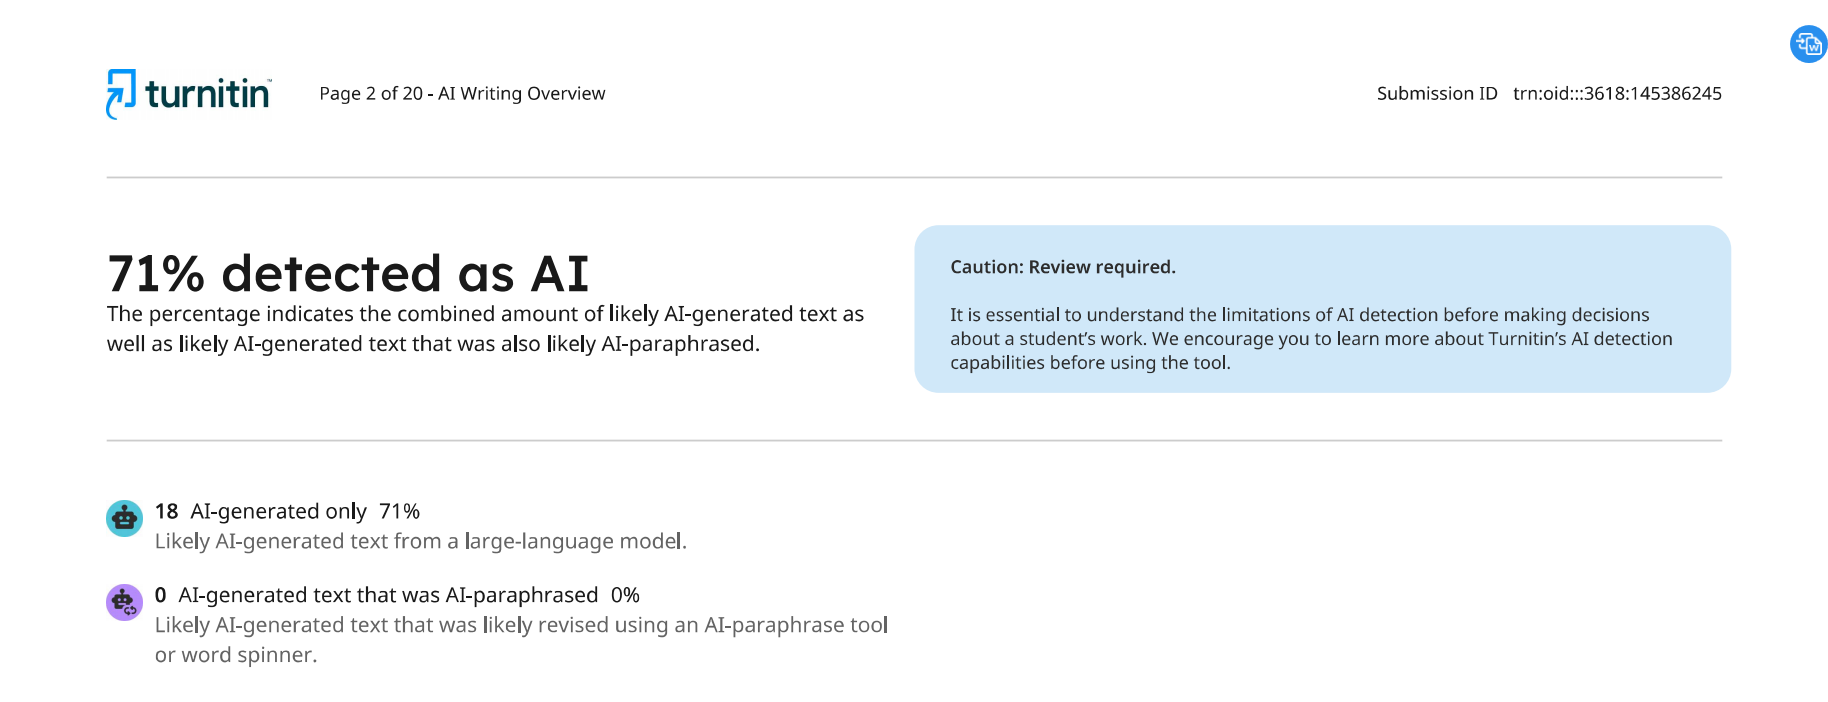
Turnitin Similarity и AI Score: что сообщает каждое число
Turnitin рассматривает эти два показателя как разные измерения, объединенные в одном продукте, а не как два представления одного результата. Similarity Report сравнивает загруженную работу с базой данных веб-контента, академических публикаций и ранее сданных студенческих работ, и возвращает процент текста в работе, который совпадает с чем-то уже содержащимся в этой базе данных. Обнаружение AI writing использует совершенно другую модель, добавленную в тот же отчет как отдельный независимый score, обученный оценивать, насколько проза фрагмента похожа на машинно сгенерированное письмо, без какого-либо обращения к внешней базе данных. Более полные механизмы того, как AI classifier Turnitin приходит к этому числу, рассматриваются отдельно, здесь важно лишь то, что он отвечает на другой вопрос, чем similarity engine, находящийся внутри того же отчета.
Что на самом деле измеряет Similarity Score
Similarity представляет собой упражнение на сопоставление, а не оценку. Собственные рекомендации Turnitin прямо указывают, что инструмент не проверяет на plagiarism. Он проверяет совпадения и оставляет интерпретацию преподавателю, который читает отчет. Цитата, правильно выделенная, фраза из раздела methods, общая для целой subfield, список литературы, оформленный так, как каждый paper в journal оформляет свой reference list: все это может быть зарегистрировано как совпадение, потому что система подсчитывает перекрывающиеся строки текста, а не оценивает, является ли это перекрытие legitimate.
Это также объясняет, почему показатель сходства, равный нулю, доказывает меньше, чем кажется. Он означает, что в работе нет ни одного длинного непрерывного фрагмента текста, найденного в других индексированных источниках Turnitin. Он ничего не говорит о том, как были созданы имеющиеся в ней предложения, потому что составить предложение, не совпадающее ни с чем в базе данных, это не то же самое умение, что и составить предложение, которое языковая модель не смогла бы предсказать.
Очеловечить свою работу
Преобразуйте текст, созданный с помощью AI, и сделайте его более естественным, не затрагивая важные слова или цитаты.
Что на самом деле измеряет показатель AI
У показателя AI нет базы данных, с которой можно было бы сверяться. Классификатор читает представленный текст и, исходя из закономерностей, усвоенных на примерах человеческого письма и текста, сгенерированного AI, оценивает, насколько вероятно, что этот текст создан моделью, а не человеком. В этой оценке не имеет значения, появлялось ли когда-либо точное предложение где-либо ранее. Предложение может быть полностью уникальным, его мог никто не вводить до этой работы, и при этом оно все равно может статистически выглядеть как типичный результат AI, если выбор слов и ритм следуют той схеме, которую языковая модель обычно воспроизводит.
Это та же статистическая область, которая полностью рассматривается в более широком объяснении того, как на самом деле работают детекторы AI: предсказуемость на уровне слов и ритм на уровне предложений, объединенные в один показатель документа. Версия этого классификатора у Turnitin является проприетарной, но исходная предпосылка, что сгенерированный текст обычно статистически более типичен, чем человеческое письмо, остается той же самой и лежит в основе каждого инструмента в этой категории.
| Показатель сходства | Показатель AI | |
|---|---|---|
| Что он измеряет | Насколько текст работы совпадает с другими проиндексированными документами | Насколько проза напоминает статистически типичное письмо, сгенерированное AI |
| Что вызывает высокое значение | Длинные цитаты, распространённые для данной области формулировки, повторно использованный материал или совпадение с предыдущей подачей | Однообразный ритм предложений и последовательно предсказуемый выбор слов по всему документу |
| Что высокое значение не доказывает | Что совпавший текст был использован ненадлежащим образом. Корректно процитированный материал тоже может быть отмечен как совпадение. | Что какое-либо одно предложение было сгенерировано AI. Классификатор анализирует общий рисунок документа, а не одну строку изолированно. |
Может ли у работы быть 0 процентов сходства и 90 процентов показателя AI?
Да, и такое сочетание не является сбоем. Эти два показателя отвечают на разные вопросы, поэтому возможны все четыре сочетания высоких и низких значений, и каждое из них указывает на нечто иное в том, как был создан текст.
- Низкое сходство, низкий показатель AI: обычный оригинальный текст, который при этом читается с типичной для человека вариативностью. Это обычный случай для большинства подлинных студенческих работ.
- Низкое сходство, высокий показатель AI: оригинальные предложения, не скопированные ниоткуда, которые читаются как статистически предсказуемые, в том смысле, как это свойственно сгенерированному тексту. Признак неотредактированного AI-текста, из которого никто не делал парафраз существующего источника.
- Высокое сходство, низкий показатель AI: текст, который близко совпадает с существующим человеческим источником, без статистической однообразности, которую классификатор связывает с генерацией. Скопированный текст, обнаруженный старым инструментом, а не новым.
- Высокое сходство, высокий показатель AI: текст, который совпадает с существующим источником, сам являвшимся сгенерированным AI, например с ранее поданной работой, написанной AI, или со страницей текста, созданного AI, уже проиндексированной из открытой сети.
Ни одна из этих комбинаций не требует ничего необычного со стороны программного обеспечения. Они вытекают из того, что одна система проверяет совпадение, а другая проверяет шаблон, и фрагмент текста может обладать либо одним из этих свойств, либо обоими, либо ни одним.
Что высокий AI Score доказывает, а что не доказывает
Высокий AI Score, это статистическая оценка, а не признание, извлечённое из текста. Она говорит, что проза перед классификатором по своему выбору слов и ритму напоминает тот тип письма, который модель была обучена связывать с генерацией AI. Она не определяет конкретное предложение как определённо написанное машиной и не знает ничего о том, как документ был фактически создан, только о том, как он читается после завершения. TextPulse занимает ту же позицию в отношении собственных чисел: то, что он сообщает, это оценочный Human Score, вычисленный по тексту перед ним, а не вердикт о том, какой инструмент, если таковой был, затронул документ.
Практический ответ на любое из этих чисел, низкий similarity score или высокий AI Score, одинаков, относиться к нему как к основанию присмотреться внимательнее, а не как к выводу, который следует принять или отвергнуть с первого взгляда. Черновики, заметки и история версий говорят о том, как документ был фактически написан, так, как процент никогда не может, ни в одном из отчётов. Любой, кому интересно, на что именно классификатор реагирует в его собственном черновике, может увидеть тот же шаблон на уровне слов самостоятельно с помощью free perplexity checker, задолго до того, как будет сгенерирован какой-либо отчёт.
Коллекция free tools collection TextPulse охватывает и другие статистические уровни, которые стоит проверить, прежде чем черновик попадёт к преподавателю, а не только два, сравниваемые здесь.
После того как два числа разделены, следующий вопрос, это что считается хорошим Turnitin score. Для другого детектора, с которым студенты сталкиваются чаще всего, how GPTZero works рассматривается на отдельной странице.
Эти два числа будут по-прежнему стоять рядом в одном и том же отчёте, и люди, спешащие при чтении, будут по-прежнему воспринимать их как одно число. Понимание того, на какой именно вопрос отвечает каждое из них, превращает запутанную пару процентов в две отдельные, полезные единицы информации.
Часто задаваемые вопросы
Turnitin similarity vs AI score сводится к тому, что проверяет каждый из них. Показатель similarity сообщает, какая часть работы совпадает с текстом, уже имеющимся в базе данных Turnitin, включающей веб-страницы, публикации и прошлые студенческие работы. AI score представляет собой отдельное, независимое измерение, которое оценивает, насколько проза читается как сгенерированная машиной, без какого-либо обращения к базе данных. В собственной документации Turnitin указано, что эти два показателя не влияют друг на друга.
PhD in natural language processing, with years spent building NLP applications end to end. Moe works on text analysis: lexical and syntactic structure, and what separates machine-generated prose from human prose statistically. He has been experimenting with computational linguistics since the early days of NLTK, spaCy and WordNet, and still writes most of his tooling in Python.



