Turnitin 유사도 점수와 AI 점수: 두 개의 서로 다른 보고서
유사도 점수와 AI 점수는 서로 다른 질문에 답하므로, 한 논문은 하나에서는 낮고 다른 하나에서는 높게 나올 수 있으며, 어느 숫자도 틀린 것은 아닙니다. 각 점수가 무엇을 측정하는지, 무엇이 그것을 유발하는지, 그리고 높은 수치가 무엇을 입증하고 무엇을 입증하지 않는지를 설명합니다.

보고서에는 두 개의 수치가 제시된다. 유사도 점수는 3퍼센트이고 AI 점수는 88퍼센트이다. 자연스럽게는 이 둘이 같은 것을 측정한다고 생각하기 쉬우므로, 낮은 수치는 높은 수치도 아마 틀렸다는 뜻이어야 한다고 읽히기 쉽다. 그러나 그렇지 않다. Turnitin 유사도와 AI 점수는 서로 다른 두 시스템이 서로 다른 두 가지를 점검하는 비교이며, 하나의 제출물이 한쪽에서는 낮고 다른 쪽에서는 높게 나와도 어느 수치도 오류가 아닐 수 있다.
이 기능은 AI 기능보다 먼저 나왔으며, 이미 존재하는 어떤 텍스트와 일치하는지를 잡아내기 위해 만들어졌다. 더 최근에 추가되었고, 같은 Similarity Report 안에 독립적인 측정값으로 들어가, 문장이 무엇과도 일치하는지와 무관하게 기계가 생성한 글처럼 읽히는지를 추정하도록 설계되었다. Turnitin의 자체 문서에 따르면, 두 기능은 완전히 독립적이며 서로에게 영향을 주지 않는다. 이 글의 나머지 내용도 마찬가지이다.

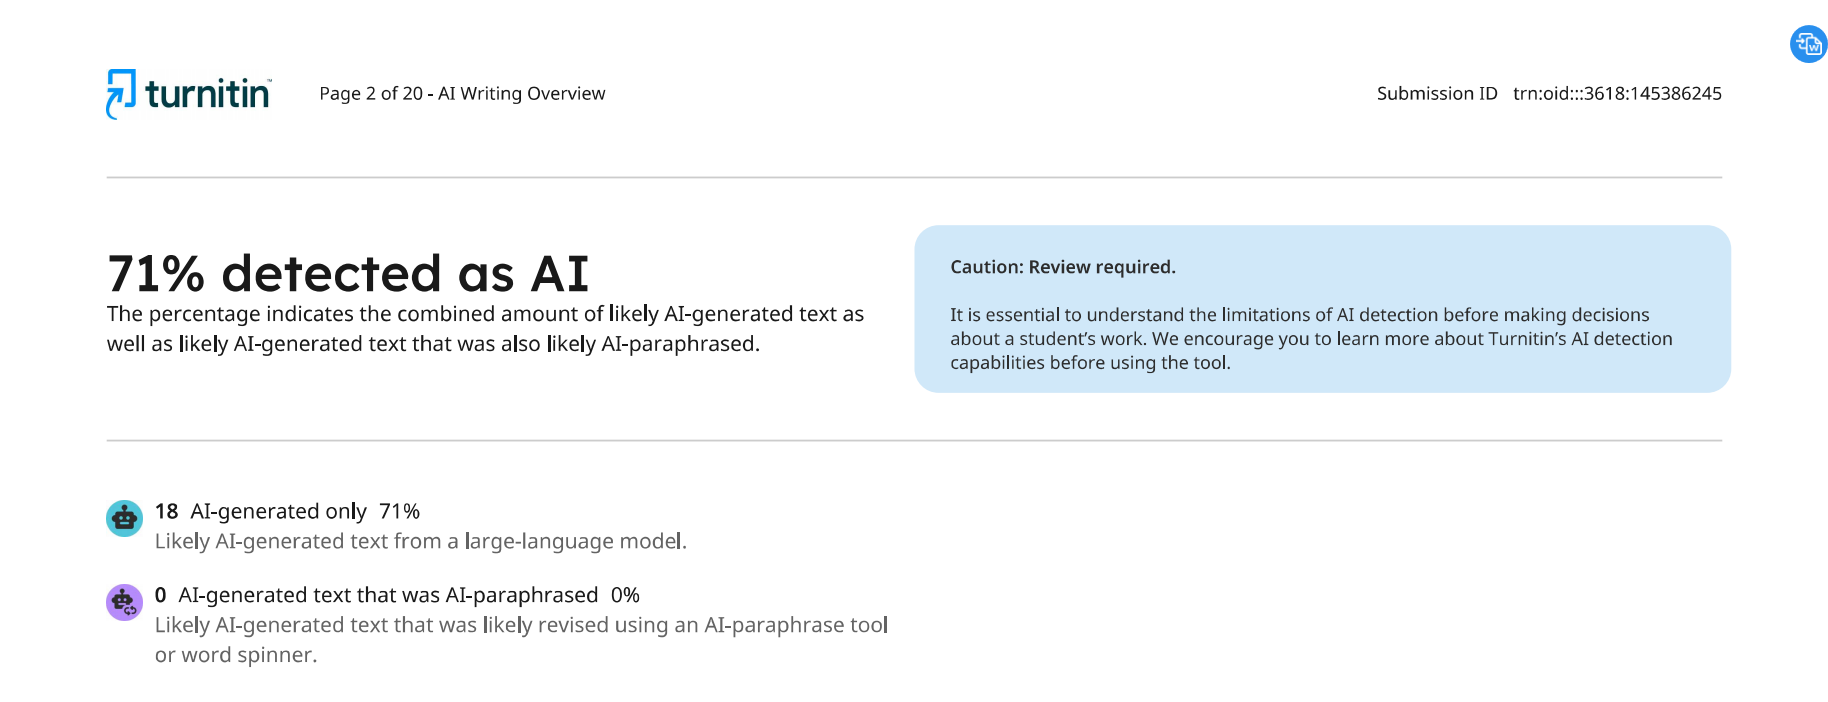
Turnitin 유사도와 AI 점수, 각 숫자가 보고하는 것
Turnitin은 이 둘을 하나의 결과에 대한 두 가지 관점이 아니라, 하나의 제품에 묶인 서로 다른 측정값으로 취급한다. Similarity Report는 제출물을 웹 콘텐츠, 학술 출판물, 그리고 이전에 제출된 학생 논문으로 이루어진 데이터베이스와 비교하여, 제출물 텍스트 중 이미 그 데이터베이스에 있는 것과 일치하는 비율을 반환한다. AI writing detection은 완전히 다른 모델을 사용하며, 같은 report 안에 독립적인 점수로 추가된다. 이 모델은 어떤 외부 데이터베이스도 참조하지 않고, 한 구절의 산문이 기계 생성 글쓰기와 얼마나 유사한지를 판단하도록 학습되었다. Turnitin의 AI 분류기가 그 수치에 도달하는 방식의 더 자세한 작동 원리는 별도로 다루며, 여기서 중요한 점은 그것이 같은 report 안에 있는 similarity engine과는 다른 질문에 답한다는 것이다.
Similarity 점수가 실제로 측정하는 것
Similarity는 판단이 아니라 일치 여부를 확인하는 작업이다. Turnitin의 자체 안내는 이 도구가 표절을 검사하지 않는다고 명시한다. 이 도구는 중복을 확인하고, 해석은 report를 읽는 강사에게 맡긴다. 올바르게 구분된 인용문, 한 하위 분야 전체에서 공유되는 방법론 절의 표현, 저널의 모든 논문이 참고문헌을 작성하는 방식대로 형식화된 참고문헌 목록, 이 모든 것은 일치로 표시될 수 있다. 시스템은 중복되는 문자열을 세기 때문이며, 그 중복이 정당한지 여부를 판단하지 않기 때문이다.
그것이 또한 유사도 점수가 보이는 것만큼은 거의 증명하지 못하는 이유이기도 합니다. 이는 제출물에 Turnitin의 색인된 출처들에서 발견되는, 길고 끊기지 않은 텍스트 구간이 전혀 없다는 뜻입니다. 그러나 그 안에 있는 문장들이 어떻게 생성되었는지에 대해서는 아무것도 말해 주지 않습니다. 데이터베이스에서 아무것과도 일치하지 않는 문장을 만들어 내는 능력은, 언어 모델이 예측하지 못했을 문장을 만들어 내는 능력과는 같은 기술이 아니기 때문입니다.
자신의 논문을 인간적으로 다듬기
중요한 단어나 인용은 건드리지 않고, AI 보조로 작성한 텍스트를 자연스럽고 사람처럼 들리게 바꾸세요.
AI 점수가 실제로 측정하는 것
AI 점수에는 대조할 데이터베이스가 없습니다. 분류기는 제출된 산문을 읽고, 인간이 작성한 글과 AI가 생성한 글의 예시들 전반에서 학습한 패턴을 바탕으로, 그 산문이 사람보다는 모델에서 비롯되었을 가능성이 얼마나 되는지를 추정합니다. 그 추정은 정확히 같은 문장이 이전에 어디선가 나타난 적이 있는지와는 아무런 관련이 없습니다. 어떤 문장은 완전히 독창적일 수 있고, 이 제출물 이전에는 누구도 입력한 적이 없을 수 있으며, 그럼에도 단어 선택과 리듬이 언어 모델이 산출하는 경향이 있는 패턴을 따른다면 통계적으로 AI 출력의 전형적인 사례로 읽힐 수 있습니다.
이는 더 넓은 설명에서 AI 탐지기가 실제로 어떻게 작동하는지에 대해 전부 다루는 바로 그 통계적 영역과 같습니다. 단어 수준의 예측 가능성과 문장 수준의 리듬이 하나의 문서 점수로 결합된 것입니다. Turnitin의 분류기 버전은 독점적이지만, 생성된 텍스트가 인간이 쓴 글보다 통계적으로 더 전형적인 경향이 있다는 근본 전제는 이 범주의 모든 도구 아래에서 작동하는 동일한 전제입니다.
| 유사도 점수 | AI 점수 | |
|---|---|---|
| 무엇을 측정하는가 | 제출물의 텍스트가 다른 색인된 문서와 얼마나 일치하는가 | 산문이 통계적으로 전형적인 AI 생성 글쓰기와 얼마나 유사한가 |
| 높은 수치를 유발하는 것 | 긴 인용문, 해당 분야에서 흔한 표현, 재사용된 자료, 또는 이전 제출물과의 일치 | 문서 전반에 걸친 균일한 문장 리듬과 일관되게 예측 가능한 어휘 선택 |
| 높은 수치가 증명하지 않는 것 | 일치한 텍스트가 부적절하게 사용되었다는 것. 올바르게 인용된 자료도 여전히 일치로 표시될 수 있다. | 어떤 단일 문장이 AI에 의해 생성되었다는 것. 분류기는 한 줄을 고립시켜 읽는 것이 아니라 문서의 전체 패턴을 읽는다. |
논문이 0 Percent 유사도와 90 Percent AI 점수를 가질 수 있는가?
그렇다, 그리고 이 조합은 오류가 아니다. 두 점수는 서로 다른 질문에 답하므로, 높음과 낮음의 네 가지 조합이 모두 가능하며, 각각은 텍스트가 어떻게 생성되었는지에 대해 서로 다른 것을 시사한다.
- 낮은 유사도, 낮은 AI 점수: 일반적인 원문 작성으로, 전형적인 인간의 변이를 보이며 읽히는 경우. 대부분의 진정한 학생 과제에서 흔한 경우이다.
- 낮은 유사도, 높은 AI 점수: 어디에서도 복사되지 않은 원문 문장이지만, 생성된 텍스트가 보이는 방식처럼 통계적으로 예측 가능하게 읽히는 경우. 기존 출처에서 아무도 바꿔 쓰지 않은, 편집되지 않은 AI 글쓰기의 특징이다.
- 높은 유사도, 낮은 AI 점수: 분류기가 생성과 연관시키는 통계적 평탄함 없이, 기존의 인간이 쓴 출처와 밀접하게 일치하는 텍스트. 복사된 텍스트로, 더 오래된 도구에는 걸렸지만 더 새로운 도구에는 걸리지 않은 경우이다.
- 높은 유사도, 높은 AI 점수: 기존 출처와 일치하는 텍스트인데, 그 출처 자체가 AI 생성이었던 경우, 예를 들어 이전에 제출된 AI 작성 논문이나 이미 공개 웹에서 색인된 AI 생성 텍스트의 한 페이지이다.
이러한 조합들 가운데 소프트웨어 측면에서 특별한 것을 요구하는 것은 없다. 이는 한 시스템은 일치 여부를 확인하고 다른 시스템은 패턴 여부를 확인한다는 사실에서 비롯되며, 하나의 텍스트는 두 속성 중 하나를 가질 수도 있고, 둘 다 가질 수도 있으며, 어느 것도 가지지 않을 수도 있기 때문이다.
높은 AI 점수가 무엇을 입증하고, 무엇을 입증하지 않는가
높은 AI 점수는 통계적 추정치이지, 텍스트에서 추출된 자백이 아니다. 이는 분류기 앞에 놓인 산문이, 그 어휘 선택과 리듬에 있어서, 모델이 AI 생성과 연관시키도록 학습된 종류의 글과 유사하다는 뜻이다. 이는 특정 문장이 확실히 기계가 쓴 것이라고 식별하지 않으며, 문서가 실제로 어떻게 작성되었는지도 알지 못하고, 완성된 뒤에 어떻게 읽히는지만 알 뿐이다. TextPulse도 자체 수치에 대해 같은 입장을 취한다. TextPulse가 보고하는 것은 앞에 놓인 텍스트로 계산한 추정 Human Score이지, 어떤 도구가 문서에 관여했는지에 대한 판정이 아니다.
낮은 유사도 점수든 높은 AI 점수든, 두 수치에 대한 실질적 대응은 같다. 즉, 이를 즉시 받아들이거나 배척할 결론이 아니라 더 자세히 살펴볼 이유로 보아야 한다. 초안, 메모, 버전 기록은 문서가 실제로 어떻게 작성되었는지를, 어느 보고서에서도 백분율이 결코 할 수 없는 방식으로 보여준다. 분류기가 자신의 초안에서 실제로 무엇에 반응하는지 궁금한 사람은 보고서가 생성되기 훨씬 전에 무료 perplexity checker로 동일한 단어 수준의 패턴을 직접 확인할 수 있다.
TextPulse의 free tools collection은 초안이 교사에게 전달되기 전에 확인할 만한 다른 통계적 층위도 다루며, 여기서 비교한 두 가지에만 국한되지 않는다.
두 수치를 분리해 보면, 다음 질문은 무엇이 좋은 Turnitin 점수로 간주되는가이다. 학생들이 가장 자주 접하는 다른 탐지기에 대해서는 GPTZero가 작동하는 방식을 별도의 페이지에서 다룬다.
두 숫자는 같은 보고서에서 계속 나란히 놓여 있게 되고, 급하게 읽는 사람들에게는 계속 하나의 숫자로 읽힐 것이다. 각 숫자가 실제로 어떤 질문에 답하고 있는지 아는 것이, 혼란스러운 두 개의 백분율을 서로 분리된 유용한 정보 두 가지로 바꾸어 준다.
자주 묻는 질문
Turnitin 유사도 vs AI 점수는 각 점수가 무엇을 확인하는지에 따라 달라집니다. 유사도 점수는 제출물의 어느 정도가 Turnitin의 웹 페이지, 출판물, 과거 학생 논문 데이터베이스에 이미 있는 텍스트와 일치하는지를 보고합니다. AI 점수는 별도의 독립적인 측정치로, 산문이 기계 생성된 것처럼 얼마나 읽히는지를 추정하며, 어떤 데이터베이스도 전혀 참조하지 않습니다. Turnitin의 자체 문서는 이 두 수치가 서로 영향을 주지 않는다고 명시합니다.
PhD in natural language processing, with years spent building NLP applications end to end. Moe works on text analysis: lexical and syntactic structure, and what separates machine-generated prose from human prose statistically. He has been experimenting with computational linguistics since the early days of NLTK, spaCy and WordNet, and still writes most of his tooling in Python.



