Як працює GPTZero
GPTZero зробив perplexity і burstiness відомими, а потім тихо відмовився від обох. Ось що його класифікатор вимірює тепер, що насправді показує звіт і де сам інструмент називає власні обмеження.

Введіть у рядок пошуку фразу "how gptzero works", і більшість результатів, що повертаються, досі описують perplexity та burstiness, дві статистики, які власний засновник GPTZero зробив відомими в перші тижні після виходу ChatGPT. Цей опис був точним у січні 2023 року. Відтоді він не був точним, починаючи з осені того ж року, коли в документації GPTZero зазначено, що компанія замінила цей підхід чимось зовсім іншим. Розрив між тим, що інструмент робив під час запуску, і тим, що він робить зараз, достатньо великий, щоб більшість пояснень, які й досі поширюються сьогодні, описували продукт, якого вже не існує.
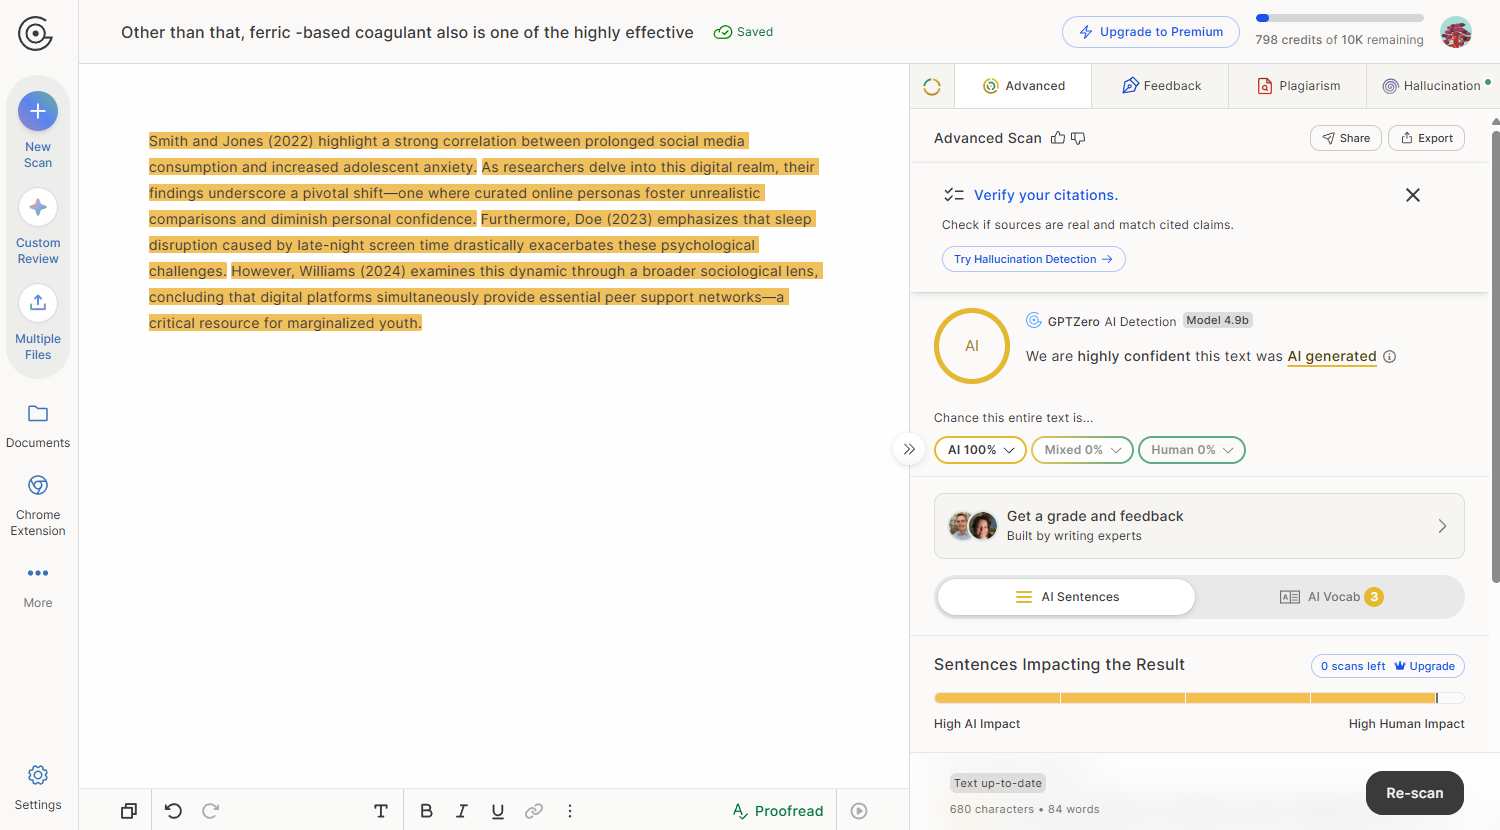
Сьогодні GPTZero виконує класифікацію речення за реченням на великому змішаному корпусі текстів, створених людьми, і текстів, створених ШІ, а не обчислення perplexity. Сьогодні GPTZero все ще надає одне підсумкове число, але арифметика інша. Підсвічування на рівні речень під підсумковим числом також має інше значення, ніж у 2023 році. Обидві версії цієї історії варто знати: та, яка зробила ці терміни відомими, і та, яка фактично працює сьогодні.
Історія: Як Perplexity та Burstiness зробили GPTZero відомим
2 січня 2023 року тодішній студент Принстона Едвард Тянь опублікував публічну демонстрацію GPTZero, лише за кілька тижнів після виходу ChatGPT. Його оригінальна сторінка-роз’яснення описує, як він використав дві статистики, запозичені з мовного моделювання, щоб виявляти, коли мовна модель написала певний текст. Perplexity це показник того, наскільки опорна модель була здивована вибором слів у тексті. Burstiness це назва GPTZero для того, наскільки це здивування коливалося в межах документа. Саме ці сторінки-роз’яснення є причиною того, що обидва слова взагалі потрапили в повсякденну розмову про написання текстів за допомогою AI. Більшість людей, які сьогодні можуть визначити perplexity або burstiness, дізналися ці терміни з GPTZero, а не з підручника.
Механізм сам по собі було просто описати. Пропустіть фрагмент через опорну мовну модель, і прозу, яку модель вважає дуже передбачуваною, з низьким perplexity, слід читати як таку, що є типовою для машин, оскільки під час генерації частіше обирається ймовірне наступне слово, а не те, яке викликає здивування. Навіть власна знята з експлуатації документація GPTZero опублікувала емпіричне правило: perplexity, що перевищує 85, читалося як більш імовірно людське, ніж машинне. Цей поріг походив від одного вендора, на одній моделі, в один момент часу, і сам GPTZero більше не підтримує його.
Як GPTZero працює зараз: класифікатор на рівні речення
Центр підтримки GPTZero стверджує це прямо: "Станом на осінь 2023 року GPTZero більше не використовує perplexity і burstiness для виявлення AI, оскільки ми перейшли на архітектуру, засновану на глибинному навчанні". Його поточна сторінка технологій, підтверджує, що перемикання є повним. Там описано "підхід до наскрізного глибинного навчання, навчений на текстових наборах даних з вебу, освіти та AI-генерованих даних з різних LLM", у якому "модель класифікації на рівні речення за реченням визначає ймовірність і впевненість у тому, що текст створено за допомогою AI". Perplexity і burstiness на цій сторінці не згадуються.
Відтоді також додали рівень захисту, Paraphraser Shield, створений для виявлення тексту, згенерованого або переробленого інструментом редагування, який використовують, щоб обійти виявлення ШІ. Ви можете вставити текст, завантажити Word-документи, PDF-файли та файли з зображеннями, а також до п'ятдесяти файлів одночасно. Жодна з цієї інфраструктури не має стосунку до підрахунку того, як часто опорна модель могла б вгадати те саме слово.
Що саме показує звіт GPTZero
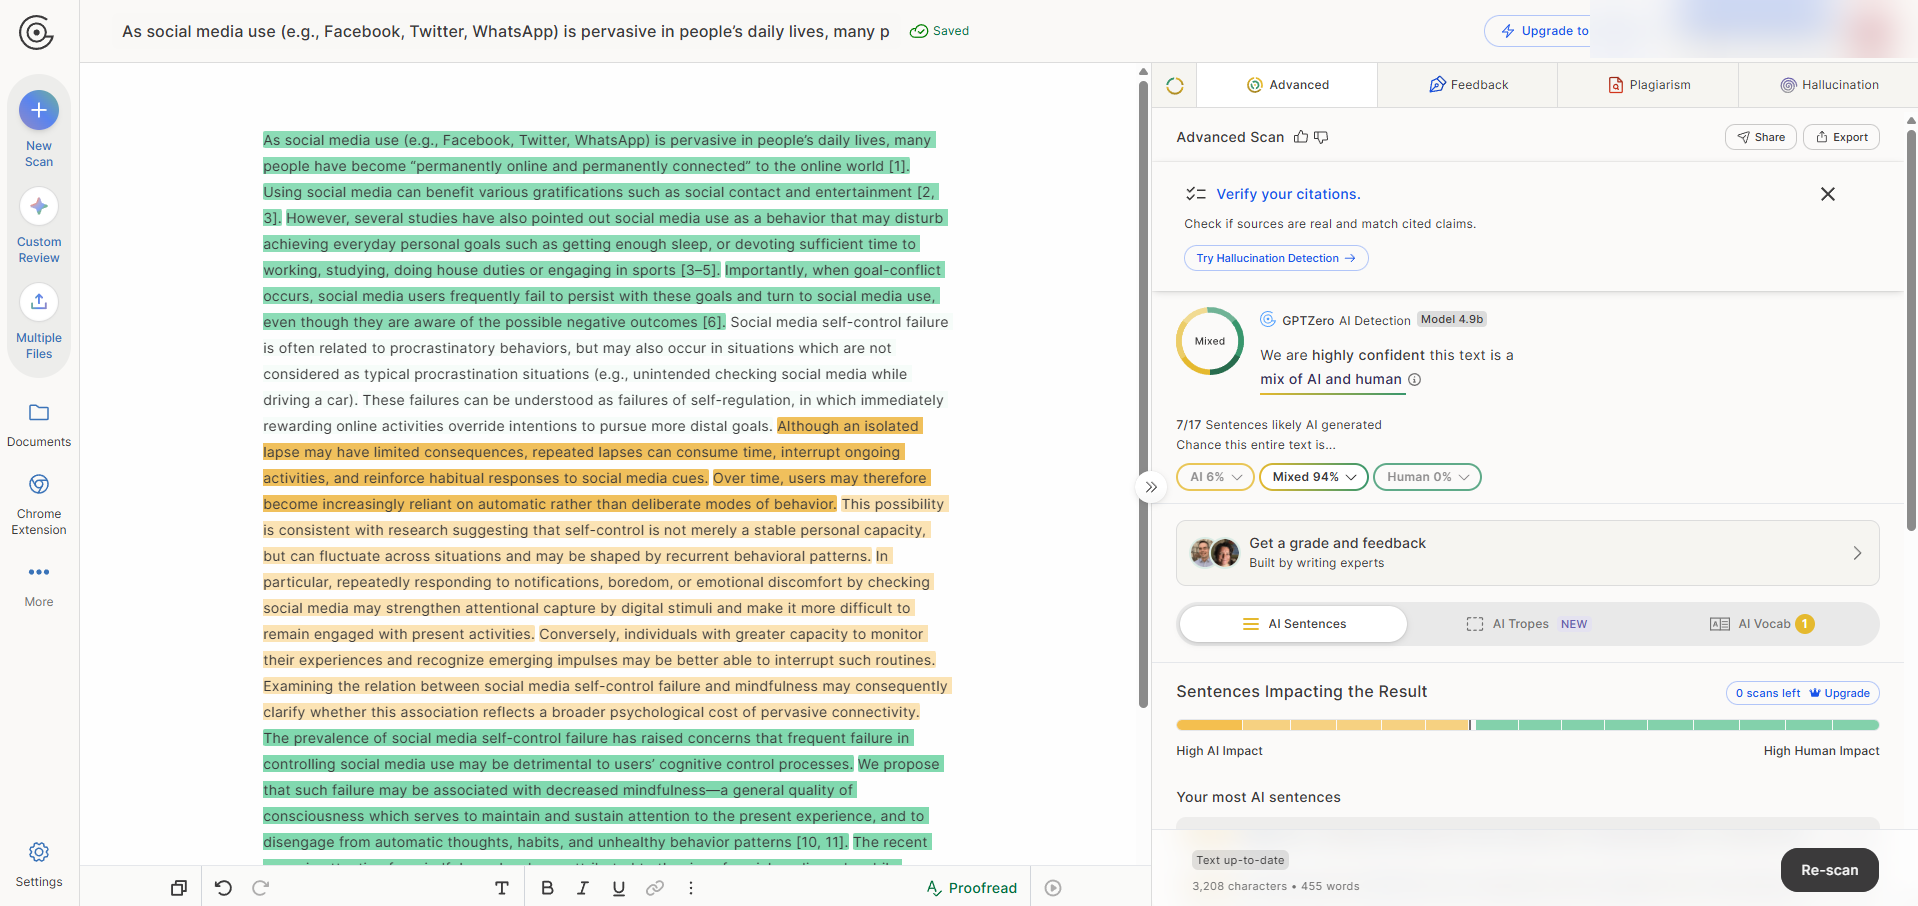
Результат GPTZero містить три частини: класифікацію ШІ, людини або змішаного варіанту, відсоток, який відображає ймовірність того, що документ написано ШІ, та мітку впевненості, яка описує, наскільки надійним є це конкретне припущення. Ця мітка важить більше, ніж може здатися. GPTZero пов'язує "highly confident" із частотою помилок нижче 2 відсотків, а "low confidence" із частотою помилок 14 відсотків або вище, тобто з доволі широким діапазоном, у межах якого той самий відсоток у заголовку може мати дуже різну вагу від одного звіту до іншого.
Платні сканування додають підсвічування на рівні речень, і варто читати це коректно. GPTZero описує підсвічені речення як ті, що непропорційно сильно впливають на загальний бал, а не як перелік звинувачень проти окремих рядків. Речення може не бути підсвіченим і все одно вплинути на результат, оскільки класифікатор читає документ загалом, а не голосує за реченнями по черзі.
| Елемент звіту | Що він вам повідомляє |
|---|---|
| Класифікація | Одна мітка: AI, human або mixed |
| Оцінка ймовірності AI | Відсоток, що відображає, наскільки ймовірно, що модель вважає документ написаним AI |
| Мітка впевненості | Від діапазону highly confident, з частотою помилок нижче 2 відсотків, до low confidence, 14 відсотків або вище |
| Підсвічування речень | Позначає речення, які найбільше сприяють балу в Advanced Scan, а не кожне речення, пов'язане з ним |
Жоден із цих елементів звіту не існував у своїй нинішній формі, коли пояснення про perplexity і burstiness ще було публічним описом GPTZero самого себе. Інтерфейс змінився разом із методикою.
Гуманізуйте свою власну статтю
Перетворіть текст, створений за допомогою AI, і зробіть його природним, не змінюючи важливих слів або цитат.
Чому опис Perplexity і Burstiness досі поширюється
Оригінальний роз’яснювальний матеріал GPTZero досі доступний онлайн, досі проіндексований і досі є одним із найзрозуміліших загальних описів того, як працюють perplexity і burstiness як концепції. Пошукові системи та інші сайти продовжують на нього посилатися, і деякі вказують на широко поширений огляд 2026 року, який стверджує, що інструмент досі непомітно працює з шаром perplexity і burstiness поруч із його класифікатором. Натомість поточні сторінки GPTZero, сторінка про технологію та обидві довідкові статті кажуть протилежне: ці терміни було знято з використання, а не просто приховано за лаштунками. Сторінка, що описує концепцію в абстрактному вигляді, не є тим самим, що сторінка, яка описує теперішній метод цього інструмента, і ставлення цих двох як взаємозамінних є, мабуть, головною причиною того, чому плутанина тривала три роки після дати закінчення строку дії.
Це має значення поза межами дрібниць. Студенту або колезі, якому радять знизити perplexity чи розтягнути довжину речень спеціально, щоб обійти GPTZero, дають поради, спрямовані на версію продукту, яка перестала працювати у 2023 році. Те, що змінює роботу реченнєвого класифікатора, є спорідненим, але іншим питанням, ближчим до ширшого опису як AI детектори насправді працюють, ніж до будь-якої статистики самої по собі. GPTZero не припинив їх вимірювати, за власними даними вони входять до семи індикаторів, що живлять поточну модель, але вони перестали бути тим, що визначає відповідь.
Що GPTZero каже, що воно не може зробити
Опубліковані бенчмарки GPTZero за силою приблизно такі ж, як і те, що постачальник імовірно опублікує про власний продукт. Компанія повідомляє про «частку точності 99% під час виявлення тексту, згенерованого ШІ, порівняно з людським письмом», каже «ми підтримуємо рівень хибнопозитивних результатів GPTZero не більше ніж 1% під час оцінювання тексту, згенерованого ШІ, порівняно з людським текстом», і фіксує «96,5% рівня точності» у заявках, що поєднують текст, згенерований ШІ, і людське письмо, поряд із 1,1 відсотка у тестах TOEFL, поширеному заміннику для письма англійською мовою не носіями. Ці цифри походять з власної оцінки GPTZero, опублікованої у січні 2025 року, без наведеної на сторінці, що повідомляє ці дані, незалежної реплікації. Та сама сторінка також відхиляє твердження, до якого вдається більшість постачальників, зазначаючи, що «ніколи не буде гарантії 100%», і що будь-хто, хто стверджує інше, ймовірно, має ваду у своїх даних або методі оцінювання.
Власна сторінка обмежень GPTZero є конкретнішою, ніж маркетингові цифри. Компанія зазначає, що точність покращується зі збільшенням обсягу поданого тексту і знижується на рівні речення та абзацу порівняно з повним документом. Вона стверджує, що її навчальні дані здебільшого складаються з дорослого англомовного прозового тексту, тому текст, який відхиляється від цього шаблону, складніше надійно класифікувати. Вона зазначає, що класифікатор не навчали виявляти текст, згенерований ШІ, який було суттєво змінено після генерації. І вона прямо вказує, що інше машинно згенероване або високо процедурне письмо, не лише вивід чатбота, може позначатися так само.
Ніщо з цього не є підставою вважати число GPTZero таким, що не підлягає сумніву, і це не єдиний детектор, який варто розуміти у власних термінах. Читачі, які цікавляться, на що саме насправді реагує класифікатор такого типу, можуть побачити версію цього шаблону для себе за допомогою безплатного перевіряча perplexity або безплатного перевіряча burstiness, двох елементів більш повної колекції безплатних інструментів, що охоплює інші статистичні шари, на які спирається звіт такого типу.
Дві ключові статистики GPTZero мають власні сторінки: що саме вимірює perplexity у виявленні ИІ, і математичне обчислення ймовірності токена, яке дає обидва ці числа.
Інструмент, який готовий назвати власні сліпі зони так точно, заслуговує на більше довіри, ніж той, що стверджує, що їх немає, а наступний необґрунтований відсоток у звіті є хорошим місцем, щоб почати запитувати, який саме тип інструмента його згенерував.
Що показало наше власне дослідження
У дослідженні узгодженості детекторів TextPulse Research дев'ять комерційних ШІ-детекторів оцінили ті самі 90 академічних текстів. Один із них був гібридним текстом на 455 слів: написані людиною вступ і завершення навколо згенерованої ШІ середньої частини на 168 слів. GPTZero оцінив цей текст у 41.2% ШІ, тоді як вердикти інших інструментів щодо тих самих слів розійшлися від 0% до 95.7% ШІ. Повна стаття, корпус і матриця оцінок кожного інструмента відкрито доступні на TextPulse Research.
Часті запитання
Ні. Центр підтримки GPTZero зазначає, що компанія припинила використовувати perplexity і burstiness для виявлення станом на осінь 2023 року, після переходу на класифікатор глибокого навчання. Його поточна сторінка про технологію описує модель класифікації речення за реченням і не згадує жоден із цих термінів. Це опис і далі поширюється, тому що власне пояснення GPTZero 2023 року популяризувало обидва слова до зміни методу.
PhD in natural language processing, with years spent building NLP applications end to end. Moe works on text analysis: lexical and syntactic structure, and what separates machine-generated prose from human prose statistically. He has been experimenting with computational linguistics since the early days of NLTK, spaCy and WordNet, and still writes most of his tooling in Python.



