Turnitin Similarity Score vs AI Score: Два різні звіти
Показник схожості та AI score відповідають на різні запитання, тому робота може мати низький бал за одним і високий за іншим, і жоден із цих показників не буде хибним. Що вимірює кожен, що його запускає, і що високий показник доводить, а що ні.

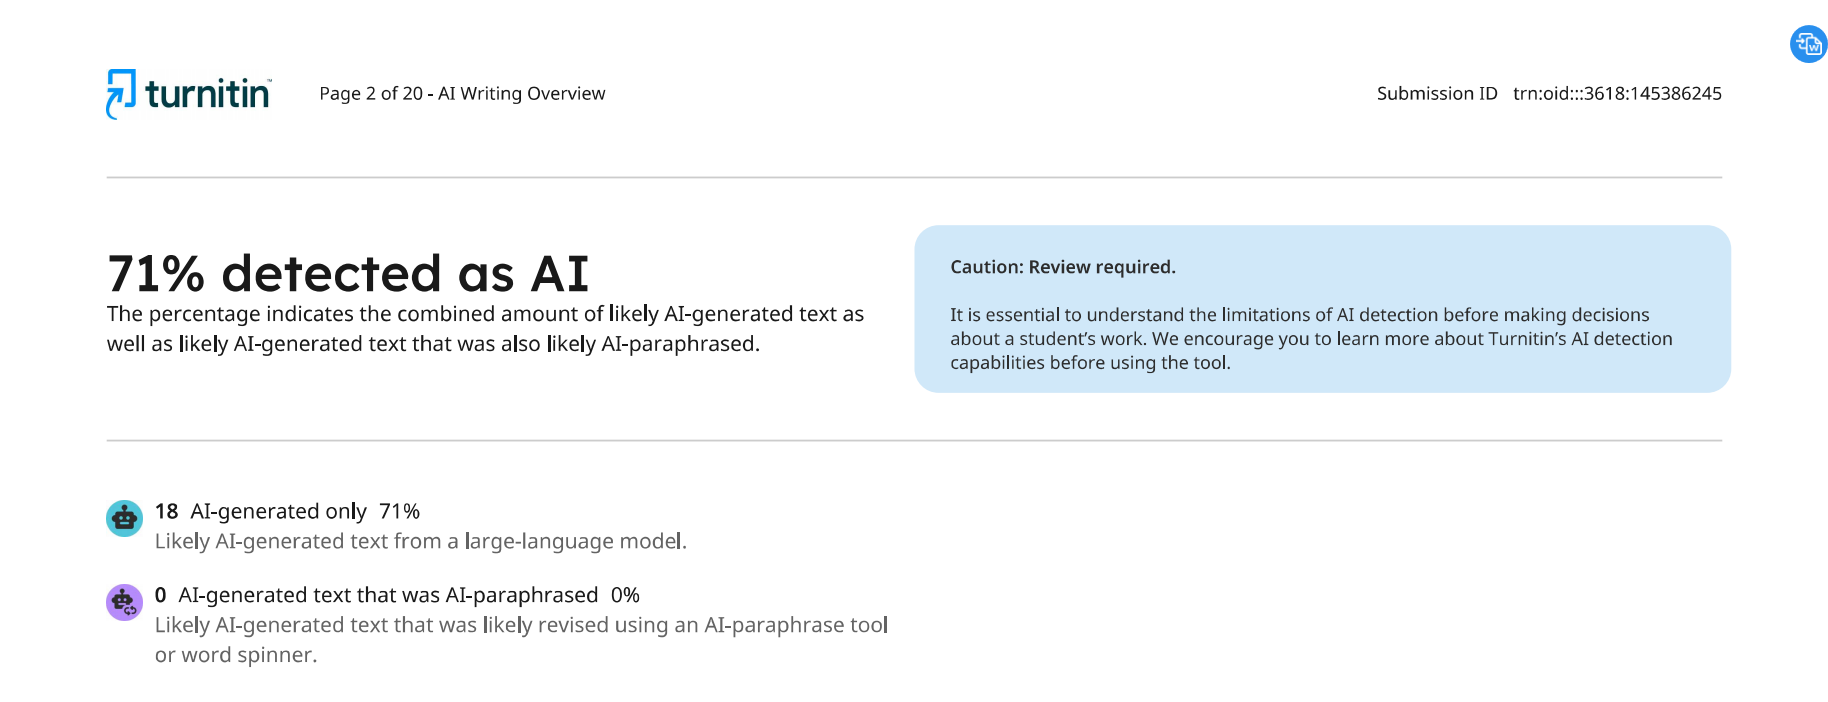
Звіт містить два числа: показник подібності 3 відсотки та AI score 88 відсотків. Природне тлумачення таке, що вони мають вимірювати одне й те саме, отже низьке число повинно означати, що високе число, ймовірно, теж неправильне. Але це не працює так. Turnitin similarity vs AI score, це порівняння двох окремих систем, які перевіряють два окремі аспекти, і подання може мати низький показник в одній системі та високий в іншій, без того щоб будь-яке з чисел було помилкою.
Ця система старіша за AI, її створено для виявлення тексту, що збігається з уже наявним. Вона новіша, її додано до того самого Similarity Report як окреме незалежне вимірювання, створене для оцінювання того, чи виглядає проза як згенерована машиною, незалежно від того, чи збігається вона з чимось узагалі. Згідно з власною документацією Turnitin, вони повністю незалежні й не впливають одна на одну. Усе інше в цій статті.

Показник подібності Turnitin і AI Score: що саме повідомляє кожне число
Turnitin розглядає ці два показники як різні вимірювання, об'єднані в одному продукті, а не як два погляди на один результат. Звіт про подібність порівнює подання з базою даних вебконтенту, академічних публікацій і раніше поданих студентських робіт, а потім повертає відсоток тексту подання, який збігається з тим, що вже є в цій базі даних. Виявлення написання за допомогою AI працює на основі зовсім іншої моделі, доданої до того самого звіту як окремий незалежний показник, навченої оцінювати, наскільки проза уривка нагадує машинно згенероване письмо, без будь-якого звернення до зовнішньої бази даних. Детальніший механізм того, як класифікатор AI у Turnitin доходить до цього числа, розглянуто окремо, тут важливо лише те, що він відповідає на інше запитання, ніж механізм подібності, який міститься в тому самому звіті.
Що насправді вимірює показник подібності
Подібність є вправою на зіставлення, а не оцінюванням. Власні рекомендації Turnitin прямо зазначають, що інструмент не перевіряє на плагіат. Він перевіряє збіги і залишає інтерпретацію викладачеві, який читає звіт. Цитата, правильно виділена, фраза з розділу методів, спільна для цілого підполя, список літератури, оформлений так, як кожна стаття в журналі оформлює свій список літератури: усе це може бути зафіксовано як збіг, тому що система рахує перекривні послідовності тексту, а не оцінює, чи є цей збіг правомірним.
Ось чому також показник схожості, що дорівнює нулю, доводить менше, ніж здається. Це означає, що в поданій роботі немає жодного довгого, неперервного фрагмента тексту, знайденого в інших індексованих джерелах Turnitin. Це нічого не говорить про те, як були створені наявні там речення, адже створити речення, яке не збігається ні з чим у базі даних, це не те саме вміння, що створити речення, яке мовна модель не змогла б передбачити.
Гуманізуйте свою власну статтю
Перетворіть текст, створений за допомогою AI, і зробіть його природним, не змінюючи важливих слів або цитат.
Що насправді вимірює показник AI
Показник AI не має бази даних, з якою можна було б його звірити. Класифікатор читає поданий текст і оцінює, на основі закономірностей, які він засвоїв із прикладів людського письма та письма, згенерованого AI, наскільки ймовірно, що цей текст походить від моделі, а не від людини. У цій оцінці немає нічого, що залежало б від того, чи з'являлося коли-небудь точне речення десь раніше. Речення може бути цілком унікальним, його міг не набирати ніхто до цієї подачі, і все ж воно може статистично виглядати типовим для результату AI, якщо вибір слів і ритм відповідають шаблону, який зазвичай продукує мовна модель.
Це та сама статистична сфера, яку повністю охоплює ширший виклад того, як насправді працюють AI detectors: передбачуваність на рівні слів і ритм на рівні речень, зведені в один показник документа. Версія цього класифікатора в Turnitin є власницькою, але базова передумова, що згенерований текст зазвичай статистично типовіший за людське письмо, є тією самою, що лежить в основі кожного інструмента в цій категорії.
| Оцінка подібності | Оцінка AI | |
|---|---|---|
| Що вона вимірює | Яка частина тексту подання збігається з іншими проіндексованими документами | Наскільки близько проза нагадує статистично типовий текст, згенерований AI |
| Що спричиняє високе значення | Довгі цитати, поширені для цієї галузі формулювання, повторно використаний матеріал або збіг із попереднім поданням | Однорідний ритм речень і послідовно передбачуваний вибір слів у всьому документі |
| Що високе значення не доводить | Що зіставлений текст було використано неналежним чином. Правильно процитований матеріал усе одно може бути зафіксований як збіг. | Що будь-яке окреме речення було згенероване AI. Класифікатор читає загальний шаблон документа, а не один рядок ізольовано. |
Чи може стаття мати 0 Percent подібності та 90 Percent оцінки AI?
Так, і така комбінація не є збоєм. Дві оцінки відповідають на різні запитання, тому можливі всі чотири комбінації високих і низьких значень, і кожна з них означає щось інше про те, як було створено текст.
- Низька подібність, низька оцінка AI: звичайне оригінальне письмо, яке також читається з типовою людською варіативністю. Поширений випадок для більшості справжніх студентських робіт.
- Низька подібність, висока оцінка AI: оригінальні речення, не скопійовані звідкись, які читаються як статистично передбачувані так, як це властиво згенерованому тексту. Ознака не відредагованого AI-письма, з якого ніхто не перефразовував на основі наявного джерела.
- Висока подібність, низька оцінка AI: текст, що близько збігається з наявним людським джерелом, без статистичної одноманітності, яку класифікатор пов'язує з генерацією. Скопійований текст, виявлений старішим інструментом, а не новішим.
- Висока подібність, висока оцінка AI: текст, що збігається з наявним джерелом, яке саме було згенероване AI, наприклад із раніше поданою роботою, написаною AI, або зі сторінкою тексту, створеного AI, уже проіндексованою з відкритої мережі.
Жодна з цих комбінацій не потребує нічого незвичного з боку програмного забезпечення. Вони випливають із того, що одна система перевіряє на збіг, а інша перевіряє на шаблон, і фрагмент тексту може мати будь-яку з цих властивостей, обидві або жодної.
Що доводить, і чого не доводить високий AI Score
Високий AI Score є статистичною оцінкою, а не зізнанням, витягнутим із тексту. Він означає, що проза перед класифікатором за своїм добором слів і ритмом нагадує той тип письма, який модель навчали пов'язувати з AI generation. Він не ідентифікує конкретне речення як безумовно створене машиною і не знає нічого про те, як документ було фактично створено, лише про те, як він читається після завершення. TextPulse займає таку саму позицію щодо власних чисел, те, що він повідомляє, це оцінений Human Score, обчислений із тексту перед ним, а не вердикт про те, який інструмент, якщо такий був, торкнувся документа.
Практична реакція на будь-яке з цих чисел, низький similarity score або високий AI score, однакова, сприймати його як підставу придивитися уважніше, а не як висновок, який слід прийняти або відкинути з першого погляду. Чернетки, нотатки та історія версій свідчать про те, як документ було фактично написано, так, як жоден відсоток не може цього зробити, в жодному звіті. Кожен, кому цікаво, на що саме реагує класифікатор у його власній чернетці, може побачити той самий шаблон на рівні слів самостійно за допомогою free perplexity checker, задовго до того, як буде згенеровано будь-який звіт.
Колекція free tools collection від TextPulse охоплює інші статистичні шари, які варто перевірити, перш ніж чернетка потрапить до викладача, а не лише ті два, що порівнюються тут.
Після того як два числа розділено, наступне питання полягає в тому, що вважається добрим Turnitin score. Для іншого детектора, з яким студенти стикаються найчастіше, how GPTZero works розглянуто на окремій сторінці.
Два числа й надалі стоятимуть поруч в одному й тому самому звіті, і люди, які поспішають, й надалі сприйматимуть їх як одне число. Розуміння того, на яке саме запитання відповідає кожне з них, перетворює заплутану пару відсотків на два окремі, корисні фрагменти інформації.
Часті запитання
Turnitin similarity vs AI score зводиться до того, що перевіряє кожен із них. Показник схожості повідомляє, яка частина подання збігається з текстом, уже наявним у базі даних Turnitin, що охоплює вебсторінки, публікації та попередні студентські роботи. AI score є окремим, незалежним виміром, який оцінює, наскільки проза читається як згенерована машиною, без будь-якого звернення до бази даних. Власна документація Turnitin прямо зазначає, що ці два показники не впливають один на одного.
PhD in natural language processing, with years spent building NLP applications end to end. Moe works on text analysis: lexical and syntactic structure, and what separates machine-generated prose from human prose statistically. He has been experimenting with computational linguistics since the early days of NLTK, spaCy and WordNet, and still writes most of his tooling in Python.



