Wie GPTZero funktioniert
GPTZero machte Perplexität und Burstiness berühmt und stellte dann beide stillschweigend ein. Hier wird erläutert, was sein Klassifikator jetzt misst, was ein Bericht tatsächlich zeigt und wo das Tool seine eigenen Grenzen angibt.

Geben Sie „how gptzero works“ in eine Suchleiste ein, und die meisten Ergebnisse, die zurückkommen, beschreiben weiterhin die Perplexity und die Burstiness, die beiden Kennzahlen, die der eigene Gründer von GPTZero in den ersten Wochen nach der Veröffentlichung von ChatGPT berühmt gemacht hat. Diese Beschreibung war im Januar 2023 zutreffend. Seit Herbst desselben Jahres ist sie nicht mehr zutreffend, als die eigene Dokumentation von GPTZero angibt, dass das Unternehmen diese Methode durch etwas völlig anderes ersetzt hat. Die Lücke zwischen dem, was das Tool bei der Markteinführung tat, und dem, was es heute tut, ist so groß, dass die meisten Erklärungen, die heute noch im Umlauf sind, ein Produkt beschreiben, das es nicht mehr gibt.
Heute führt GPTZero eine Satz-für-Satz-Klassifizierung über einen großen gemischten Korpus aus von Menschen generierten und von KI generierten Texten durch, statt eine Perplexity-Berechnung vorzunehmen. GPTZero liefert auch heute noch eine einzige Schlagzeilen-Zahl, aber die Rechnung ist eine andere. Die Hervorhebung auf Satzebene unterhalb der Schlagzeilen-Zahl hat ebenfalls eine andere Bedeutung als im Jahr 2023. Beide Versionen der Geschichte sind es wert, zu kennen, diejenige, die die Begriffe berühmt machte, und diejenige, die tatsächlich heute läuft.
Die Geschichte: Wie Perplexity und Burstiness GPTZero berühmt machten
Am 2. Januar 2023 veröffentlichte der damalige Princeton-Student Edward Tian eine öffentliche Demo von GPTZero, nur wenige Wochen nachdem ChatGPT erschienen war. Seine ursprüngliche Erklärseite beschreibt, wie er zwei aus dem Sprachmodellieren entlehnte Kennzahlen verwendet hat, um zu erkennen, wann ein Sprachmodell etwas geschrieben hat. Perplexity ist ein Wert dafür, wie überrascht ein Referenzmodell von den Wortwahlen im Text war. Burstiness ist der Name von GPTZero dafür, wie stark diese Überraschung über ein Dokument hinweg schwankte. Diese Erklärseiten sind der Grund, warum beide Wörter überhaupt in die alltägliche Konversation über KI-Texte eingegangen sind. Die meisten Menschen, die Perplexity oder Burstiness heute definieren können, haben die Begriffe von GPTZero gelernt, nicht aus einem Lehrbuch.
Das zugrunde liegende Verfahren selbst ließ sich unkompliziert beschreiben. Man führt einen Abschnitt durch ein Referenz-Sprachmodell, und eine Prosa, die das Modell als hochvorhersagbar, geringe Perplexity, einstuft, liest sich als maschinentypisch, da die Generierung dazu neigt, das wahrscheinlichste nächste Wort dem überraschenden vorzuziehen. Die eigene, inzwischen zurückgezogene Dokumentation von GPTZero veröffentlichte sogar eine Faustregel: Ein Perplexity-Wert über 85 galt als wahrscheinlicher menschlich als maschinell. Diese Schwelle stammte von einem Anbieter, für ein Modell, zu einem bestimmten Zeitpunkt, und GPTZero selbst steht nicht mehr hinter ihr.
Wie GPTZero jetzt funktioniert: Ein Satzebenen-Klassifikator
Der Support-Bereich von GPTZero stellt es unmissverständlich dar: „Stand Herbst 2023 verwendet GPTZero keine Perplexity und Burstiness mehr für seine KI-Erkennung, weil wir auf eine Deep-Learning-basierte Architektur migriert haben.“ Seine aktuelle Technologieseite bestätigt, dass der Wechsel vollständig ist. Sie beschreibt „einen End-to-End-Deep-Learning-Ansatz, trainiert auf Textdatensätzen aus dem Web, aus dem Bildungsbereich und aus KI-generierten Inhalten aus einer Reihe von LLMs“, in dem „ein Satz-für-Satz-Klassifikationsmodell die Wahrscheinlichkeit und das Konfidenzniveau bestimmt, dass ein Text von KI erstellt wurde“. Perplexity und Burstiness tauchen auf dieser Seite nirgends auf.
Seitdem wurde außerdem eine zusätzliche Schutzschicht hinzugefügt, ein Paraphraser Shield, das dafür gebaut ist, KI-Text abzufangen, der durch ein Umformungswerkzeug gelaufen ist, um der Erkennung zu entgehen. Sie können Text einfügen, Word-Dokumente, PDFs und Bilddateien hochladen, und zwar bis zu fünfzig Dateien auf einmal. Keine dieser Infrastrukturkomponenten hat etwas damit zu tun, wie oft ein Referenzmodell dasselbe Wort erraten hätte.
Was ein GPTZero-Bericht tatsächlich zeigt
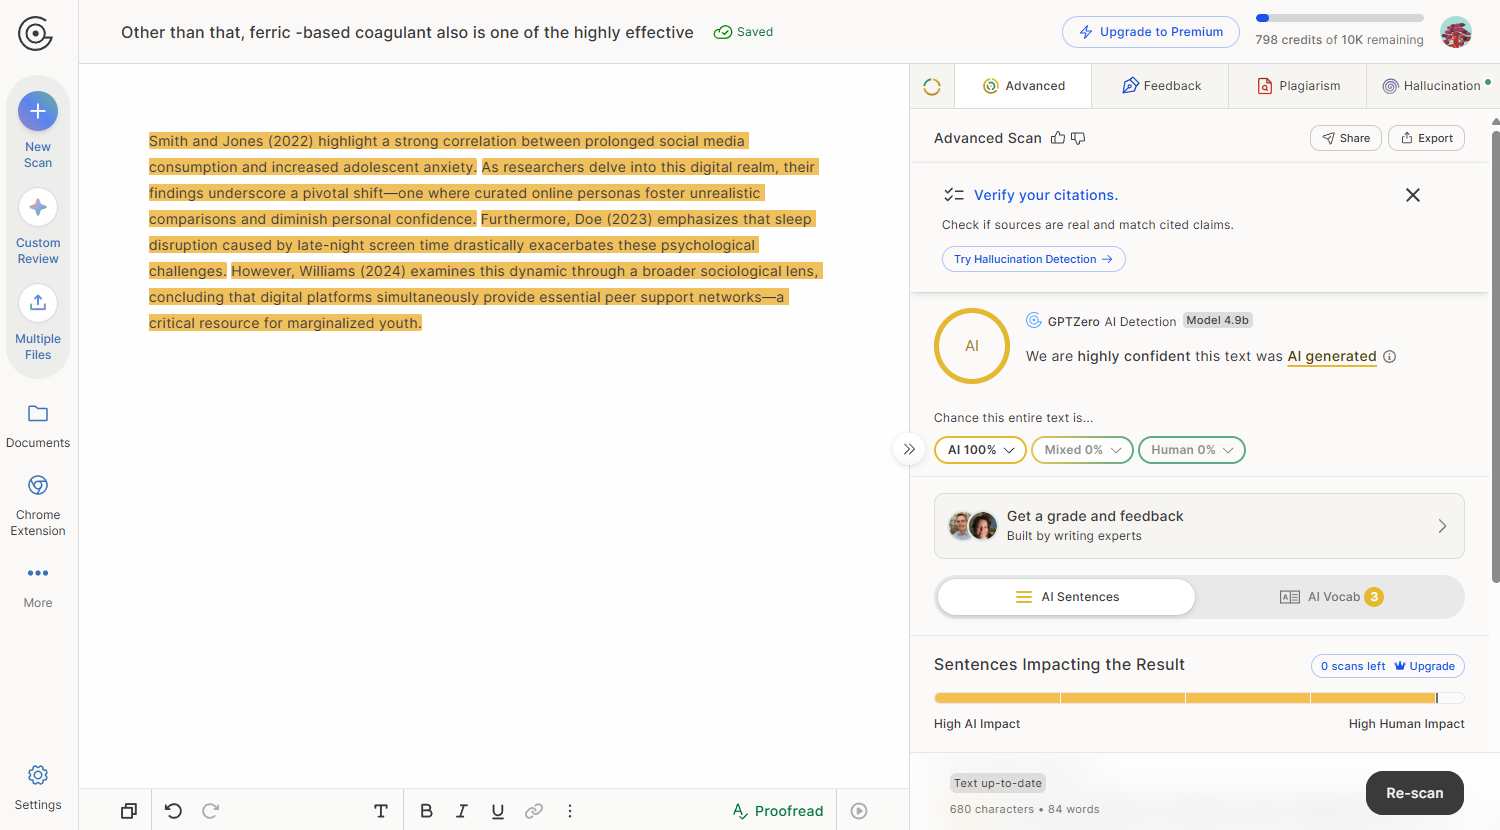
Ein GPTZero-Ergebnis umfasst drei Teile: eine Klassifikation von KI, menschlich oder gemischt, einen Prozentsatz, der die Wahrscheinlichkeit ausdrückt, dass das Dokument von KI verfasst wurde, sowie eine Konfidenzbezeichnung, die beschreibt, wie zuverlässig diese konkrete Vorhersage ist. Die Bezeichnung ist wichtiger, als es zunächst scheint. GPTZero ordnet „hochgradig zuverlässig“ einer Fehlerquote unter 2 Prozent zu und „geringe Zuversicht“ einer Fehlerquote von 14 Prozent oder höher, einem ausreichend breiten Bereich, sodass derselbe Überschriftenprozentsatz von einem Bericht zum nächsten sehr unterschiedlich gewichtet sein kann.
Bezahlte Scans fügen eine Hervorhebung auf Satzebene hinzu, und es lohnt sich, das korrekt zu lesen. GPTZero beschreibt die hervorgehobenen Sätze als diejenigen, die den Gesamtscore überproportional beeinflussen, nicht als eine Liste von Vorwürfen gegen einzelne Zeilen. Ein Satz kann unmarkiert bleiben und dennoch das Ergebnis geprägt haben, weil der Klassifikator das Dokument als Ganzes liest, statt Satz für Satz abzustimmen.
| Berichtelement | Was es Ihnen sagt |
|---|---|
| Klassifikation | Eine einzelne Bezeichnung: KI, menschlich oder gemischt |
| KI-Wahrscheinlichkeitswert | Ein Prozentsatz, der widerspiegelt, wie wahrscheinlich das Modell das Dokument als von KI verfasst beurteilt |
| Konfidenzbezeichnung | Reicht von hochgradig zuverlässig, unter einer 2-Prozent-Fehlerquote, bis zu geringer Zuversicht, 14 Prozent oder höher |
| Satzhervorhebung | Markiert Sätze, die am stärksten zum Score auf Advanced Scan beitragen, nicht jeden Satz, der damit in Verbindung steht |
Keines dieser Berichtelemente existierte in seiner aktuellen Form, als der perplexity-und-burstiness-Erklärtext noch die öffentliche Selbstdarstellung von GPTZero war. Die Benutzeroberfläche änderte sich zusammen mit der Methode.
Ihre eigene Arbeit humanisieren
Verwandeln Sie Ihren KI-gestützten Text und lassen Sie ihn menschlich klingen, ohne wichtige Wörter oder Zitate anzutasten.
Warum die Beschreibung zu Perplexity und Burstiness weiterhin im Umlauf ist
Die ursprüngliche Erklärung von GPTZero ist weiterhin online, weiterhin indexiert und weiterhin eine der klareren allgemeinen Beschreibungen dafür, wie Perplexity und Burstiness als Konzepte funktionieren. Suchmaschinen und andere Seiten zitieren sie weiterhin, und einige verweisen auf eine weit verbreitete Überprüfung aus dem Jahr 2026, in der behauptet wird, das Tool führe weiterhin eine Perplexity- und Burstiness-Schicht still neben seinem Klassifikator aus. Die aktuellen Seiten von GPTZero selbst, die Technologieseite und beide Support-Artikel sagen das Gegenteil: Die Begriffe wurden zurückgezogen, nicht lediglich im Hintergrund verborgen. Eine Seite, die ein Konzept im Allgemeinen beschreibt, ist nicht dasselbe wie eine Seite, die die gegenwärtige Vorgehensweise dieses Tools beschreibt, und die Behandlung beider als austauschbar ist wohl der Hauptgrund dafür, dass die Verwirrung drei Jahre nach dem Ablaufdatum fortbesteht.
Das ist auch jenseits von Kuriositäten relevant. Eine Studentin oder ein Kollege, dem geraten wird, die Perplexity zu senken oder die Satzlänge gezielt zu strecken, um GPTZero zu umgehen, erhält Ratschläge, die auf eine Version des Produkts abzielen, die 2023 die Ausführung eingestellt hat. Was einen Satzklassifikator in Bewegung setzt, ist eine verwandte, aber andere Frage, näher an der umfassenderen Darstellung von wie KI-Detektoren tatsächlich funktionieren, als an irgendeine der beiden Statistiken für sich. GPTZero hat sie nicht eingestellt, nach eigener Darstellung befinden sie sich unter sieben Indikatoren, die das aktuelle Modell speisen, aber sie waren nicht mehr das, was darüber entscheidet, welche Antwort gegeben wird.
Was GPTZero sagt, dass es nicht tun kann
Die veröffentlichten Benchmarks von GPTZero sind etwa so stark, wie ein Anbieter voraussichtlich über sein eigenes Produkt veröffentlichen wird. Das Unternehmen berichtet von „einer Genauigkeitsrate von 99% beim Erkennen von KI-generiertem Text im Vergleich zu menschlichem Schreiben“, sagt „wir halten die Rate der falsch positiven Ergebnisse von GPTZero bei höchstens 1%, wenn wir KI im Vergleich zu menschlichem Text bewerten“, und verzeichnet „eine Genauigkeitsrate von 96,5%“ bei Einreichungen, die KI und menschliches Schreiben mischen, neben 1,1 Prozent bei TOEFL-Aufsätzen, einer gängigen Stellvertretung für nicht-muttersprachliches Englisch. Diese Zahlen stammen aus der eigenen Bewertung von GPTZero, die im Januar 2025 veröffentlicht wurde, ohne dass auf der Seite, auf der sie berichtet werden, eine unabhängige Replikation angeführt wird. Auf derselben Seite wird die Behauptung, auf die die meisten Anbieter zurückgreifen, zwar auch abgeschwächt, indem sie feststellt, dass „es niemals eine 100%ige Garantie geben wird“ und dass jeder, der etwas anderes behauptet, wahrscheinlich einen Fehler in seinen Daten oder in seiner Bewertungsmethode hat.
Die eigene Seite zu den Grenzen von GPTZero ist konkreter als die Marketingzahlen. Das Unternehmen erklärt, dass die Genauigkeit steigt, wenn mehr Text eingereicht wird, und auf Satz- und Absatzebene im Vergleich zum vollständigen Dokument abfällt. Es gibt an, dass seine Trainingsdaten überwiegend erwachsene englische Prosa sind, sodass Text, der von diesem Muster abweicht, schwieriger zuverlässig zu klassifizieren ist. Es erklärt, dass der Klassifikator nicht darauf trainiert ist, KI-Text zu erkennen, der nach der Generierung stark modifiziert wurde. Und es stellt unmissverständlich fest, dass auch anderes maschinell generiertes oder stark prozedurales Schreiben, nicht nur die Ausgabe eines Chatbots, auf die gleiche Weise markiert werden kann.
Das ist kein Grund, die Zahl von GPTZero als jenseits jeder Frage zu behandeln, und es ist nicht der einzige Detektor, der es wert ist, in eigenen Begriffen verstanden zu werden. Wer wissen möchte, worauf ein Klassifikator wie dieser tatsächlich reagiert, kann sich mit einem kostenlosen Perplexity-Checker oder einem kostenlosen Burstiness-Checker eine Version dieses Musters selbst ansehen, zwei Bestandteile einer umfassenderen Sammlung kostenloser Tools, die die anderen statistischen Ebenen abdeckt, auf die ein Bericht wie dieser zurückgreift.
GPTZero's zwei Leithinweis-Statistiken haben eigene Seiten: was perplexity in der KI-Erkennung misst, und die Token-Wahrscheinlichkeitsarithmetik, die beide Zahlen hervorbringt.
Ein Tool, das seine eigenen blinden Flecken so präzise zu benennen bereit ist, verdient mehr Vertrauen als eines, das behauptet, dass es keine gibt, und die nächste unerklärte Prozentangabe in einem Bericht ist ein guter Ausgangspunkt, um zu fragen, welche Art von Tool sie hervorgebracht hat.
Was unsere eigene Forschung zeigt
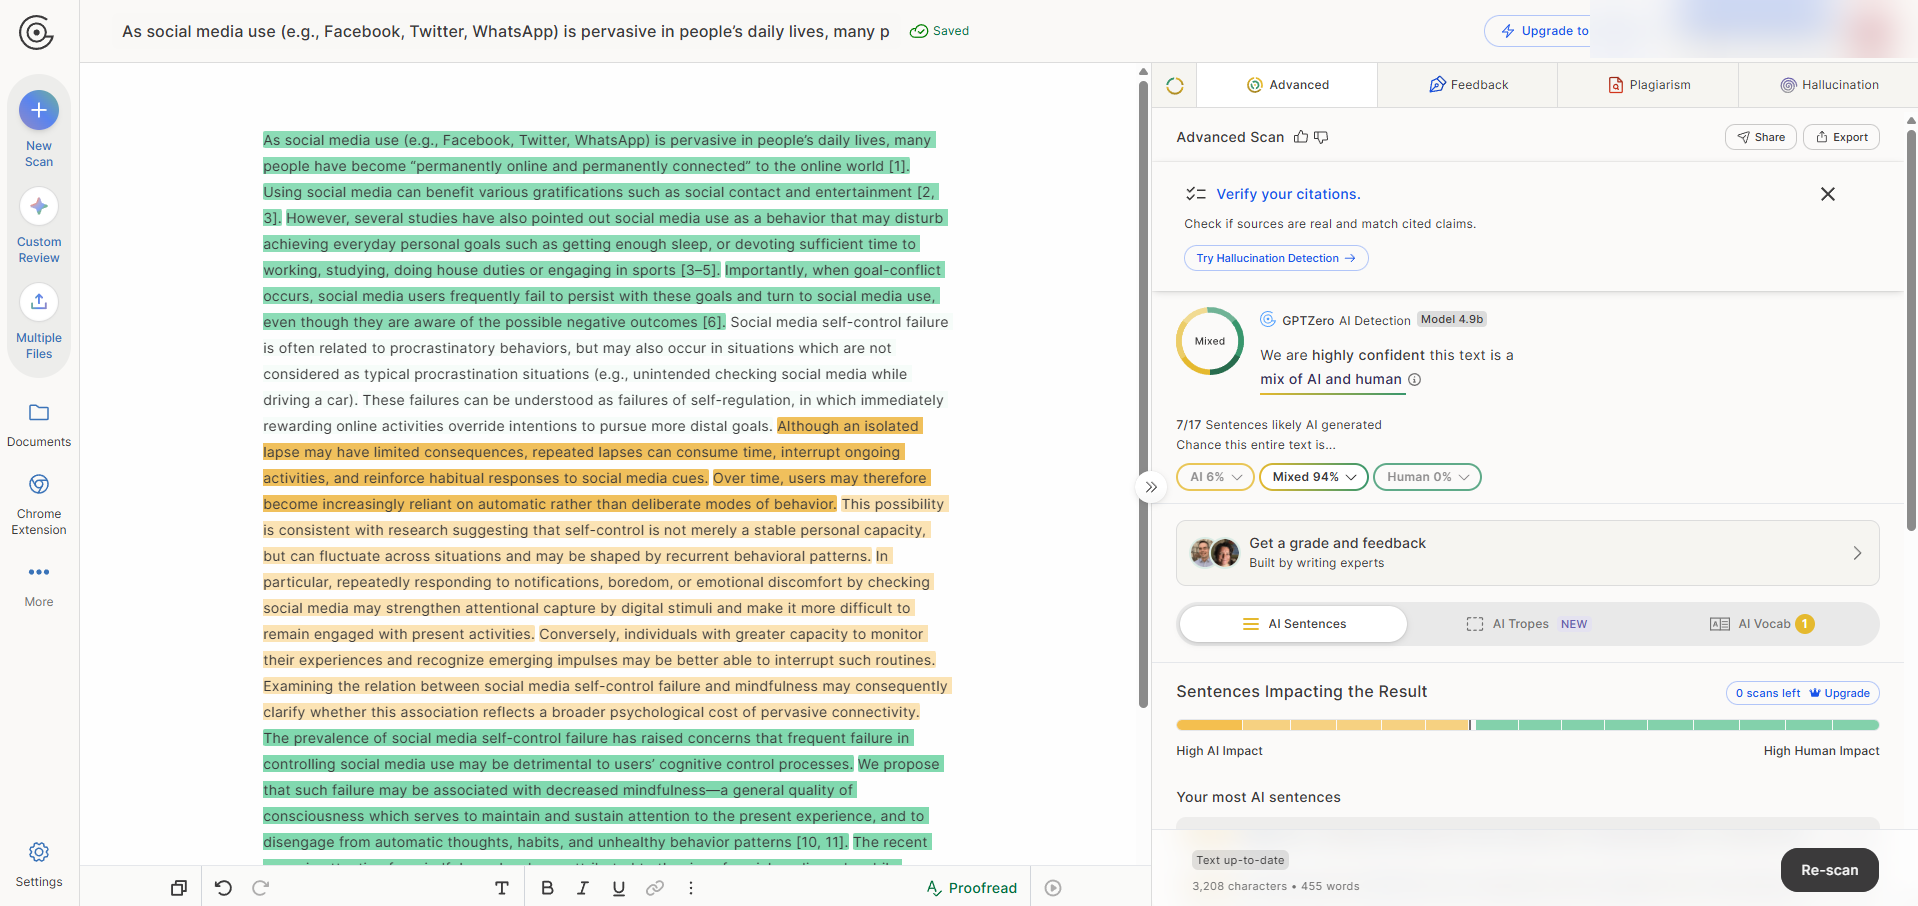
In der Detektor-Übereinstimmungsstudie von TextPulse Research bewerteten neun kommerzielle KI-Detektoren dieselben 90 akademischen Texte. Einer davon war ein Hybridtext mit 455 Wörtern: ein von Menschen geschriebener Anfang und Schluss um einen KI-generierten Mittelteil von 168 Wörtern. GPTZero bewertete diesen Text mit 41.2% KI, während die Urteile der anderen Tools zu denselben Wörtern von 0% bis 95.7% KI reichten. Das vollständige Paper, das Korpus und die Score-Matrix aller Tools sind frei zugänglich unter TextPulse Research.
Häufig gestellte Fragen
Nein. Das Support-Center von GPTZero erklärt, dass das Unternehmen Perplexität und Burstiness seit Herbst 2023 nicht mehr zur Erkennung verwendet, nachdem es auf einen Deep-Learning-Klassifikator umgestellt hatte. Die aktuelle Technologieseite beschreibt ein Satz-für-Satz-Klassifikationsmodell und erwähnt keinen der beiden Begriffe. Die Beschreibung zirkuliert weiterhin, weil der eigene Erklärtext von GPTZero aus dem Jahr 2023 beide Begriffe populär machte, bevor sich die Methode änderte.
PhD in natural language processing, with years spent building NLP applications end to end. Moe works on text analysis: lexical and syntactic structure, and what separates machine-generated prose from human prose statistically. He has been experimenting with computational linguistics since the early days of NLTK, spaCy and WordNet, and still writes most of his tooling in Python.



