Turnitin Ähnlichkeitswert vs. KI-Wert: Zwei verschiedene Berichte
Ein Ähnlichkeitswert und ein KI-Wert beantworten unterschiedliche Fragen, daher kann eine Arbeit bei dem einen niedrig und bei dem anderen hoch liegen, ohne dass eine der beiden Zahlen falsch ist. Was jeweils gemessen wird, was es auslöst und was ein hoher Wert beweist und nicht beweist.

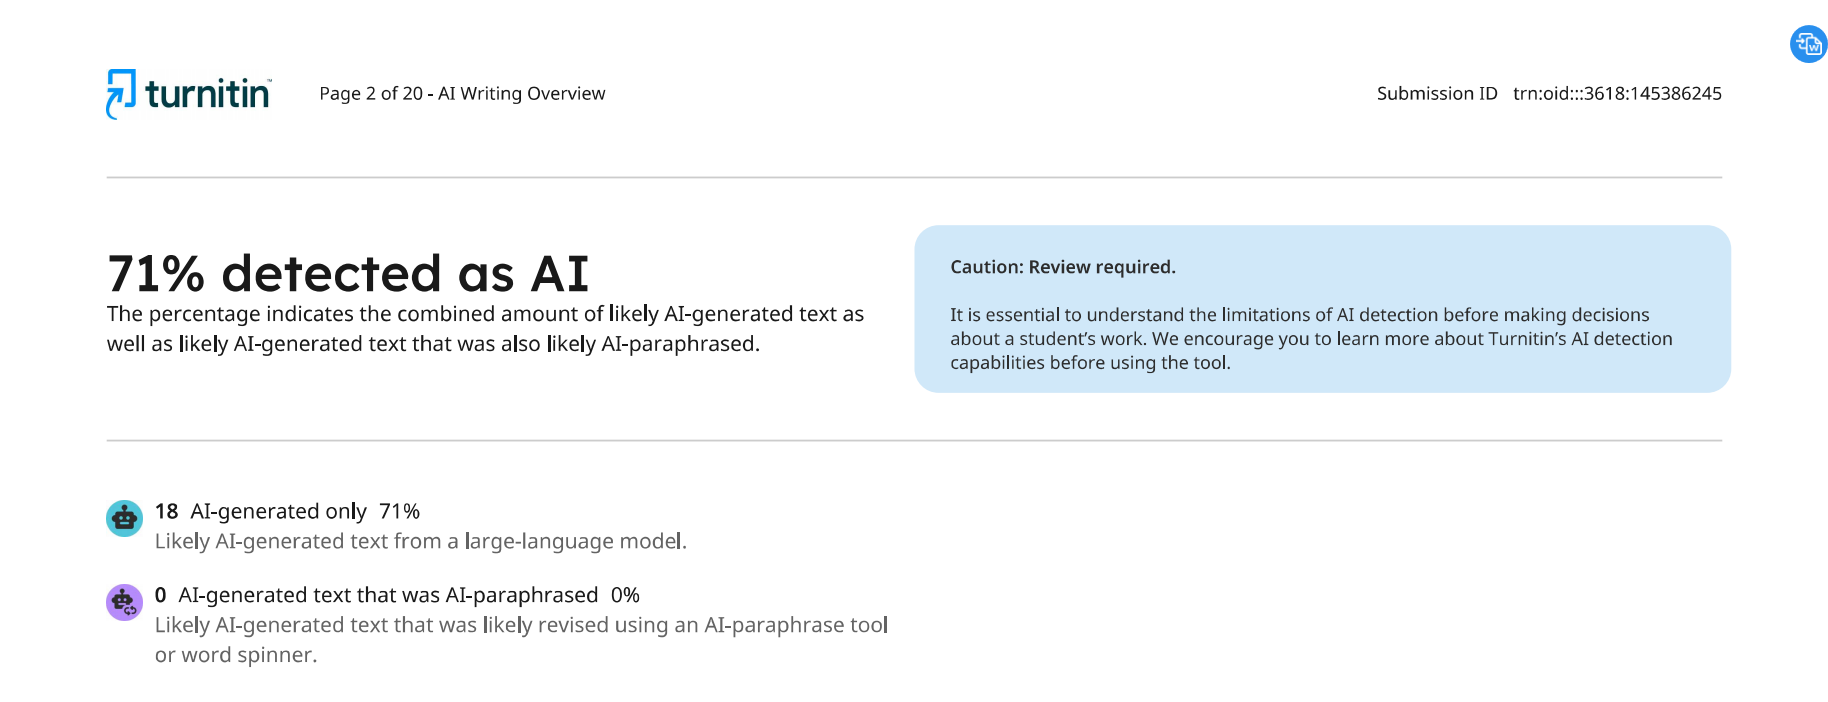
Ein Bericht enthält zwei Zahlen: einen Ähnlichkeitsscore von 3 Prozent und einen KI-Score von 88 Prozent. Naheliegend ist, dass sie dasselbe messen müssen, sodass die niedrige Zahl bedeuten sollte, dass auch die hohe Zahl wahrscheinlich falsch ist. So funktioniert es nicht. Turnitin similarity vs AI score ist ein Vergleich zwischen zwei getrennten Systemen, die zwei getrennte Dinge prüfen, und eine Einreichung kann bei dem einen niedrig und bei dem anderen hoch ausfallen, ohne dass eine der beiden Zahlen ein Fehler ist.
Es ist älter als das KI-System und wurde entwickelt, um Text zu erkennen, der mit etwas bereits Vorhandenem übereinstimmt. Es ist neuer, wurde als eigene unabhängige Messung in denselben Similarity Report aufgenommen und dient dazu zu schätzen, ob Prosa wie maschinell erzeugt wirkt, unabhängig davon, ob sie mit irgendetwas übereinstimmt. Laut Turnitins eigener Dokumentation sind sie vollständig unabhängig und beeinflussen einander nicht. Alles Weitere in diesem Beitrag.

Turnitin Similarity vs AI Score: Was jede Zahl berichtet
Turnitin behandelt die beiden als unterschiedliche Messgrößen, die in einem Produkt gebündelt sind, und nicht als zwei Ansichten eines Ergebnisses. Der Similarity Report vergleicht eine Einreichung mit einer Datenbank aus Webinhalten, wissenschaftlichen Publikationen und zuvor eingereichten studentischen Arbeiten und gibt den Prozentsatz des Textes der Einreichung zurück, der mit etwas übereinstimmt, das bereits in dieser Datenbank vorhanden ist. Die Erkennung von KI-Schreiben läuft auf einem völlig anderen Modell, das in denselben Bericht als eigener unabhängiger Score integriert ist, ein Modell, das darauf trainiert wurde zu beurteilen, wie stark die Prosa einer Passage maschinell erzeugtem Schreiben ähnelt, ganz ohne Bezug auf eine externe Datenbank. Die genaueren Mechanismen, wie Turnitin's KI-Klassifikator zu dieser Zahl gelangt, werden gesondert behandelt, entscheidend ist hier, dass er eine andere Frage beantwortet als die Similarity-Engine, die im selben Bericht enthalten ist.
Was der Similarity Score tatsächlich misst
Similarity ist eine Übung im Abgleich, kein Urteil. Turnitin's eigene Anleitung stellt ausdrücklich klar, dass das Tool nicht auf Plagiat prüft. Es prüft auf Überschneidungen und überlässt die Interpretation der Lehrperson, die den Bericht liest. Ein korrekt abgesetztes Zitat, eine Formulierung aus dem Methodenteil, die in einem ganzen Teilgebiet geteilt wird, ein Literaturverzeichnis, das so formatiert ist, wie jedes Paper in der Zeitschrift sein Literaturverzeichnis formatiert, all dies kann als Übereinstimmung erscheinen, weil das System überlappende Zeichenfolgen von Text zählt, statt zu beurteilen, ob die Überschneidung legitim ist.
Das ist auch der Grund, warum ein Ähnlichkeitswert von null weniger beweist, als es scheint. Er bedeutet, dass die Einreichung keine lange, zusammenhängende Textpassage enthält, die an anderer Stelle in Turnitins indizierten Quellen gefunden wurde. Er sagt nichts darüber aus, wie die vorhandenen Sätze erzeugt wurden, denn einen Satz zu erzeugen, der mit nichts in einer Datenbank übereinstimmt, ist nicht dieselbe Fähigkeit wie einen Satz zu erzeugen, den ein Sprachmodell nicht vorhergesagt hätte.
Ihre eigene Arbeit humanisieren
Verwandeln Sie Ihren KI-gestützten Text und lassen Sie ihn menschlich klingen, ohne wichtige Wörter oder Zitate anzutasten.
Was der AI Score tatsächlich misst
Der AI Score hat keine Datenbank, mit der er abgeglichen wird. Ein Klassifikator liest den eingereichten Text und schätzt anhand von Mustern, die er aus Beispielen menschlichen und von AI erzeugten Schreibens gelernt hat, wie wahrscheinlich es ist, dass dieser Text eher von einem Modell als von einer Person stammt. An dieser Schätzung hängt nichts davon ab, ob der genaue Satz jemals irgendwo zuvor erschienen ist. Ein Satz kann völlig einzigartig sein, von niemandem bis zu dieser Einreichung je getippt worden sein, und dennoch statistisch typisch für AI-Ausgaben wirken, wenn seine Wortwahl und sein Rhythmus dem Muster folgen, das ein Sprachmodell gewöhnlich erzeugt.
Dies ist dasselbe statistische Gebiet, das im umfassenderen Überblick über wie AI-Detektoren tatsächlich funktionieren vollständig behandelt wird: Vorhersagbarkeit auf Wortebene und Rhythmus auf Satzebene, zusammengeführt in einem Dokumentwert. Turnitins Version dieses Klassifikators ist proprietär, aber die zugrunde liegende Prämisse, dass erzeugter Text statistisch typischer zu sein pflegt als menschliches Schreiben, ist dieselbe, die jedem Werkzeug in dieser Kategorie zugrunde liegt.
| Ähnlichkeitswert | AI-Wert | |
|---|---|---|
| Was er misst | Wie viel des Textes der Einreichung mit anderen indexierten Dokumenten übereinstimmt | Wie stark die Prosa statistisch typischem AI-generiertem Schreiben ähnelt |
| Was einen hohen Wert auslöst | Lange Zitate, gängige fachspezifische Formulierungen, wiederverwendetes Material oder eine Übereinstimmung mit einer früheren Einreichung | Einheitlicher Satzrhythmus und durchgehend vorhersehbare Wortwahl im gesamten Dokument |
| Was ein hoher Wert nicht beweist | Dass der übereinstimmende Text unzulässig verwendet wurde. Korrekt zitierte Materialien können dennoch als Übereinstimmung erfasst werden. | Dass ein einzelner Satz von AI generiert wurde. Der Klassifikator liest das Gesamtmuster des Dokuments, nicht eine Zeile isoliert. |
Kann eine Arbeit 0 Prozent Ähnlichkeit und einen 90 Prozent AI-Wert haben?
Ja, und die Kombination ist kein Fehler. Die beiden Werte beantworten unterschiedliche Fragen, daher sind alle vier Kombinationen aus hoch und niedrig möglich, und jede von ihnen impliziert etwas anderes darüber, wie der Text entstanden ist.
- Niedrige Ähnlichkeit, niedriger AI-Wert: gewöhnliches originales Schreiben, das sich zugleich mit typischer menschlicher Variation liest. Der häufige Fall bei den meisten echten studentischen Arbeiten.
- Niedrige Ähnlichkeit, hoher AI-Wert: originelle Sätze, die von nirgendwo kopiert wurden, die aber statistisch vorhersehbar klingen, so wie generierter Text es tendenziell tut. Die Signatur unbearbeiteter AI-Schreibweise, von der niemand aus einer vorhandenen Quelle paraphrasiert hat.
- Hohe Ähnlichkeit, niedriger AI-Wert: Text, der eng mit einer vorhandenen, von Menschen geschriebenen Quelle übereinstimmt, ohne die statistische Gleichförmigkeit, die ein Klassifikator mit Generierung verbindet. Kopierter Text, vom älteren Werkzeug erkannt, nicht vom neueren.
- Hohe Ähnlichkeit, hoher AI-Wert: Text, der mit einer vorhandenen Quelle übereinstimmt, die selbst von AI generiert wurde, etwa eine zuvor eingereichte, von AI geschriebene Arbeit oder eine Seite mit von AI erzeugtem Text, die bereits aus dem offenen Web indexiert wurde.
Keine dieser Kombinationen erfordert auf der Softwareseite etwas Ungewöhnliches. Sie ergeben sich aus der Tatsache, dass ein System nach einer Übereinstimmung sucht und das andere nach einem Muster, und ein Textstück kann entweder eines dieser Merkmale, beide oder keines von beiden aufweisen.
Was ein hoher AI Score beweist und was nicht
Ein hoher AI Score ist eine statistische Schätzung, keine aus dem Text herausgelöste Geständnis. Er sagt, dass die vor dem Klassifikator liegende Prosa in ihrer Wortwahl und ihrem Rhythmus der Art von Schreiben ähnelt, mit der das Modell darauf trainiert wurde, AI-Generierung zu verbinden. Er identifiziert keinen bestimmten Satz als mit Sicherheit maschinell geschrieben, und er weiß nichts darüber, wie das Dokument tatsächlich erstellt wurde, sondern nur, wie es sich nach seiner Fertigstellung liest. TextPulse vertritt bei seinen eigenen Zahlen dieselbe Position: Was es berichtet, ist ein aus dem vorliegenden Text berechneter geschätzter Human Score, kein Urteil darüber, welches Werkzeug, falls überhaupt eines, das Dokument berührt hat.
Die praktische Reaktion auf beide Zahlen, einen niedrigen Similarity Score oder einen hohen AI Score, ist dieselbe: Man sollte sie als Anlass nehmen, genauer hinzusehen, nicht als Befund, den man auf den ersten Blick akzeptiert oder verwirft. Entwürfe, Notizen und Versionsverläufe belegen, wie ein Dokument tatsächlich geschrieben wurde, auf eine Weise, die ein Prozentsatz niemals kann, bei keinem der beiden Berichte. Wer wissen möchte, worauf ein Klassifikator in seinem eigenen Entwurf tatsächlich reagiert, kann dasselbe Wortmuster selbst mit einem free perplexity checker sehen, lange bevor irgendein Bericht erzeugt wird.
Die free tools collection von TextPulse deckt die anderen statistischen Ebenen ab, die vor der Abgabe eines Entwurfs an eine Lehrperson überprüft werden sollten, nicht nur die beiden hier verglichenen.
Sobald die beiden Zahlen getrennt betrachtet werden, lautet die nächste Frage was als guter Turnitin Score gilt. Für den anderen Detektor, dem Studierende am häufigsten begegnen, wird wie GPTZero funktioniert auf einer eigenen Seite behandelt.
Die beiden Zahlen werden weiterhin nebeneinander im selben Bericht stehen, und sie werden von Menschen in Eile weiterhin als eine einzige Zahl gelesen werden. Zu wissen, welche Frage jede von ihnen tatsächlich beantwortet, ist das, was ein verwirrendes Paar von Prozentangaben in zwei getrennte, nützliche Informationsstücke verwandelt.
Häufig gestellte Fragen
Turnitin Similarity vs. KI-Wert hängt davon ab, was jeweils geprüft wird. Der Ähnlichkeitswert gibt an, wie viel einer Einreichung mit Text übereinstimmt, der bereits in Turnitins Datenbank aus Webseiten, Publikationen und früheren studentischen Arbeiten enthalten ist. Der KI-Wert ist eine separate, unabhängige Messung, die schätzt, wie stark die Prosa als maschinell erzeugt wirkt, ganz ohne Bezug zu einer Datenbank. Turnitins eigene Dokumentation stellt fest, dass sich die beiden Werte nicht gegenseitig beeinflussen.
PhD in natural language processing, with years spent building NLP applications end to end. Moe works on text analysis: lexical and syntactic structure, and what separates machine-generated prose from human prose statistically. He has been experimenting with computational linguistics since the early days of NLTK, spaCy and WordNet, and still writes most of his tooling in Python.



