Qu'est-ce qu'un humaniseur IA académique ?
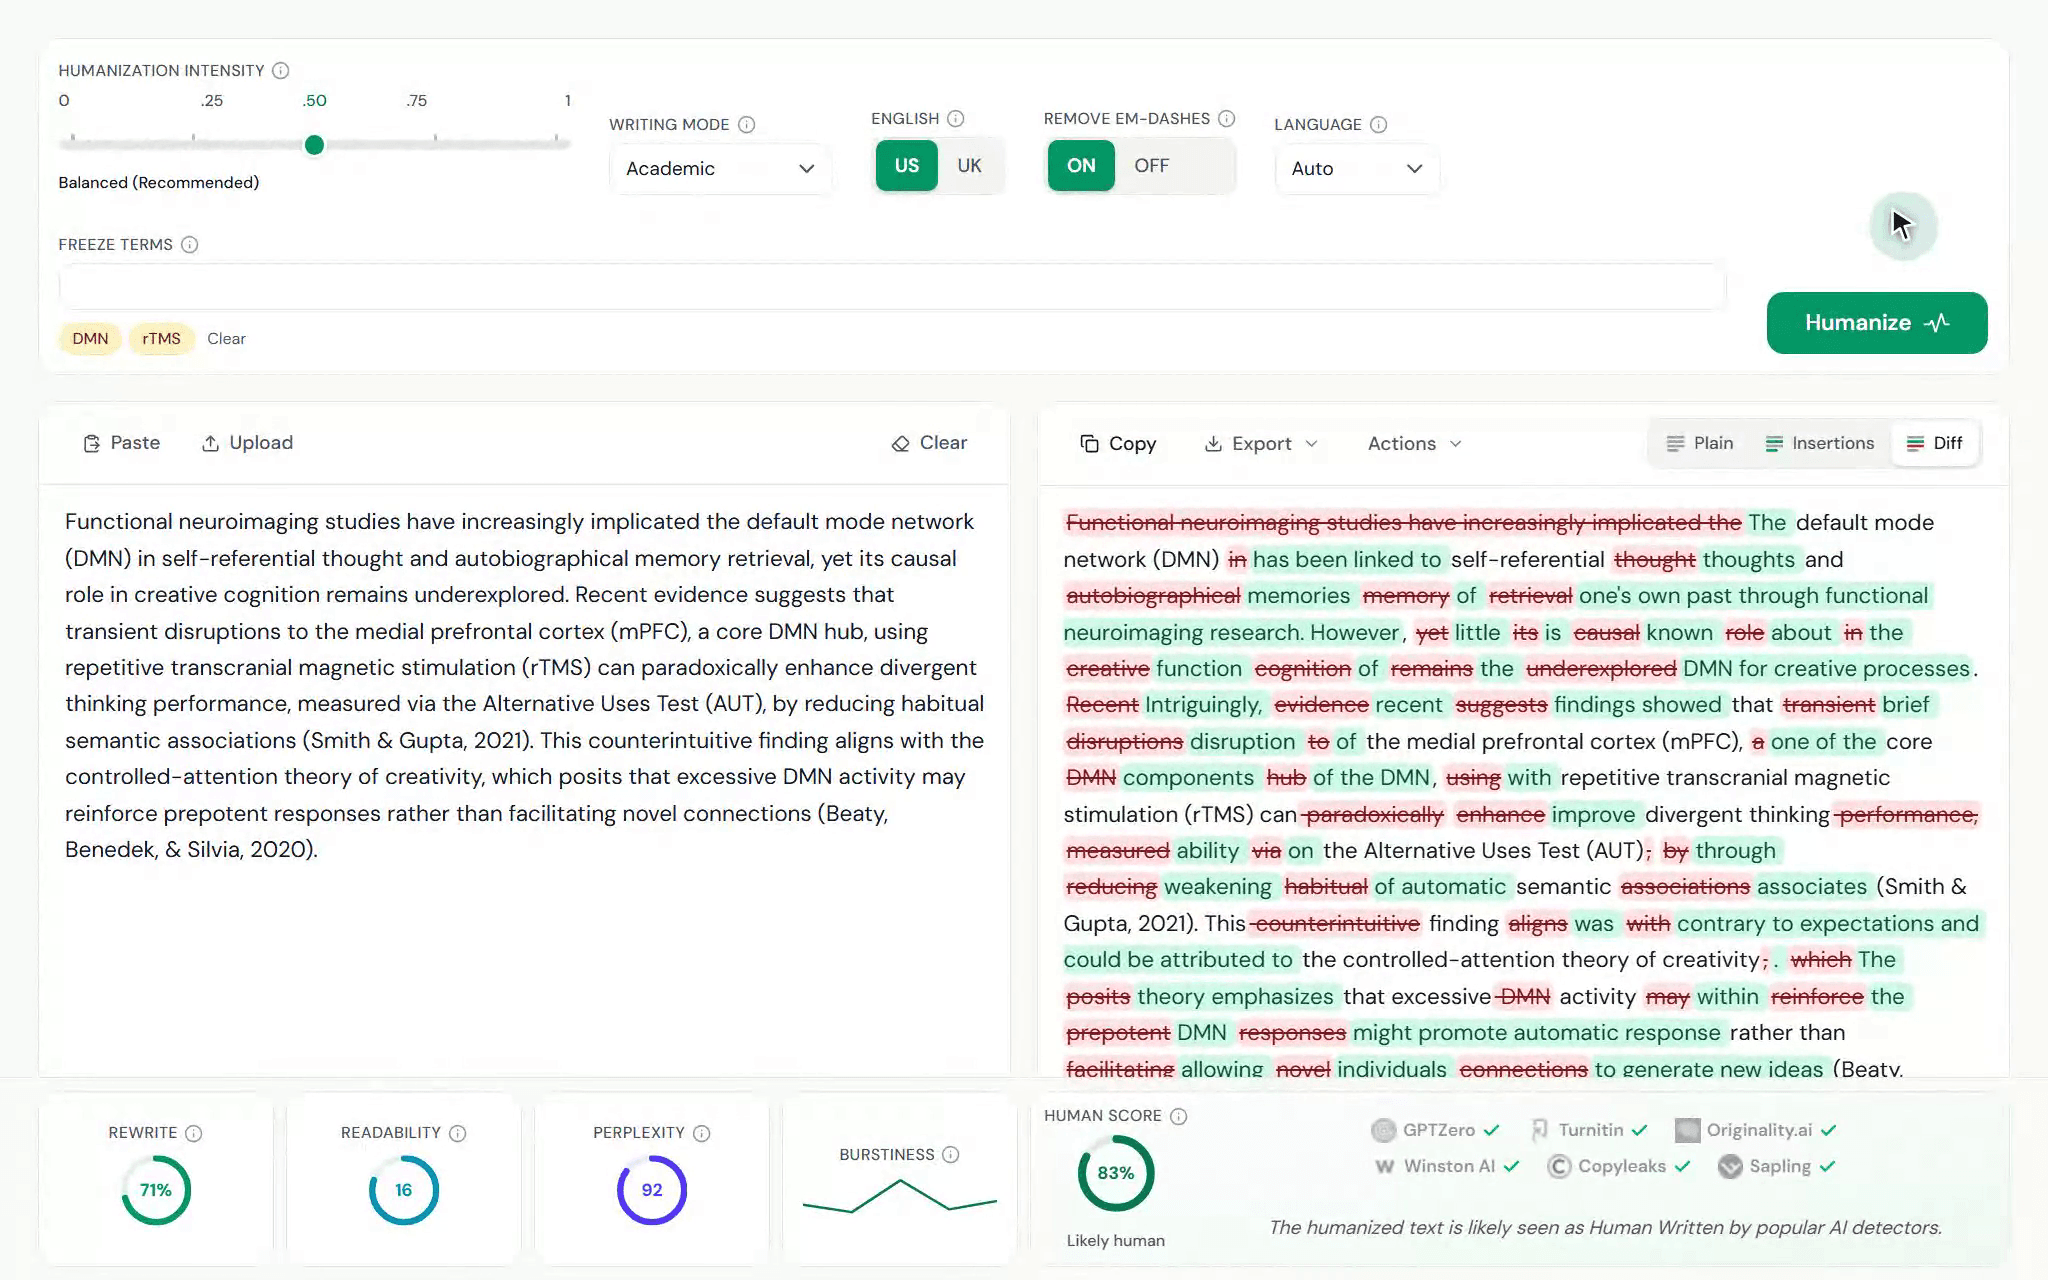
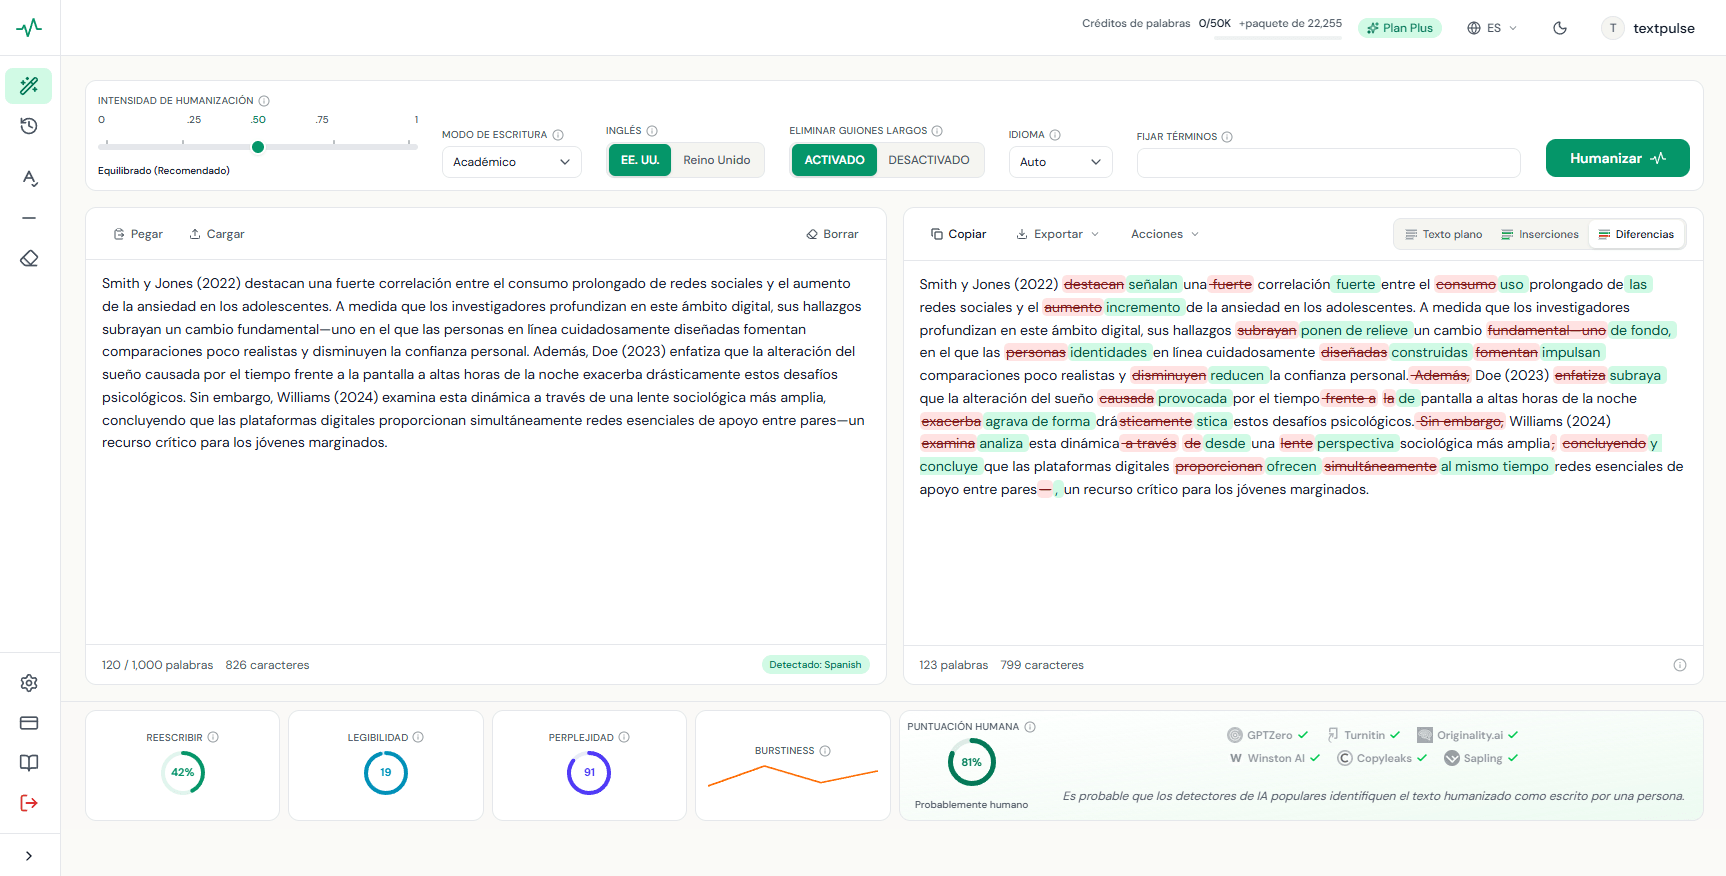
Un humaniseur IA académique est un outil de réécriture qui prend un texte académique généré par IA, un brouillon d'article de recherche, un chapitre de thèse, une revue de littérature, et le restructure pour qu'il se lise comme l'écrit un chercheur. Les détecteurs tels que Turnitin, GPTZero, Originality.ai, Copyleaks et Pangram ne lisent pas le sens, ils évaluent à quel point chaque mot est prévisible à partir des mots qui le précèdent, et la prose générée obtient un score très élevé de prévisibilité parce qu'elle a été produite par prédiction. L'humanization d'un texte IA pour un article de recherche ou une dissertation modifie ce profil statistique tandis que l'argument, les preuves et les citations restent en place.
Comment TextPulse humanise les articles de recherche, thèses et dissertations
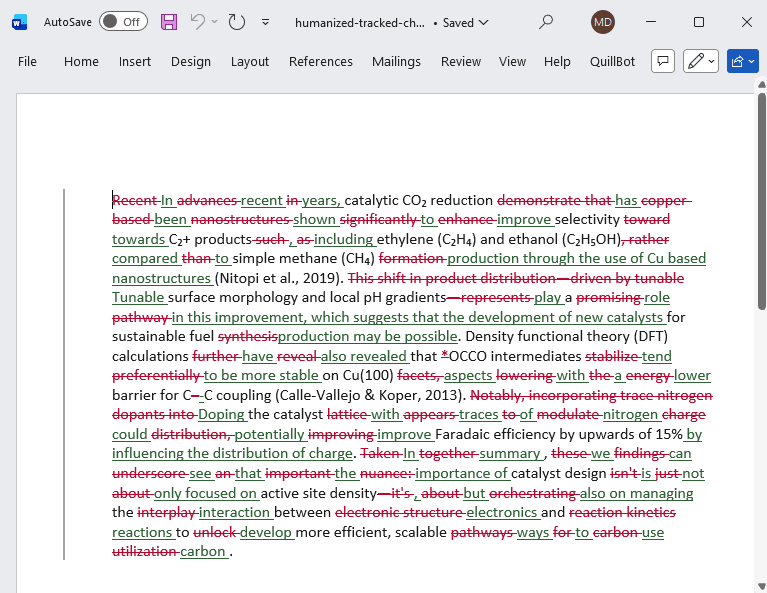
Le moteur fonctionne sur plus de 20 signaux linguistiques à la fois. Il varie la longueur et la structure des phrases, car la variance de longueur des phrases est la propriété que les détecteurs mesurent le plus directement. Il remplace le vocabulaire que les modèles de langage sur-sélectionnent, le registre de mots comme "pivotal" et "multifaceted" qui marquent la prose générée. Et il conserve le registre académique tout en faisant cela, la sortie humanisée reste dans la plage Flesch-Kincaid de 13 à 18, car le moteur a été entraîné sur des écrits humains évalués par les pairs, ainsi un chapitre de méthodologie, un manuscrit de revue ou une dissertation de PhD ne revient jamais avec un ton de billet de blog.
Ce qui distingue un humaniseur IA académique d'un humaniseur de texte général, c'est ce qu'il refuse de modifier. Les citations dans le texte et les entrées bibliographiques en APA, MLA, IEEE, Chicago, Harvard et Vancouver sont conservées mot pour mot. Les statistiques, les tailles d'effet et les formules chimiques sont conservées automatiquement. Les freeze terms verrouillent tout nom de concept ou d'instrument avant l'exécution de l'humanization, de sorte que la version qui le renomme n'est jamais générée. Les documents sont traités dans leur ensemble, ainsi la terminologie ne peut pas dériver entre les chapitres d'une thèse ou les sections d'un article de recherche.