GPTZero कैसे काम करता है
GPTZero ने perplexity और burstiness को प्रसिद्ध बनाया, फिर चुपचाप दोनों को हटा दिया। यहाँ बताया गया है कि इसका वर्गीकारक अब क्या मापता है, एक रिपोर्ट वास्तव में क्या दिखाती है, और उपकरण अपनी सीमाओं के बारे में क्या कहता है.

सर्च बार में "how gptzero works" टाइप करें, और जो कुछ भी वापस आता है, उसका अधिकांश भाग अभी भी perplexity और burstiness का वर्णन करता है, ये दो सांख्यिकीय माप जिनको इसके अपने संस्थापक ने ChatGPT के जारी होने के बाद के पहले हफ्तों में प्रसिद्ध बनाया था। यह विवरण जनवरी 2023 में सही था। उसके बाद, शरद 2023 से यह सही नहीं रहा, जब GPTZero के अपने दस्तावेज़ीकरण में कहा गया कि कंपनी ने उस विधि को किसी बिल्कुल अलग चीज़ से बदल दिया। लॉन्च के समय उपकरण जो करता था और अब जो करता है, उनके बीच का अंतर इतना बड़ा है कि आज भी प्रचलित अधिकांश व्याख्याएँ ऐसे उत्पाद का वर्णन करती हैं जो अब अस्तित्व में नहीं है।
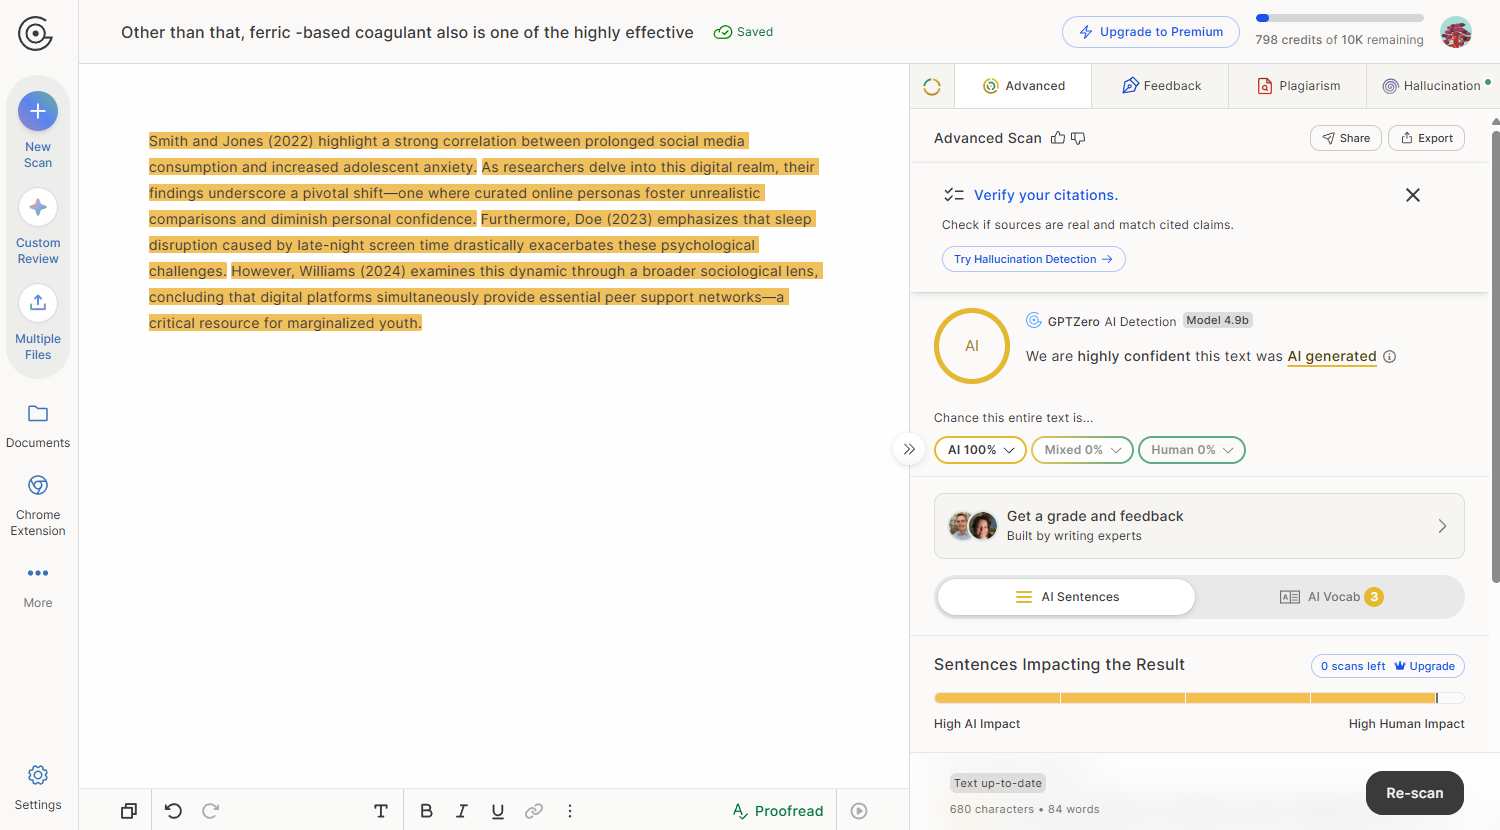
आज, GPTZero perplexity गणना के बजाय मानव-निर्मित और AI-निर्मित पाठों के एक बड़े मिश्रित कॉर्पस पर वाक्य-दर-वाक्य वर्गीकार चलाता है। आज का GPTZero अभी भी एक एकल मुख्य संख्या देता है, लेकिन गणना अलग है। मुख्य संख्या के नीचे वाक्य-स्तरीय हाइलाइटिंग का अर्थ भी 2023 की तुलना में अलग है। कहानी के दोनों संस्करण जानना उपयोगी है, वह जिसने इन शब्दों को प्रसिद्ध बनाया, और वह जो वास्तव में आज चलता है।
इतिहास: perplexity और burstiness ने GPTZero को प्रसिद्ध कैसे बनाया
2 जनवरी, 2023 को, तब के Princeton छात्र Edward Tian ने GPTZero का एक सार्वजनिक डेमो जारी किया, ChatGPT के आने के कुछ ही सप्ताह बाद। उनके मूल व्याख्यात्मक पृष्ठ में बताया गया है कि उन्होंने यह पता लगाने के लिए, कि किसी भाषा मॉडल ने कुछ लिखा है या नहीं, भाषा मॉडलिंग से उधार लिए गए दो सांख्यिकीय मानों का उपयोग कैसे किया। Perplexity एक ऐसा स्कोर है जो बताता है कि संदर्भ मॉडल पाठ में शब्द-चयन से कितना चकित हुआ था। Burstiness GPTZero का वह नाम है जो बताता है कि वह चकित होना पूरे दस्तावेज़ में कितना बदलता रहा। वे व्याख्यात्मक पृष्ठ ही वह कारण हैं कि ये दोनों शब्द AI लेखन के बारे में रोज़मर्रा की बातचीत में आए। आज अधिकांश लोग जो perplexity या burstiness को परिभाषित कर सकते हैं, उन्होंने ये शब्द GPTZero से सीखे, किसी पाठ्यपुस्तक से नहीं।
इस तंत्र को स्वयं समझाना सीधा था। किसी अंश को एक संदर्भ भाषा मॉडल से गुज़ारिए, और जो गद्य मॉडल को अत्यंत पूर्वानुमेय, कम perplexity वाला लगता है, वह मशीन-विशिष्ट पढ़ाई देता है, क्योंकि निर्माण में आश्चर्यजनक शब्द के बजाय संभावित अगले शब्द को प्राथमिकता देने की प्रवृत्ति होती है। GPTZero के अपने, अब बंद किए जा चुके, दस्तावेज़ीकरण में एक सामान्य नियम भी प्रकाशित था, perplexity स्कोर 85 से ऊपर होने पर वह मशीन की तुलना में मानव द्वारा लिखा गया अधिक संभावित माना जाता था। वह सीमा एक विक्रेता से, एक मॉडल पर, समय के एक बिंदु पर आई थी, और GPTZero स्वयं अब उसका समर्थन नहीं करता।
GPTZero अब कैसे काम करता है: एक वाक्य-स्तरीय वर्गीकारक
GPTZero का सहायता केंद्र इसे स्पष्ट रूप से कहता है: "As of autumn 2023, GPTZero no longer uses perplexity and burstiness for its AI detection because we migrated to a deep-learning based architecture." इसका वर्तमान प्रौद्योगिकी पृष्ठ पुष्टि करता है कि यह परिवर्तन पूर्ण है। इसमें "a end-to-end deep learning approach, trained on text datasets from the web, education, and AI-generated from a range of LLMs", का वर्णन है, जिसमें "a sentence-by-sentence classification model determines the probability and confidence that a text was created by AI". Perplexity और burstiness उस पृष्ठ पर कहीं नहीं आते।
तब से, इसमें एक रक्षा परत भी जोड़ी गई है, Paraphraser Shield, जिसे ऐसे AI पाठ को पकड़ने के लिए बनाया गया है जिसे पहचान से बचने के लिए पुनर्लेखन उपकरण से गुजारा गया हो। आप पाठ चिपका सकते हैं, Word दस्तावेज़, PDFs और छवि फ़ाइलें अपलोड कर सकते हैं, और एक बार में पचास तक फ़ाइलें जोड़ सकते हैं। इस अवसंरचना का संदर्भ मॉडल कितनी बार वही शब्द अनुमानित करता, इसकी गणना से कोई संबंध नहीं है।
GPTZero रिपोर्ट वास्तव में आपको क्या दिखाती है
GPTZero परिणाम के तीन भाग होते हैं: AI, human या mixed का एक वर्गीकरण, एक प्रतिशत जो यह व्यक्त करता है कि मॉडल के अनुसार दस्तावेज़ के AI-written होने की कितनी संभावना है, और एक confidence label जो बताता है कि वह विशेष पूर्वानुमान कितना विश्वसनीय है। यह label जितना दिखता है, उससे अधिक महत्वपूर्ण है। GPTZero "highly confident" को 2 percent से कम error rate से और "low confidence" को 14 percent या उससे अधिक error rate से जोड़ता है, जो इतना व्यापक दायरा है कि वही headline percentage एक report से दूसरी report तक बहुत अलग महत्व रख सकता है।
Paid scans sentence-level highlighting जोड़ते हैं, और इसे सही ढंग से पढ़ना उचित है। GPTZero highlighted sentences को वे sentences बताता है जो overall score को अनुपातहीन रूप से प्रभावित कर रहे हैं, न कि individual lines के विरुद्ध आरोपों की सूची। कोई sentence highlight न भी हो, तब भी उसने परिणाम को आकार दिया हो सकता है, क्योंकि classifier document को समग्र रूप से पढ़ता है, sentence by sentence मतदान नहीं करता।
| Report element | यह आपको क्या बताता है |
|---|---|
| Classification | एक एकल label: AI, human, या mixed |
| AI probability score | एक प्रतिशत जो दर्शाता है कि model के अनुसार document के AI-written होने की कितनी संभावना है |
| Confidence label | highly confident, 2 percent से कम error rate, से लेकर low confidence, 14 percent या उससे अधिक, तक की सीमा |
| Sentence highlighting | Advanced Scan पर score में सबसे अधिक योगदान देने वाले sentences को चिह्नित करता है, उससे जुड़े हर sentence को नहीं |
इन report elements में से कोई भी अपने वर्तमान रूप में तब मौजूद नहीं था, जब perplexity-and-burstiness explainer अभी भी GPTZero का अपनी सार्वजनिक description था। interface method के साथ-साथ बदल गया।
अपने पेपर को मानवीय बनाइए
अपने AI-सहायता प्राप्त पाठ को रूपांतरित करें और उसे मानवीय ध्वनि दें, महत्वपूर्ण शब्दों या उद्धरणों को छेड़े बिना।
पर्प्लेक्सिटी और बर्स्टिनेस का विवरण अभी भी क्यों प्रचलित है
GPTZero का मूल व्याख्यात्मक लेख अभी भी ऑनलाइन है, अभी भी अनुक्रमित है, और अभी भी इस बात के अधिक स्पष्ट सामान्य विवरणों में से एक है कि पर्प्लेक्सिटी और बर्स्टिनेस अवधारणाओं के रूप में कैसे काम करते हैं। खोज इंजन और अन्य साइटें इसे उद्धृत करती रहती हैं, और कुछ एक व्यापक रूप से साझा 2026 समीक्षा की ओर संकेत करती हैं, जिसमें दावा किया गया है कि यह उपकरण अभी भी अपने वर्गीकारक के साथ चुपचाप एक पर्प्लेक्सिटी और बर्स्टिनेस परत चलाता है। GPTZero के अपने वर्तमान पृष्ठ, प्रौद्योगिकी पृष्ठ और दोनों सहायता लेख, इसके विपरीत कहते हैं, इन शब्दों को सेवानिवृत्त कर दिया गया था, केवल पर्दे के पीछे छिपाया नहीं गया था। किसी अवधारणा का अमूर्त रूप में वर्णन करने वाला पृष्ठ, इस उपकरण की वर्तमान पद्धति का वर्णन करने वाले पृष्ठ के समान नहीं है, और इन दोनों को परस्पर विनिमेय मानना ही मुख्य कारण है कि यह भ्रम अपनी समाप्ति तिथि के 3 वर्ष बाद तक बना रहा है।
यह बात केवल तुच्छ विवरणों से परे महत्वपूर्ण है। किसी छात्र या सहकर्मी को, जिसे GPTZero को हराने के लिए पर्प्लेक्सिटी कम करने या वाक्य लंबाई को फैलाने के लिए कहा जाता है, ऐसे उत्पाद के संस्करण के लिए दी गई सलाह दी जा रही है जो 2023 में चलना बंद कर चुका था। किसी वाक्य वर्गीकारक को जो चीज़ प्रभावित करती है, वह एक संबंधित लेकिन भिन्न प्रश्न है, जो अपने आप में किसी भी आँकड़े की तुलना में AI detectors वास्तव में कैसे काम करते हैं के व्यापक विवरण के अधिक निकट है। GPTZero ने उन्हें मापना बंद नहीं किया है, अपने ही कथन के अनुसार वे वर्तमान मॉडल को इनपुट देने वाले 7 संकेतकों में शामिल हैं, लेकिन वे वह चीज़ नहीं रहे जो उत्तर तय करती है।
GPTZero क्या नहीं कर सकता, यह क्या कहता है
GPTZero के प्रकाशित बेंचमार्क उतने ही मजबूत हैं जितने किसी विक्रेता से अपने ही उत्पाद के बारे में प्रकाशित करने की अपेक्षा की जा सकती है। कंपनी रिपोर्ट करती है कि "AI-जनित पाठ बनाम मानव लेखन का पता लगाने पर 99% की सटीकता दर" है, कहती है कि "AI बनाम मानव पाठ का मूल्यांकन करते समय हम GPTZero की false positive दर को 1% से अधिक नहीं रखते", और "96.5% की सटीकता दर" दर्ज करती है उन प्रस्तुतियों पर जिनमें AI और मानव लेखन मिश्रित है, साथ ही TOEFL निबंधों पर 1.1 percent, जो गैर-देशी English लेखन के लिए एक सामान्य प्रतिनिधि है। ये संख्याएँ GPTZero के अपने मूल्यांकन से आती हैं, जो January 2025 में प्रकाशित हुआ था, और उन्हें रिपोर्ट करने वाले पृष्ठ पर किसी स्वतंत्र पुनरुत्पादन का उल्लेख नहीं है। वही पृष्ठ उस दावे को भी अस्वीकार करता है जिसे अधिकांश विक्रेता आगे बढ़ाते हैं, यह कहते हुए कि "there is never going to be a 100% guarantee" और जो कोई इसके विपरीत दावा करता है, संभवतः उसके डेटा या उसकी मूल्यांकन विधि में कोई दोष है।
GPTZero का अपना limitations पृष्ठ विपणन आंकड़ों की तुलना में अधिक विशिष्ट है। कंपनी कहती है कि अधिक पाठ प्रस्तुत किए जाने पर सटीकता बेहतर होती है और पूर्ण दस्तावेज़ की तुलना में वाक्य और अनुच्छेद स्तर पर घट जाती है। वह कहती है कि उसका प्रशिक्षण डेटा मुख्यतः वयस्क English गद्य है, इसलिए जो पाठ उस पैटर्न से हटता है, उसे विश्वसनीय रूप से वर्गीकृत करना अधिक कठिन है। वह कहती है कि classifier को ऐसे AI पाठ को पकड़ने के लिए प्रशिक्षित नहीं किया गया है जिसे उत्पन्न होने के बाद बहुत अधिक संशोधित किया गया हो। और वह स्पष्ट रूप से कहती है कि केवल chatbot आउटपुट ही नहीं, बल्कि अन्य machine-generated या अत्यधिक प्रक्रियात्मक लेखन भी उसी तरह चिह्नित किया जा सकता है।
इनमें से कोई भी बात GPTZero के आंकड़े को प्रश्नातीत मानने का कारण नहीं है, और यह भी एकमात्र detector नहीं है जिसे अपने ही संदर्भ में समझना आवश्यक है। जो पाठक यह जानना चाहते हैं कि ऐसा classifier वास्तव में किस पर प्रतिक्रिया करता है, वे इस पैटर्न का एक रूप स्वयं free perplexity checker या free burstiness checker के साथ देख सकते हैं, जो एक अधिक पूर्ण free tools collection के दो भाग हैं, जिसमें इस तरह की रिपोर्ट जिन अन्य सांख्यिकीय स्तरों पर निर्भर करती है, वे शामिल हैं।
GPTZero के दो प्रमुख सांख्यिकीय मानों के लिए अलग-अलग पृष्ठ हैं: AI detection में perplexity क्या मापता है, और वह token probability अंकगणित जो दोनों संख्याएँ उत्पन्न करता है.
जो tool अपने blind spots को इतनी स्पष्टता से नाम देने को तैयार है, वह उस tool की तुलना में अधिक विश्वास के योग्य है जो किसी blind spot के न होने का दावा करता है, और report पर अगला अस्पष्टीकृत percentage यह पूछना शुरू करने के लिए एक अच्छा स्थान है कि उसे किस प्रकार के tool ने उत्पन्न किया।
हमारे अपने शोध ने क्या पाया
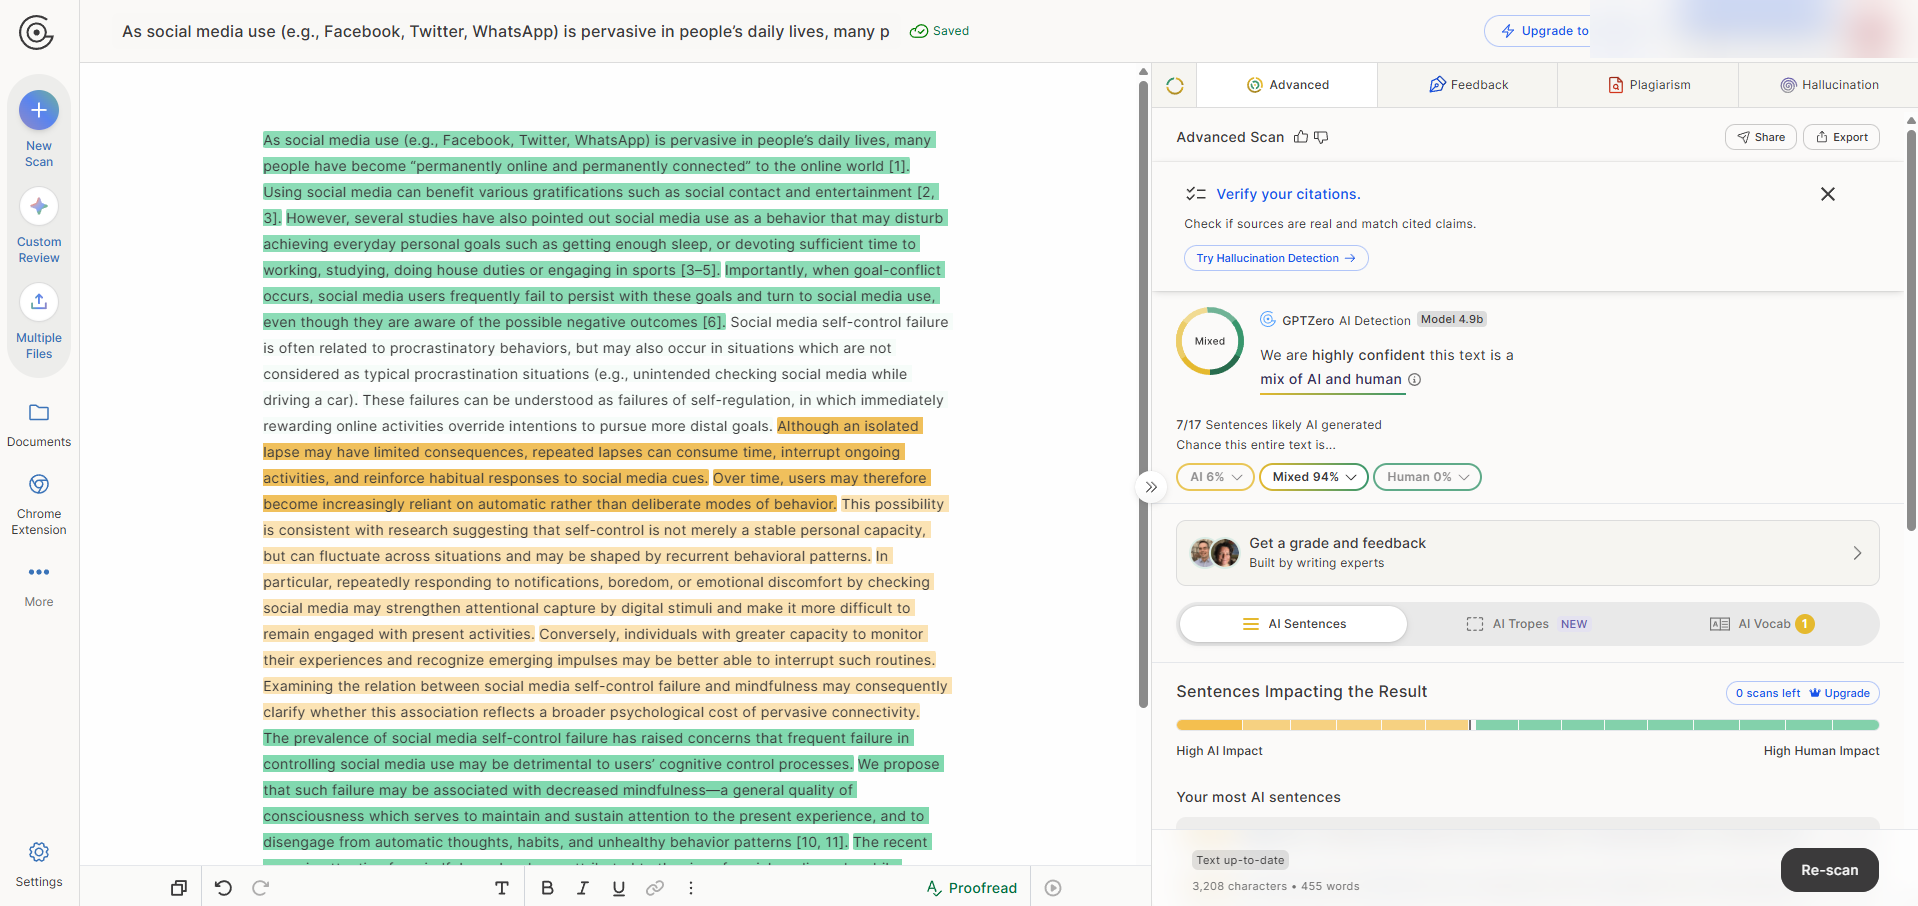
TextPulse Research के डिटेक्टर सहमति अध्ययन में नौ व्यावसायिक AI डिटेक्टरों ने वही 90 अकादमिक टेक्स्ट परखे। इनमें से एक 455 शब्दों का हाइब्रिड टेक्स्ट था: शुरुआत और अंत इंसान के लिखे हुए, बीच में 168 शब्दों का AI-लिखा हिस्सा। GPTZero ने इस टेक्स्ट को 41.2% AI स्कोर दिया, जबकि उन्हीं शब्दों पर बाकी टूल्स के फैसले 0% से 95.7% AI तक फैले थे। पूरा शोधपत्र, कॉर्पस और हर टूल की स्कोर मैट्रिक्स TextPulse Research पर खुले रूप से उपलब्ध है।
अक्सर पूछे जाने वाले प्रश्न
नहीं। GPTZero का सहायता केंद्र बताता है कि कंपनी ने autumn 2023 तक पहचान के लिए perplexity और burstiness का उपयोग बंद कर दिया था, deep-learning वर्गीकारक पर स्विच करने के बाद। इसका वर्तमान प्रौद्योगिकी पृष्ठ एक वाक्य-दर-वाक्य वर्गीकरण मॉडल का वर्णन करता है और इनमें से किसी भी शब्द का उल्लेख नहीं करता। यह विवरण अभी भी प्रचलित है क्योंकि GPTZero के अपने 2023 विवरण ने विधि बदलने से पहले दोनों शब्दों को लोकप्रिय बनाया था.
PhD in natural language processing, with years spent building NLP applications end to end. Moe works on text analysis: lexical and syntactic structure, and what separates machine-generated prose from human prose statistically. He has been experimenting with computational linguistics since the early days of NLTK, spaCy and WordNet, and still writes most of his tooling in Python.



