Turnitin समानता स्कोर बनाम AI स्कोर: दो अलग रिपोर्टें
एक समानता स्कोर और एक AI स्कोर अलग प्रश्नों का उत्तर देते हैं, इसलिए एक पेपर एक में कम और दूसरे में अधिक स्कोर कर सकता है, बिना किसी भी संख्या के गलत हुए। प्रत्येक क्या मापता है, क्या उसे ट्रिगर करता है, और उच्च संख्या क्या सिद्ध करती है और क्या नहीं, यह अलग है।

एक रिपोर्ट में दो संख्याएँ दिखाई देती हैं: 3 प्रतिशत का समानता स्कोर और 88 प्रतिशत का AI स्कोर। स्वाभाविक रूप से यह समझा जाता है कि वे एक ही चीज़ को माप रहे होंगे, इसलिए कम संख्या का अर्थ यह होना चाहिए कि उच्च संख्या भी संभवतः गलत है। ऐसा नहीं होता। Turnitin similarity vs AI score दो अलग प्रणालियों के बीच एक तुलना है, जो दो अलग चीज़ों की जाँच करती हैं, और कोई प्रस्तुति एक में कम तथा दूसरी में अधिक स्कोर कर सकती है, बिना इस बात के कि दोनों में से कोई भी संख्या त्रुटि हो।
यह AI वाले से पुराना है, और इसे ऐसे पाठ को पकड़ने के लिए बनाया गया था जो पहले से मौजूद किसी सामग्री से मेल खाता हो। यह नया है, और इसे उसी Similarity Report में एक स्वतंत्र माप के रूप में जोड़ा गया है, ताकि यह अनुमान लगाया जा सके कि गद्य मशीन-जनित पढ़ता है या नहीं, चाहे वह किसी भी चीज़ से मेल खाता हो या नहीं। Turnitin के अपने दस्तावेज़ के अनुसार, ये पूरी तरह स्वतंत्र हैं और एक दूसरे को प्रभावित नहीं करते। इस लेख की बाकी सभी बातें।

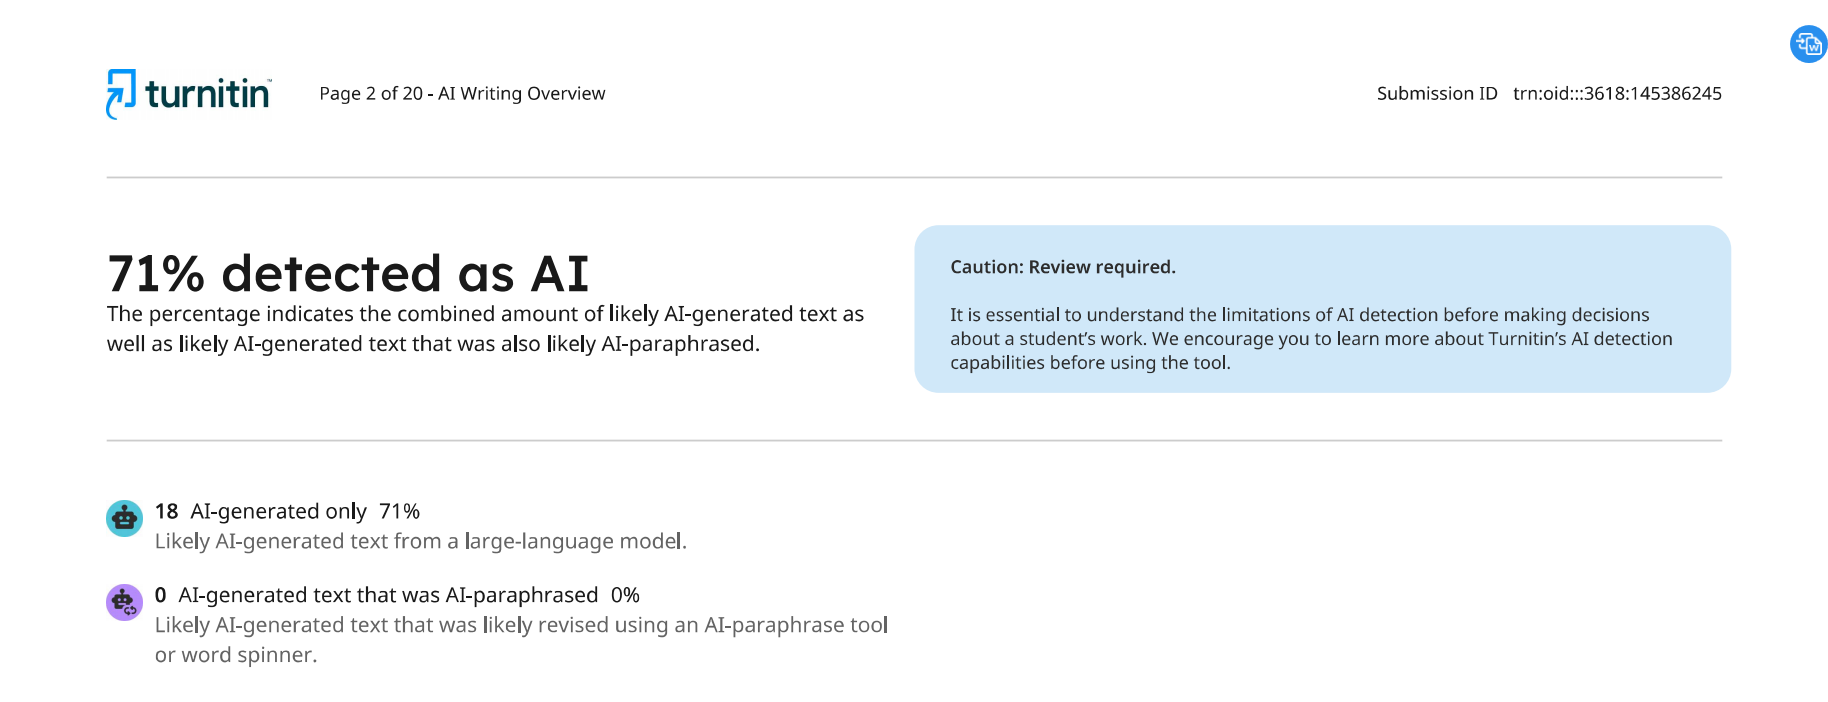
Turnitin Similarity बनाम AI Score: प्रत्येक संख्या क्या रिपोर्ट करती है
Turnitin इन दोनों को एक ही उत्पाद में समाहित दो अलग मापों के रूप में मानता है, न कि एक परिणाम के दो दृष्टिकोणों के रूप में। Similarity Report किसी प्रस्तुति की तुलना वेब सामग्री, शैक्षणिक प्रकाशनों, और पहले से प्रस्तुत छात्र पत्रों के डेटाबेस से करता है, और प्रस्तुति के उस पाठ का प्रतिशत लौटाता है जो उस डेटाबेस में पहले से मौजूद किसी चीज़ से मेल खाता है। AI लेखन पहचान पूरी तरह एक अलग मॉडल चलाती है, जिसे उसी रिपोर्ट में उसके अपने स्वतंत्र स्कोर के रूप में जोड़ा गया है, और जिसे इस बात का आकलन करने के लिए प्रशिक्षित किया गया है कि किसी अंश की गद्य-शैली मशीन-जनित लेखन से कितनी मिलती-जुलती है, बिना किसी बाहरी डेटाबेस के किसी भी संदर्भ के। Turnitin का AI classifier उस संख्या तक कैसे पहुँचता है इसकी अधिक विस्तृत कार्यप्रणाली अलग से दी गई है, यहाँ महत्वपूर्ण यह है कि यह उसी रिपोर्ट के भीतर मौजूद similarity engine से अलग प्रश्न का उत्तर देता है।
Similarity Score वास्तव में क्या मापता है
Similarity एक मिलान अभ्यास है, कोई निर्णय नहीं। Turnitin का अपना मार्गदर्शन स्पष्ट है कि यह उपकरण plagiarism की जाँच नहीं करता। यह ओवरलैप की जाँच करता है और व्याख्या को रिपोर्ट पढ़ने वाले प्रशिक्षक पर छोड़ देता है। सही ढंग से अलग किया गया उद्धरण, किसी पूरे उपक्षेत्र में साझा किया गया methods-section का वाक्यांश, किसी journal में हर paper की reference list जिस तरह से स्वरूपित होती है उसी तरह स्वरूपित reference list, इनमें से कोई भी मिलान के रूप में दर्ज हो सकता है, क्योंकि प्रणाली पाठ की ओवरलैप होने वाली strings को गिनती है, न कि यह निर्णय करती है कि ओवरलैप वैध है या नहीं।
यही कारण भी है कि similarity score का zero जितना दिखता है, उससे कम साबित करता है। इसका अर्थ है कि प्रस्तुतिकरण में पाठ का कोई लंबा, बिना टूटे हुआ अंश नहीं है जो Turnitin के indexed sources में कहीं और मिला हो। यह इस बारे में कुछ नहीं कहता कि वहाँ मौजूद वाक्य कैसे बनाए गए थे, क्योंकि ऐसा वाक्य बनाना जो database में किसी चीज़ से मेल न खाए, वैसी ही कौशल नहीं है जैसी ऐसा वाक्य बनाना जिसे language model ने अनुमानित न किया होता।
अपने पेपर को मानवीय बनाइए
अपने AI-सहायता प्राप्त पाठ को रूपांतरित करें और उसे मानवीय ध्वनि दें, महत्वपूर्ण शब्दों या उद्धरणों को छेड़े बिना।
AI Score वास्तव में क्या मापता है
AI score के पास जाँचने के लिए कोई database नहीं होता। एक classifier प्रस्तुत गद्य को पढ़ता है और, मानव तथा AI-generated लेखन के उदाहरणों पर सीखे गए पैटर्नों के आधार पर, यह अनुमान लगाता है कि वह गद्य किसी व्यक्ति की तुलना में model से आया होने की कितनी संभावना रखता है। उस अनुमान का इस बात पर कोई निर्भर नहीं होता कि क्या वही सटीक वाक्य पहले कभी कहीं प्रकट हुआ है। कोई वाक्य पूरी तरह अद्वितीय हो सकता है, इस प्रस्तुतिकरण तक किसी ने उसे कभी टाइप न किया हो, और फिर भी यदि उसके शब्द-चयन और लय उस पैटर्न का अनुसरण करते हैं जिसे language model सामान्यतः उत्पन्न करता है, तो वह सांख्यिकीय रूप से AI output के लिए विशिष्ट पढ़ा जा सकता है।
यह वही सांख्यिकीय क्षेत्र है जिसे व्यापक विवरण में how AI detectors actually work के अंतर्गत पूरी तरह शामिल किया गया है: शब्द-स्तरीय पूर्वानुमेयता और वाक्य-स्तरीय लय, जो एक ही document score में समाहित हो जाते हैं। Turnitin का इस classifier का संस्करण proprietary है, लेकिन मूल धारणा, कि generated text मानव लेखन की तुलना में सांख्यिकीय रूप से अधिक विशिष्ट होता है, वही है जो इस श्रेणी के हर tool के पीछे काम करती है।
| समानता स्कोर | AI स्कोर | |
|---|---|---|
| यह क्या मापता है | सबमिशन के पाठ का कितना भाग अन्य अनुक्रमित दस्तावेज़ों से मेल खाता है | गद्य सांख्यिकीय रूप से सामान्य AI-जनित लेखन से कितनी निकटता से मिलता-जुलता है |
| उच्च संख्या को क्या ट्रिगर करता है | लंबे उद्धरण, क्षेत्र-विशिष्ट सामान्य वाक्यांश, पुनः उपयोग की गई सामग्री, या किसी पूर्व सबमिशन से मेल | संपूर्ण दस्तावेज़ में समान वाक्य-लय और लगातार पूर्वानुमेय शब्द-चयन |
| उच्च संख्या क्या सिद्ध नहीं करती | कि मेल खाया हुआ पाठ अनुचित रूप से उपयोग किया गया था। सही ढंग से उद्धृत सामग्री भी मेल के रूप में दर्ज हो सकती है। | कि कोई एकल वाक्य AI द्वारा जनित था। वर्गीकारक दस्तावेज़ के समग्र पैटर्न को पढ़ता है, किसी एक पंक्ति को अलग से नहीं। |
क्या किसी पेपर में 0 प्रतिशत समानता और 90 प्रतिशत AI स्कोर हो सकता है?
हाँ, और यह संयोजन कोई गड़बड़ी नहीं है। दोनों स्कोर अलग-अलग प्रश्नों का उत्तर देते हैं, इसलिए उच्च और निम्न के सभी चार संयोजन संभव हैं, और प्रत्येक यह बताता है कि पाठ किस प्रकार तैयार किया गया था।
- निम्न समानता, निम्न AI स्कोर: सामान्य मौलिक लेखन, जो मानवीय विविधता के साथ पढ़ा भी जाता है। अधिकांश वास्तविक छात्र-कार्य में यही सामान्य स्थिति है।
- निम्न समानता, उच्च AI स्कोर: मौलिक वाक्य, जो कहीं से नकल नहीं किए गए हैं, लेकिन सांख्यिकीय रूप से पूर्वानुमेय लगते हैं, जैसा कि जनित पाठ प्रवृत्त होता है। यह बिना संपादन वाले AI लेखन की पहचान है, जिसे किसी ने किसी मौजूदा स्रोत से paraphrase नहीं किया था।
- उच्च समानता, निम्न AI स्कोर: ऐसा पाठ जो किसी मौजूदा मानव-लिखित स्रोत से निकटता से मेल खाता है, लेकिन उसमें वह सांख्यिकीय समतलता नहीं है जिसे वर्गीकारक जनन से जोड़ता है। नकल किया गया पाठ, जिसे पुराने उपकरण ने पकड़ा, नए ने नहीं।
- उच्च समानता, उच्च AI स्कोर: ऐसा पाठ जो किसी मौजूदा स्रोत से मेल खाता है, जो स्वयं AI-जनित था, उदाहरण के लिए पहले से सबमिट किया गया AI-लिखित पेपर या AI-उत्पादित पाठ का कोई पृष्ठ जो पहले से खुले वेब से अनुक्रमित हो चुका है।
इन संयोजनों में से किसी के लिए भी सॉफ़्टवेयर पक्ष पर कुछ असामान्य आवश्यक नहीं होता। ये इस तथ्य से निकलते हैं कि एक प्रणाली मिलान की जाँच करती है और दूसरी एक पैटर्न की, और पाठ का एक अंश इनमें से कोई भी गुण, दोनों, या कोई भी नहीं, रख सकता है।
एक उच्च AI स्कोर क्या सिद्ध करता है, और क्या सिद्ध नहीं करता
एक उच्च AI स्कोर एक सांख्यिकीय अनुमान है, पाठ से निकाला गया स्वीकारोक्ति नहीं। यह कहता है कि वर्गीकारक के सामने रखी गई गद्य रचना, अपने शब्द-चयन और लय में, उस प्रकार के लेखन से मिलती-जुलती है जिसे मॉडल को AI निर्माण से जोड़ने के लिए प्रशिक्षित किया गया था। यह किसी विशिष्ट वाक्य को निश्चित रूप से मशीन-लिखित के रूप में पहचानता नहीं है, और यह दस्तावेज़ वास्तव में कैसे तैयार किया गया था, इसके बारे में कुछ नहीं जानता, केवल यह जानता है कि पूरा होने के बाद वह कैसा पढ़ता है। TextPulse अपने स्वयं के संख्यात्मक मानों के बारे में भी यही स्थिति लेता है: वह जो रिपोर्ट करता है, वह अपने सामने मौजूद पाठ से गणना किया गया एक अनुमानित Human Score है, न कि इस बारे में कोई निर्णय कि किस उपकरण ने, यदि किसी ने, दस्तावेज़ को छुआ था।
किसी भी संख्या, कम समानता स्कोर या उच्च AI स्कोर, पर व्यावहारिक प्रतिक्रिया एक ही है: इसे और करीब से देखने का कारण मानें, न कि ऐसी खोज जिसे पहली नज़र में स्वीकार या अस्वीकार कर दिया जाए। प्रारूप, नोट्स, और संस्करण इतिहास इस बात की ओर संकेत करते हैं कि दस्तावेज़ वास्तव में कैसे लिखा गया था, जिस तरह कोई प्रतिशत कभी नहीं कर सकता, किसी भी रिपोर्ट पर। जो कोई यह जानना चाहता है कि एक वर्गीकारक वास्तव में अपने स्वयं के प्रारूप में किस पर प्रतिक्रिया दे रहा है, वह किसी भी रिपोर्ट के तैयार होने से बहुत पहले, free perplexity checker के साथ स्वयं वही शब्द-स्तरीय पैटर्न देख सकता है।
TextPulse का free tools collection उन अन्य सांख्यिकीय स्तरों को भी कवर करता है, जिनकी जाँच किसी प्रारूप को किसी प्रशिक्षक के पास ले जाने से पहले करनी चाहिए, न कि केवल यहाँ तुलना किए गए दो को।
जब दोनों संख्याएँ अलग कर दी जाती हैं, तो अगला प्रश्न यह होता है कि एक अच्छा Turnitin स्कोर क्या माना जाता है। जिस अन्य डिटेक्टर से छात्र सबसे अधिक मिलते हैं, उसके लिए GPTZero कैसे काम करता है अपने अलग पृष्ठ पर समझाया गया है।
दोनों संख्याएँ उसी रिपोर्ट में एक-दूसरे के पास ही बनी रहेंगी, और जल्दी में पढ़ने वाले लोग उन्हें एक ही संख्या के रूप में पढ़ते रहेंगे। यह जानना कि इनमें से प्रत्येक वास्तव में किस प्रश्न का उत्तर दे रही है, एक उलझाने वाले प्रतिशत-युग्म को सूचना के दो अलग, उपयोगी खंडों में बदल देता है।
अक्सर पूछे जाने वाले प्रश्न
Turnitin समानता बनाम AI स्कोर इस बात पर निर्भर करता है कि प्रत्येक क्या जाँचता है। समानता स्कोर यह रिपोर्ट करता है कि किसी सबमिशन का कितना भाग Turnitin के वेब पृष्ठों, प्रकाशनों, और पिछले छात्र पत्रों के डेटाबेस में पहले से मौजूद पाठ से मेल खाता है। AI स्कोर एक अलग, स्वतंत्र माप है जो यह अनुमान लगाता है कि गद्य मशीन-जनित की तरह कितना पढ़ा जाता है, और इसका किसी भी डेटाबेस से कोई संदर्भ नहीं होता। Turnitin के अपने दस्तावेज़ कहते हैं कि ये दो आँकड़े एक दूसरे को प्रभावित नहीं करते।
PhD in natural language processing, with years spent building NLP applications end to end. Moe works on text analysis: lexical and syntactic structure, and what separates machine-generated prose from human prose statistically. He has been experimenting with computational linguistics since the early days of NLTK, spaCy and WordNet, and still writes most of his tooling in Python.



