GPTZero کیسے کام کرتا ہے
GPTZero نے perplexity اور burstiness کو مشہور کیا، پھر خاموشی سے دونوں کو ترک کر دیا۔ یہاں بتایا گیا ہے کہ اس کا درجہ بند کنندہ اب کیا ناپتا ہے، ایک رپورٹ اصل میں کیا دکھاتی ہے، اور وہ حدود کہاں ہیں جنہیں یہ ٹول خود بیان کرتا ہے.

"how gptzero works" کو ایک سرچ بار میں ٹائپ کریں اور جو کچھ واپس آتا ہے اس کا زیادہ تر حصہ اب بھی perplexity اور burstiness کی وضاحت کرتا ہے، یہ دو اعدادوشمار جنہیں اس کے اپنے بانی نے ChatGPT کی ریلیز کے بعد پہلے ہفتوں میں مشہور کیا تھا۔ یہ وضاحت جنوری 2023 میں درست تھی۔ اس کے بعد یہ درست نہیں رہی، کیونکہ اسی سال خزاں میں GPTZero کی اپنی دستاویزات کے مطابق کمپنی نے اس طریقے کو کسی اور بالکل مختلف چیز سے بدل دیا۔ اس فرق کی وسعت، جو اس آلے نے آغاز میں کیا تھا اور جو یہ اب کرتا ہے، اتنی ہے کہ آج بھی گردش کرنے والی زیادہ تر توضیحات ایک ایسے محصول کی وضاحت کرتی ہیں جو اب موجود ہی نہیں۔
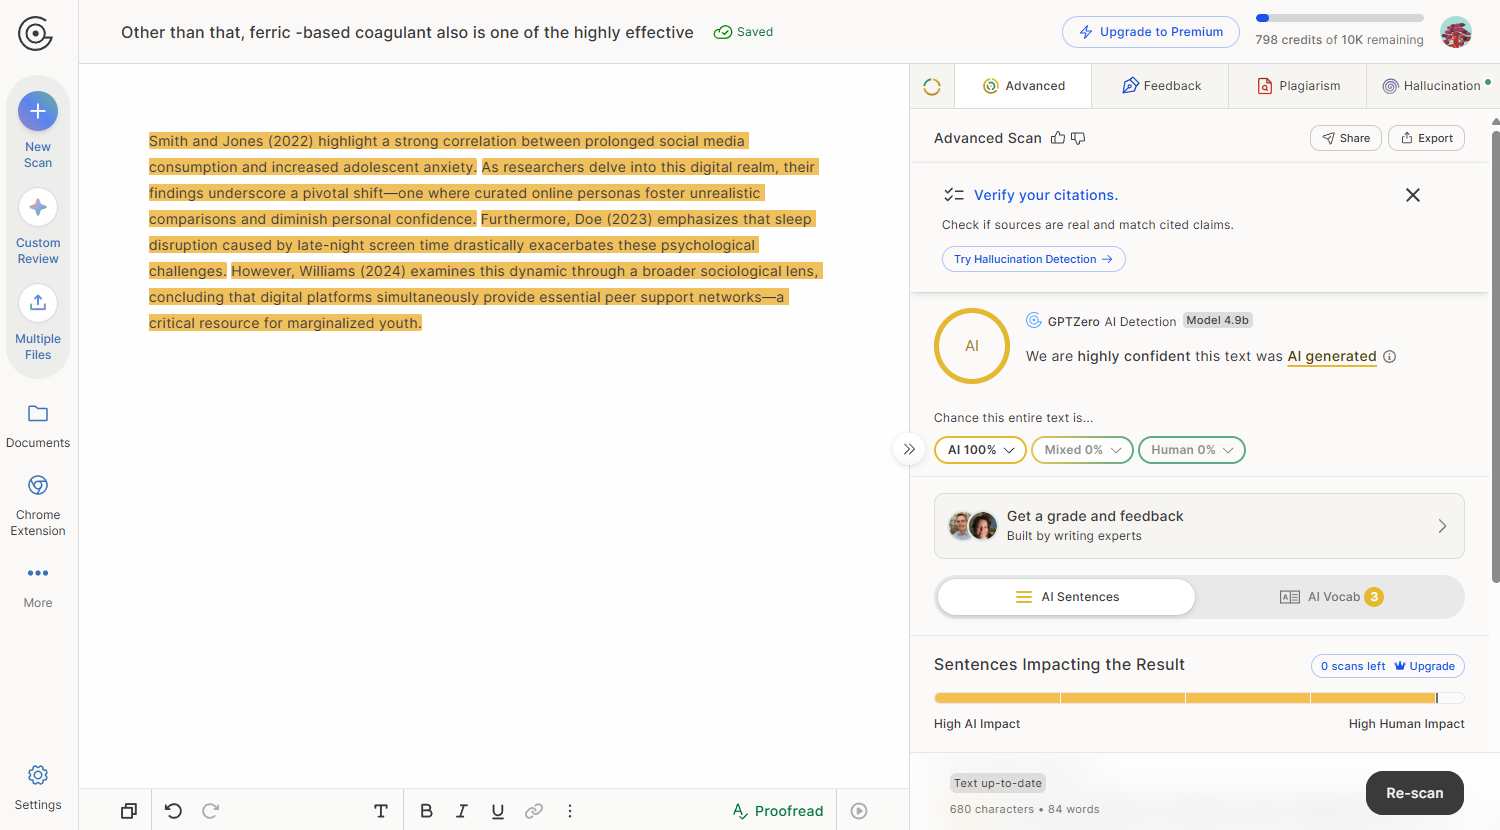
آج، GPTZero perplexity کے حساب کے بجائے انسانی طور پر تیار کردہ اور AI-Generated متون کے ایک بڑے مخلوط corpus پر جملہ بہ جملہ classifier چلاتا ہے۔ آج کا GPTZero اب بھی ایک واحد نمایاں عدد فراہم کرتا ہے، لیکن حسابی عمل مختلف ہے۔ نمایاں عدد کے نیچے جملہ سطح کی highlighting بھی 2023 کے مقابلے میں مختلف معنی رکھتی ہے۔ کہانی کے دونوں ورژن جاننا مفید ہے, وہ جس نے ان اصطلاحات کو مشہور کیا، اور وہ جو واقعی آج چل رہا ہے۔
تاریخ: Perplexity اور Burstiness نے GPTZero کو کیسے مشہور کیا
2 جنوری 2023 کو، اس وقت کے پرنسٹن کے طالب علم Edward Tian نے GPTZero کا ایک عوامی ڈیمو جاری کیا، ChatGPT کے آنے کے محض چند ہفتے بعد۔ اس کے اصل وضاحتی صفحے میں بتایا گیا ہے کہ اس نے زبان کی ماڈلنگ سے مستعار لیے گئے دو اعدادوشمار کو استعمال کرکے یہ کیسے معلوم کیا کہ کب کسی زبان کے ماڈل نے کوئی متن لکھا ہے۔ Perplexity ایک اسکور ہے جو بتاتا ہے کہ حوالہ ماڈل متن میں لفظوں کے انتخاب سے کتنا حیران ہوا۔ Burstiness GPTZero کا وہ نام ہے جو اس بات کے لیے استعمال ہوتا ہے کہ یہ حیرت ایک دستاویز میں کتنی اتار چڑھاؤ کا شکار ہوئی۔ انہی وضاحتی صفحات کی وجہ سے یہ دونوں الفاظ AI تحریر کے بارے میں روزمرہ گفتگو میں داخل ہوئے۔ آج جو زیادہ تر لوگ perplexity یا burstiness کی تعریف کر سکتے ہیں، انہوں نے یہ اصطلاحات GPTZero سے سیکھیں، کسی درسی کتاب سے نہیں۔
اس طریقۂ کار کو خود بیان کرنا سیدھا تھا۔ ایک حوالہ زبان ماڈل کے ذریعے کسی عبارت کو گزاریں، اور جو نثر ماڈل کو بہت زیادہ قابلِ پیش گوئی، کم perplexity والی لگے، وہ مشینی انداز کی محسوس ہوتی ہے، کیونکہ تخلیق میں عموماً حیران کن لفظ کے بجائے زیادہ ممکنہ اگلے لفظ کو ترجیح دی جاتی ہے۔ GPTZero کی اپنی ریٹائر شدہ دستاویزات میں ایک عمومی قاعدہ بھی شائع تھا: 85 سے اوپر perplexity اسکور انسان کے لکھے ہوئے ہونے کے زیادہ امکان کے طور پر پڑھا جاتا تھا، مشین کے مقابلے میں۔ یہ حد ایک ہی فروشندہ، ایک ہی ماڈل، اور وقت کے ایک ہی نقطے سے آئی تھی، اور خود GPTZero اب اس کی ذمہ داری نہیں لیتا۔
GPTZero اب کیسے کام کرتا ہے: ایک جملہ سطحی درجہ بند کنندہ
GPTZero کا سپورٹ سینٹر اسے صاف لفظوں میں بیان کرتا ہے: "As of autumn 2023, GPTZero no longer uses perplexity and burstiness for its AI detection because we migrated to a deep-learning based architecture." اس کا موجودہ ٹیکنالوجی صفحہ اس تبدیلی کے مکمل ہونے کی تصدیق کرتا ہے۔ اس میں "a sentence-by-sentence classification model determines the probability and confidence that a text was created by AI" کے ساتھ "an end-to-end deep learning approach, trained on text datasets from the web, education, and AI-generated from a range of LLMs" بیان کیا گیا ہے۔ اس صفحے پر perplexity اور burstiness کہیں بھی ظاہر نہیں ہوتے۔
تب سے، اس نے ایک دفاعی تہہ بھی شامل کی ہے، Paraphraser Shield، جو ایسے AI متن کو پکڑنے کے لیے بنایا گیا ہے جسے شناخت سے بچنے کے لیے دوبارہ لکھنے والے آلے سے گزارا گیا ہو۔ آپ متن پیسٹ کر سکتے ہیں، Word دستاویزات، PDFs اور تصویری فائلیں اپ لوڈ کر سکتے ہیں، اور ایک وقت میں پچاس تک فائلیں شامل کر سکتے ہیں۔ ان میں سے کسی بھی بنیادی ڈھانچے کا اس بات سے کوئی تعلق نہیں کہ کوئی حوالہ جاتی ماڈل ایک ہی لفظ کو کتنی بار درست اندازہ لگاتا۔
GPTZero رپورٹ دراصل آپ کو کیا دکھاتی ہے
GPTZero کے نتیجے میں تین حصے ہوتے ہیں: AI، human یا mixed کی درجہ بندی، ایک فیصد جو اس امکان کو ظاہر کرتا ہے کہ دستاویز AI-written تھی، اور ایک confidence label جو بیان کرتا ہے کہ وہ مخصوص پیش گوئی کتنی قابلِ اعتماد ہے۔ یہ label اس سے زیادہ اہم ہے جتنا وہ بظاہر لگتا ہے۔ GPTZero "highly confident" کو 2 percent سے کم error rate سے جوڑتا ہے اور "low confidence" کو 14 percent یا اس سے زیادہ error rate سے، جو اتنی وسیع حد ہے کہ ایک ہی headline percentage ایک رپورٹ سے دوسری رپورٹ تک بہت مختلف وزن رکھ سکتی ہے۔
Paid scans sentence-level highlighting بھی شامل کرتے ہیں، اور اسے درست طور پر پڑھنا ضروری ہے۔ GPTZero highlighted sentences کو وہ جملے قرار دیتا ہے جو مجموعی score پر غیر متناسب طور پر اثر انداز ہوتے ہیں، نہ کہ انفرادی سطور کے خلاف الزامات کی فہرست۔ کوئی جملہ highlight نہ بھی ہو اور پھر بھی نتیجے کی تشکیل میں اس کا کردار رہا ہو سکتا ہے، کیونکہ classifier دستاویز کو مجموعی طور پر پڑھتا ہے، نہ کہ جملہ بہ جملہ ووٹ دیتا ہے۔
| Report element | یہ آپ کو کیا بتاتا ہے |
|---|---|
| Classification | ایک واحد label: AI, human, یا mixed |
| AI probability score | ایک فیصد جو ظاہر کرتا ہے کہ model دستاویز کو AI-written ہونے کا کتنا امکان سمجھتا ہے |
| Confidence label | highly confident سے، 2 percent سے کم error rate کے ساتھ، low confidence تک، 14 percent یا اس سے زیادہ |
| Sentence highlighting | Advanced Scan میں score میں سب سے زیادہ حصہ ڈالنے والے جملوں کو نشان زد کرتا ہے، نہ کہ اس سے وابستہ ہر جملے کو |
ان report elements میں سے کوئی بھی اپنی موجودہ شکل میں اس وقت موجود نہیں تھا جب perplexity-and-burstiness explainer ابھی GPTZero کی اپنی عوامی وضاحت تھا۔ method کے ساتھ ساتھ interface بھی بدل گیا۔
اپنے مقالے کو انسانی انداز دیں
اپنے AI کی مدد سے تیار کردہ متن کو تبدیل کریں اور اسے انسانی محسوس ہونے دیں، اہم الفاظ یا حوالہ جات کو چھوئے بغیر۔
Perplexity اور Burstiness کی وضاحت اب بھی کیوں گردش میں ہے
GPTZero کی اصل وضاحتی تحریر اب بھی آن لائن ہے، اب بھی index کی جاتی ہے، اور اب بھی اس بات کی نسبتاً واضح عمومی وضاحتوں میں سے ایک ہے کہ perplexity اور burstiness بطور تصورات کیسے کام کرتے ہیں۔ Search engines اور دوسری sites اس کا حوالہ دیتے رہتے ہیں، اور کچھ ایک وسیع پیمانے پر شیئر کی گئی 2026 review کی طرف اشارہ کرتے ہیں جس میں دعویٰ کیا گیا ہے کہ tool اب بھی اپنے classifier کے ساتھ خاموشی سے ایک perplexity اور burstiness layer چلاتا ہے۔ GPTZero کے اپنے موجودہ pages, technology page اور دونوں support articles, اس کے برعکس کہتے ہیں: یہ terms retire کر دیے گئے تھے، محض پس منظر میں چھپائے نہیں گئے تھے۔ کسی concept کی abstract وضاحت والا page اور اس tool کے موجودہ طریقہ کار کی وضاحت والا page ایک چیز نہیں ہیں، اور ان دونوں کو ایک دوسرے کے متبادل سمجھنا ہی اس الجھن کے تین سال تک اس کی مدت ختم ہونے کے بعد بھی برقرار رہنے کی سب سے بڑی وجہ ہے۔
یہ بات محض trivia سے بڑھ کر اہم ہے۔ کسی student یا colleague کو یہ کہا جائے کہ GPTZero کو شکست دینے کے لیے perplexity کم کرے یا sentence length کو پھیلا دے، تو اسے ایسی advice دی جا رہی ہے جو product کے اس version کے لیے ہے جو 2023 میں چلنا بند ہو گیا تھا۔ کسی sentence classifier کو جو چیز حرکت دیتی ہے وہ اس سے متعلق مگر مختلف سوال ہے، جو اس سے زیادہ قریب ہے کہ AI detectors حقیقت میں کیسے کام کرتے ہیں، بنسبت اس کے کہ ان دونوں statistics میں سے کسی ایک کو اکیلے دیکھا جائے۔ GPTZero نے انہیں measure کرنا بند نہیں کیا، اس کے اپنے بیان کے مطابق وہ current model کو feed کرنے والے seven indicators میں شامل ہیں، لیکن وہ وہ چیز نہیں رہے جو جواب طے کرتی ہے۔
GPTZero کیا کہتا ہے کہ وہ کیا نہیں کر سکتا
GPTZero کے شائع شدہ benchmarks اتنے ہی مضبوط ہیں جتنے کسی vendor سے توقع کی جا سکتی ہے کہ وہ اپنی ہی product کے بارے میں شائع کرے۔ کمپنی رپورٹ کرتی ہے کہ "AI-generated text بمقابلہ human writing کا پتہ لگانے میں 99% کی accuracy rate"، کہتی ہے "ہم GPTZero کی false positive rate کو AI بمقابلہ human text کا جائزہ لیتے وقت 1% سے زیادہ نہیں رہنے دیتے"، اور "96.5% کی accuracy rate" درج کرتی ہے ان submissions پر جن میں AI اور human writing دونوں شامل ہوں، اس کے ساتھ TOEFL essays پر 1.1 percent، جو non-native English writing کے لیے ایک عام متبادل ہے۔ یہ اعداد و شمار GPTZero کی اپنی evaluation سے آئے ہیں، جو January 2025 میں شائع ہوئی تھی، اور ان کے ساتھ page پر کسی independent replication کا حوالہ نہیں دیا گیا۔ وہی page اس دعوے کو بھی رد کرتی ہے جسے اکثر vendors پیش کرتے ہیں، اور کہتی ہے کہ "100% guarantee کبھی نہیں ہو گی" اور جو کوئی اس کے برعکس دعویٰ کرے اس کے data یا evaluation method میں غالباً کوئی خامی ہے۔
GPTZero کا اپنا limitations page marketing figures سے زیادہ specific ہے۔ کمپنی کہتی ہے کہ جیسے جیسے زیادہ text submit کیا جاتا ہے accuracy بہتر ہوتی ہے، اور full document کے مقابلے میں sentence اور paragraph level پر کم ہو جاتی ہے۔ وہ کہتی ہے کہ اس کا training data زیادہ تر adult English prose پر مشتمل ہے، اس لیے جو text اس pattern سے ہٹتا ہے اسے reliably classify کرنا زیادہ مشکل ہے۔ وہ کہتی ہے کہ classifier کو generation کے بعد بہت زیادہ modified AI text پکڑنے کے لیے train نہیں کیا گیا۔ اور وہ صاف طور پر کہتی ہے کہ صرف chatbot output ہی نہیں، بلکہ دوسری machine-generated یا بہت زیادہ procedural writing بھی اسی طرح flag ہو سکتی ہے۔
ان میں سے کوئی بات GPTZero کے number کو سوال سے بالاتر سمجھنے کی وجہ نہیں بنتی، اور یہ واحد detector بھی نہیں جسے اپنے اپنے terms پر سمجھنا ضروری ہو۔ جو readers یہ جاننا چاہتے ہیں کہ ایسا classifier اصل میں کس چیز پر response دیتا ہے، وہ اس pattern کی ایک صورت خود free perplexity checker یا free burstiness checker کے ساتھ دیکھ سکتے ہیں، جو free tools collection کے دو حصے ہیں اور اس report میں استعمال ہونے والی دوسری statistical layers کا احاطہ کرتے ہیں۔
GPTZero کے دو نمایاں اعداد و شمار کے لیے الگ صفحات موجود ہیں: AI detection میں perplexity کیا ناپتا ہے, اور token probability کی وہ ریاضی جو دونوں اعداد پیدا کرتی ہے.
جو tool اپنی کمزوریاں اتنی صراحت سے خود بیان کرنے پر آمادہ ہو, وہ اس tool سے زیادہ اعتماد کے لائق ہے جو دعویٰ کرے کہ اس میں کوئی کمزوری نہیں, اور report میں آنے والا اگلا غیر واضح percentage یہ پوچھنے کے لیے ایک مناسب جگہ ہے کہ اسے کس نوعیت کے tool نے پیدا کیا تھا.
ہماری اپنی تحقیق نے کیا پایا
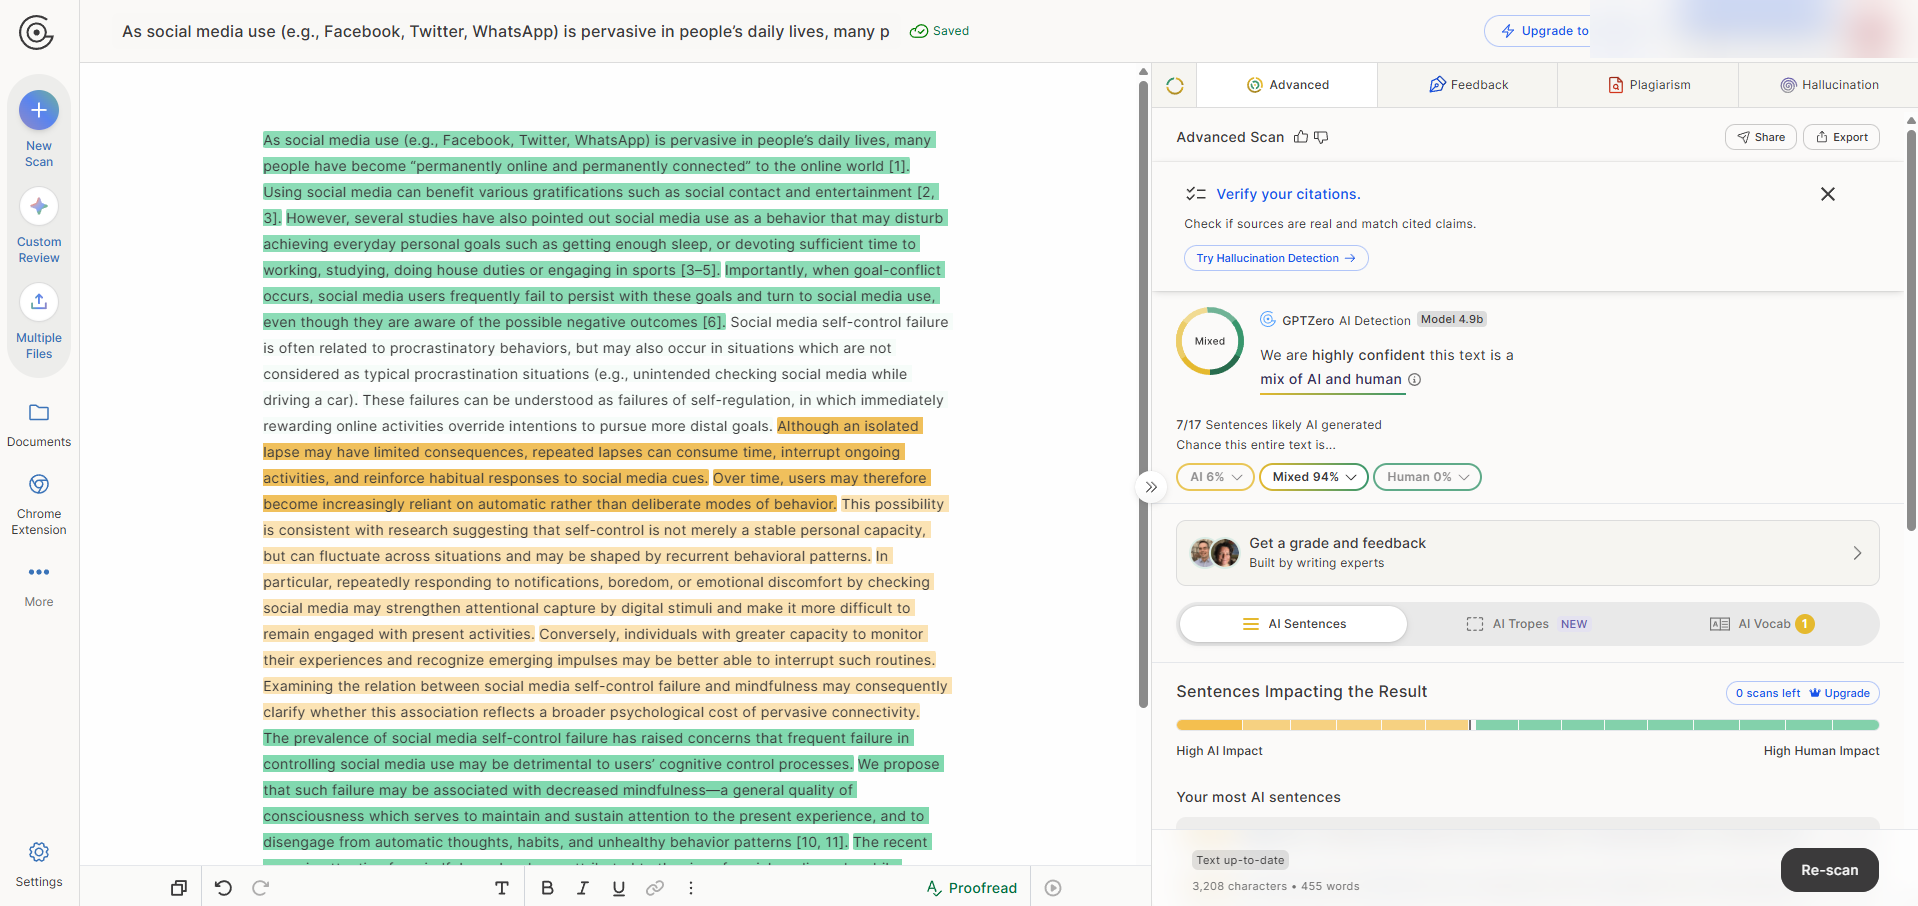
TextPulse Research کے ڈیٹیکٹر اتفاق مطالعے میں نو تجارتی AI ڈیٹیکٹرز نے وہی 90 علمی تحریریں پرکھیں۔ ان میں سے ایک 455 الفاظ کی ہائبرڈ تحریر تھی: آغاز اور اختتام انسان کے لکھے ہوئے، اور درمیان میں 168 الفاظ کا AI کا لکھا حصہ۔ GPTZero نے اس تحریر کو 41.2% AI قرار دیا، جبکہ انہی الفاظ پر باقی ٹولز کے فیصلے 0% سے 95.7% AI تک پھیلے ہوئے تھے۔ مکمل مقالہ، کارپس اور ہر ٹول کی اسکور میٹرکس TextPulse Research پر آزادانہ دستیاب ہے۔
اکثر پوچھے گئے سوالات
نہیں۔ GPTZero کے سپورٹ مرکز کے مطابق کمپنی نے detection کے لیے autumn 2023 سے perplexity اور burstiness کا استعمال بند کر دیا تھا، جب اس نے deep-learning classifier اختیار کیا۔ اس کا موجودہ technology page ایک sentence-by-sentence classification model بیان کرتا ہے اور ان میں سے کسی اصطلاح کا ذکر نہیں کرتا۔ یہ وضاحت اب بھی گردش میں ہے کیونکہ GPTZero کے اپنے 2023 explainer نے طریقہ بدلنے سے پہلے دونوں الفاظ کو مقبول بنایا تھا.
PhD in natural language processing, with years spent building NLP applications end to end. Moe works on text analysis: lexical and syntactic structure, and what separates machine-generated prose from human prose statistically. He has been experimenting with computational linguistics since the early days of NLTK, spaCy and WordNet, and still writes most of his tooling in Python.



