Turnitin مماثلت اسکور بمقابلہ AI اسکور: دو مختلف رپورٹس
مماثلت اسکور اور AI اسکور مختلف سوالات کے جواب دیتے ہیں، اس لیے ایک مقالہ ایک میں کم اور دوسرے میں زیادہ اسکور کر سکتا ہے، اور دونوں میں سے کوئی عدد غلط نہیں ہوتا۔ ہر ایک کیا ناپتا ہے، اسے کیا متحرک کرتا ہے، اور بلند عدد کیا ثابت کرتا ہے اور کیا ثابت نہیں کرتا۔

ایک رپورٹ پر دو اعداد درج ہوتے ہیں: 3 فیصد کا مماثلت اسکور اور 88 فیصد کا AI اسکور۔ فطری طور پر یہ سمجھا جاتا ہے کہ یہ دونوں ایک ہی چیز کی پیمائش کر رہے ہوں گے، اس لیے کم عدد کا مطلب یہ ہونا چاہیے کہ زیادہ عدد بھی غالباً غلط ہے۔ مگر معاملہ ایسا نہیں ہے۔ Turnitin similarity vs AI score دو الگ نظاموں کا تقابل ہے جو دو الگ چیزوں کی جانچ کرتے ہیں، اور ایک ہی جمع کرائی گئی تحریر ایک میں کم اور دوسرے میں زیادہ اسکور کر سکتی ہے، بغیر اس کے کہ دونوں میں سے کوئی عدد غلط ہو۔
یہ AI والے نظام سے پرانا ہے، اور اس مقصد سے بنایا گیا تھا کہ ایسے متن کو پکڑا جائے جو پہلے سے موجود کسی متن سے مشابہ ہو۔ یہ نیا ہے، اور اسی Similarity Report میں ایک خود مختار پیمائش کے طور پر شامل کیا گیا ہے، تاکہ اس بات کا اندازہ لگایا جا سکے کہ نثر مشینی طور پر تیار شدہ لگتی ہے یا نہیں، اس سے قطع نظر کہ وہ کسی چیز سے مماثلت رکھتی ہے یا نہیں۔ Turnitin کی اپنی دستاویزات کے مطابق، یہ دونوں مکمل طور پر آزاد ہیں اور ایک دوسرے پر اثر انداز نہیں ہوتے۔ اس مضمون کی باقی ہر بات بھی یہی بتاتی ہے۔

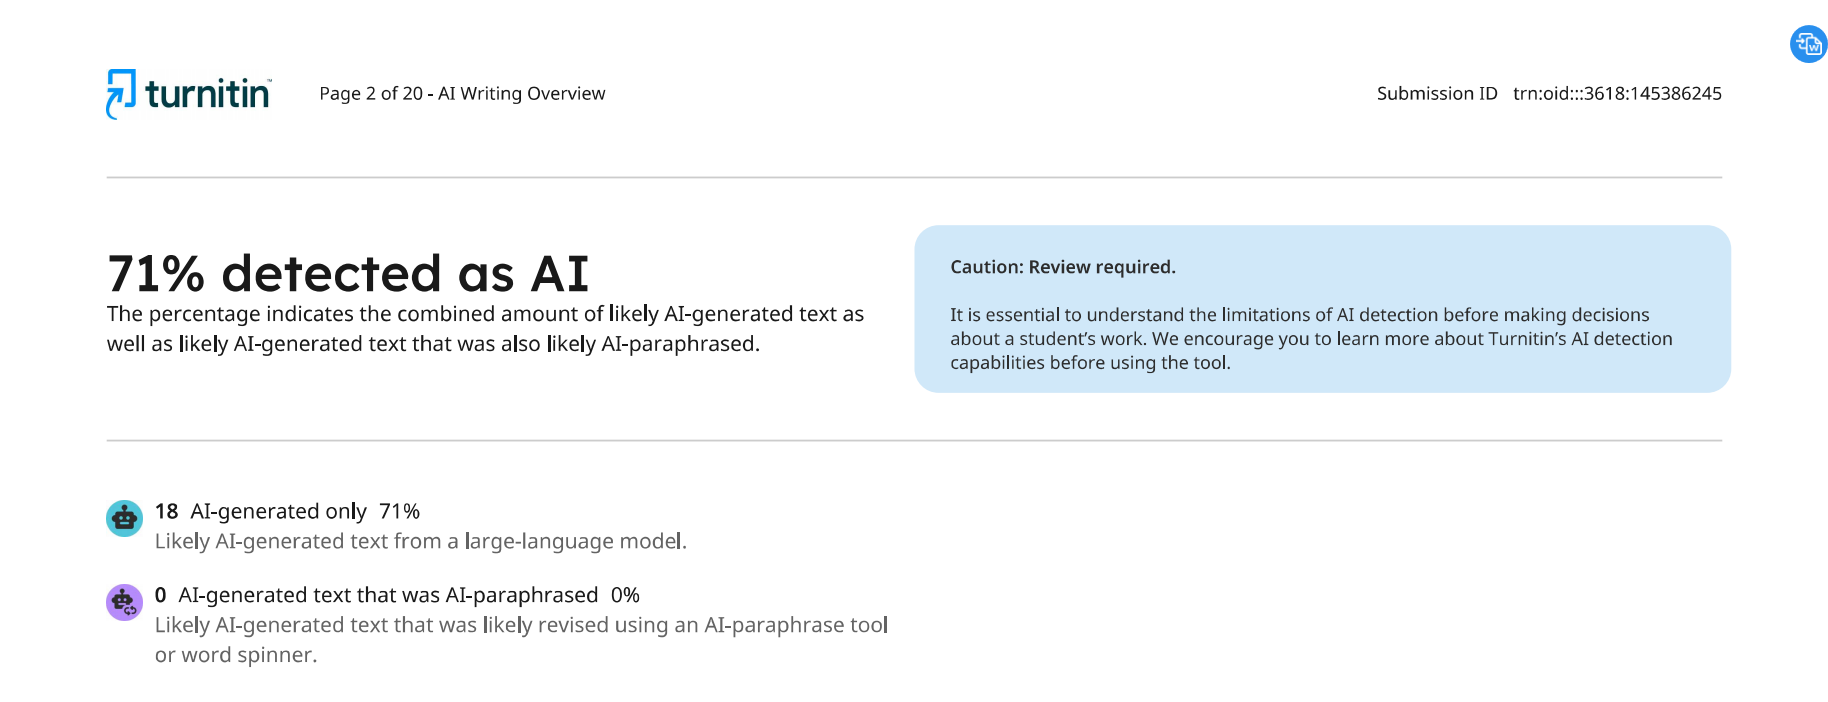
Turnitin Similarity بمقابلہ AI Score: ہر عدد کیا رپورٹ کرتا ہے
Turnitin ان دونوں کو ایک ہی نتیجے کے دو زاویے سمجھنے کے بجائے ایک ہی مصنوعات میں شامل دو مختلف پیمائشیں سمجھتا ہے۔ Similarity Report کسی جمع شدہ متن کا موازنہ ویب مواد، علمی اشاعتوں، اور پہلے جمع کرائے گئے طلبہ کے مقالوں کے ڈیٹا بیس سے کرتا ہے، اور اس بات کا فیصد واپس دیتا ہے کہ جمع شدہ متن کا کتنا حصہ اس ڈیٹا بیس میں پہلے سے موجود کسی متن سے ملتا ہے۔ AI writing detection بالکل مختلف ماڈل استعمال کرتی ہے، جو اسی رپورٹ میں ایک الگ اور مستقل score کے طور پر شامل ہوتا ہے، اور اسے اس بات کا اندازہ لگانے کے لیے تربیت دی گئی ہے کہ کسی عبارت کی نثر مشینی طور پر تیار شدہ تحریر سے کتنی مشابہ ہے، بغیر کسی بیرونی ڈیٹا بیس کے حوالے کے۔ Turnitin کا AI classifier اس عدد تک کیسے پہنچتا ہے اس کی تفصیلی کارکردگی الگ سے بیان کی گئی ہے، یہاں اہم بات یہ ہے کہ یہ اسی رپورٹ کے اندر موجود similarity engine سے مختلف سوال کا جواب دیتا ہے۔
Similarity Score دراصل کیا ناپتا ہے
Similarity ایک matching exercise ہے، کوئی judgment نہیں۔ Turnitin کی اپنی رہنمائی واضح طور پر کہتی ہے کہ یہ tool plagiarism کی جانچ نہیں کرتا۔ یہ overlap کو جانچتا ہے اور interpretation استاد پر چھوڑ دیتا ہے جو رپورٹ پڑھ رہا ہوتا ہے۔ درست طور پر الگ کیا گیا اقتباس، کسی پورے ذیلی شعبے میں مشترک methods-section کا فقرہ، journal میں ہر مقالے کی reference list کی طرح مرتب کی گئی reference list، یہ سب match کے طور پر درج ہو سکتے ہیں، کیونکہ system متن کی overlapping strings کو شمار کرتا ہے، اس بات کا فیصلہ نہیں کرتا کہ overlap جائز ہے یا نہیں۔
یہ بھی اسی لیے ہے کہ similarity score کا صفر ہونا اتنا ثابت نہیں کرتا جتنا بظاہر لگتا ہے۔ اس کا مطلب یہ ہے کہ جمع کرائی گئی تحریر میں متن کی کوئی لمبی، مسلسل عبارت نہیں جو Turnitin کے indexed sources میں کہیں اور موجود ہو۔ یہ اس بارے میں کچھ نہیں بتاتا کہ موجود جملے کیسے تیار کیے گئے، کیونکہ ایسا جملہ بنانا جو database میں کسی چیز سے نہ ملے، وہی مہارت نہیں ہے جو ایسا جملہ بنانا ہے جس کی language model نے پیش گوئی نہ کی ہو۔
اپنے مقالے کو انسانی انداز دیں
اپنے AI کی مدد سے تیار کردہ متن کو تبدیل کریں اور اسے انسانی محسوس ہونے دیں، اہم الفاظ یا حوالہ جات کو چھوئے بغیر۔
AI Score دراصل کیا ناپتا ہے
AI score کے پاس جانچنے کے لیے کوئی database نہیں ہوتا۔ ایک classifier جمع کرائی گئی نثر کو پڑھتا ہے اور، انسانی اور AI-generated writing کی مثالوں پر سیکھے گئے نمونوں کی بنیاد پر، اندازہ لگاتا ہے کہ وہ نثر کسی شخص کے بجائے model سے آنے کا کتنا امکان رکھتی ہے۔ اس اندازے کا اس بات سے کوئی تعلق نہیں کہ آیا وہ exact sentence پہلے کبھی کہیں ظاہر ہوا ہے یا نہیں۔ کوئی جملہ مکمل طور پر منفرد ہو سکتا ہے، اس submission تک کسی نے کبھی ٹائپ نہ کیا ہو، اور پھر بھی اگر اس کے لفظوں کے انتخاب اور ردھم language model کے پیدا کردہ نمونے کی پیروی کریں تو وہ شماریاتی طور پر AI output جیسا پڑھا جا سکتا ہے۔
یہی وہ شماریاتی میدان ہے جس کا مکمل احاطہ how AI detectors actually work کی وسیع تر وضاحت میں کیا گیا ہے: word-level predictability اور sentence-level rhythm، جو ایک document score میں یکجا ہو جاتے ہیں۔ Turnitin کا اس classifier کا ورژن proprietary ہے، لیکن بنیادی مفروضہ, کہ generated text عموماً انسانی تحریر کے مقابلے میں زیادہ شماریاتی طور پر عام ہوتا ہے, وہی ہے جو اس زمرے کے ہر tool کے پیچھے کام کر رہا ہے۔
| مشابہت کا اسکور | AI اسکور | |
|---|---|---|
| یہ کیا ناپتا ہے | جمع کرائی گئی تحریر کا کتنا حصہ دوسرے اشاریہ بند دستاویزات سے ملتا ہے | نثر کس حد تک اعداد و شمار کے لحاظ سے AI سے پیدا شدہ تحریر سے مشابہ ہے |
| اونچے عدد کو کیا چیز متحرک کرتی ہے | طویل اقتباسات، میدان سے متعلق عام فقرہ بندی، دوبارہ استعمال شدہ مواد، یا کسی سابقہ جمع کرائی گئی تحریر سے مطابقت | جملوں کی یکساں رفتار اور پوری دستاویز میں مسلسل قابلِ پیش گوئی لفظی انتخاب |
| اونچا عدد کیا ثابت نہیں کرتا | یہ کہ ملتا جلتا متن نامناسب طور پر استعمال کیا گیا تھا۔ درست طور پر حوالہ دیا گیا مواد بھی مطابقت کے طور پر درج ہو سکتا ہے۔ | یہ کہ کوئی ایک جملہ AI نے پیدا کیا تھا۔ درجہ بند کنندہ دستاویز کے مجموعی نمونے کو پڑھتا ہے، نہ کہ ایک سطر کو تنہا۔ |
کیا کسی مقالے میں 0 Percent مشابہت اور 90 Percent AI اسکور ہو سکتا ہے؟
جی ہاں، اور یہ امتزاج کوئی خرابی نہیں ہے۔ دونوں اسکور مختلف سوالات کا جواب دیتے ہیں، اس لیے بلند اور کم کے چاروں امتزاج ممکن ہیں، اور ہر ایک اس بات کے بارے میں کچھ مختلف بتاتا ہے کہ متن کیسے تیار کیا گیا تھا۔
- کم مشابہت، کم AI اسکور: عام اصل تحریر جو انسانی تنوع کے معمول کے ساتھ پڑھی بھی جاتی ہے۔ زیادہ تر حقیقی طالب علمانہ کاموں میں یہی عام صورت ہے۔
- کم مشابہت، بلند AI اسکور: اصل جملے، کہیں سے نقل نہیں کیے گئے، مگر اعداد و شمار کے لحاظ سے اس طرح قابلِ پیش گوئی کہ جیسے پیدا شدہ متن عموماً ہوتا ہے۔ غیر تدوین شدہ AI تحریر کی علامت، جسے کسی نے موجودہ ماخذ سے پیرا فریز نہیں کیا تھا۔
- بلند مشابہت، کم AI اسکور: ایسا متن جو کسی موجودہ انسانی تحریر شدہ ماخذ سے قریب سے ملتا ہو، مگر اس اعداد و شمار والی ہمواری کے بغیر جسے درجہ بند کنندہ پیداوار سے منسوب کرتا ہے۔ نقل شدہ متن، جسے پرانا آلہ پکڑ لیتا ہے، نیا نہیں۔
- بلند مشابہت، بلند AI اسکور: ایسا متن جو کسی موجودہ ماخذ سے ملتا ہو جو خود AI سے پیدا شدہ تھا، مثلاً پہلے جمع کرایا گیا AI سے لکھا ہوا مقالہ یا AI سے تیار شدہ متن کا کوئی صفحہ جو پہلے ہی کھلے ویب سے اشاریہ بند ہو چکا ہو۔
ان میں سے کسی بھی امتزاج کے لیے سافٹ ویئر کی طرف کوئی غیر معمولی چیز درکار نہیں ہوتی۔ یہ اس حقیقت سے نکلتا ہے کہ ایک نظام مماثلت کی جانچ کرتا ہے اور دوسرا نمونے کی، اور متن کا ایک حصہ ان میں سے کوئی ایک خصوصیت، دونوں، یا کوئی بھی نہیں رکھ سکتا ہے۔
ایک بلند AI اسکور کیا ثابت کرتا ہے، اور کیا ثابت نہیں کرتا
ایک بلند AI اسکور ایک شماریاتی تخمینہ ہے، متن سے نکالا گیا اعتراف نہیں۔ یہ بتاتا ہے کہ classifier کے سامنے موجود نثر اپنے لفظی انتخاب اور ردھم میں اس نوع کی تحریر سے مشابہت رکھتی ہے جسے model کو AI generation سے منسوب کرنا سکھایا گیا تھا۔ یہ کسی مخصوص جملے کو یقینی طور پر machine-written نہیں ٹھہراتا، اور یہ اس بارے میں کچھ نہیں جانتا کہ document حقیقت میں کیسے تیار ہوا تھا، صرف یہ کہ مکمل ہونے کے بعد وہ کیسا پڑھا جاتا ہے۔ TextPulse اپنے اعداد کے بارے میں بھی یہی مؤقف رکھتا ہے: وہ متن کے سامنے سے نکالا گیا estimated Human Score رپورٹ کرتا ہے، نہ کہ اس بارے میں کوئی فیصلہ کہ کس tool نے، اگر کسی نے، document کو چھوا تھا۔
ان میں سے کسی بھی عدد پر عملی ردعمل، کم similarity score ہو یا بلند AI score، ایک ہی ہے: اسے قریب سے دیکھنے کی وجہ سمجھیں، نہ کہ ایسی finding جسے پہلی نظر میں قبول یا رد کر دیا جائے۔ Drafts، notes، اور version history اس بات کی طرف اشارہ کرتے ہیں کہ document حقیقت میں کیسے لکھا گیا تھا، اس طرح جس طرح کوئی percentage کبھی نہیں کر سکتی، کسی بھی report پر۔ جو کوئی یہ جاننا چاہے کہ classifier اپنی ہی draft میں اصل میں کس چیز پر ردعمل دے رہا ہے، وہ رپورٹ بننے سے بہت پہلے free perplexity checker کے ذریعے خود وہی word-level pattern دیکھ سکتا ہے۔
TextPulse کی free tools collection ان دیگر statistical layers کا احاطہ کرتی ہے جن کی جانچ draft کو instructor تک پہنچنے سے پہلے کرنی چاہیے، صرف یہاں موازنہ کی گئی دو چیزوں کا نہیں۔
جب دونوں اعداد الگ کر دیے جائیں، تو اگلا سوال یہ ہوتا ہے کہ اچھا Turnitin score کس کو کہا جاتا ہے۔ دوسرے detector کے لیے جس سے students اکثر ملتے ہیں، GPTZero کیسے کام کرتا ہے اپنی الگ page پر بیان کیا گیا ہے۔
یہ دونوں اعداد اسی رپورٹ میں ایک دوسرے کے ساتھ موجود رہیں گے، اور جلدی میں پڑھنے والے لوگ انہیں ایک ہی عدد سمجھتے رہیں گے۔ یہ جاننا کہ ان میں سے ہر ایک دراصل کس سوال کا جواب دے رہا ہے، ایک الجھا دینے والے فیصدی جوڑے کو معلومات کے دو الگ، مفید حصوں میں بدل دیتا ہے۔
اکثر پوچھے گئے سوالات
Turnitin مماثلت بمقابلہ AI اسکور اس بات پر منحصر ہے کہ ہر ایک کیا جانچتا ہے۔ مماثلت اسکور یہ رپورٹ کرتا ہے کہ جمع کرائی گئی تحریر کا کتنا حصہ Turnitin کے ویب صفحات، اشاعتوں، اور سابقہ طلبہ کے مقالوں کے ڈیٹا بیس میں پہلے سے موجود متن سے ملتا ہے۔ AI اسکور ایک الگ، مستقل پیمائش ہے جو اندازہ لگاتی ہے کہ نثر کتنی حد تک مشینی طور پر پیدا شدہ معلوم ہوتی ہے، اور اس کا کسی بھی ڈیٹا بیس سے کوئی حوالہ نہیں ہوتا۔ Turnitin کی اپنی دستاویزات واضح کرتی ہیں کہ یہ دونوں اعداد ایک دوسرے کو متاثر نہیں کرتے۔
PhD in natural language processing, with years spent building NLP applications end to end. Moe works on text analysis: lexical and syntactic structure, and what separates machine-generated prose from human prose statistically. He has been experimenting with computational linguistics since the early days of NLTK, spaCy and WordNet, and still writes most of his tooling in Python.



