Turnitin Similarity Score مقابل AI Score: تقريران مختلفان
إن similarity score وAI score يجيبان عن سؤالين مختلفين، لذا قد يحصل paper على score منخفض في أحدهما ومرتفع في الآخر من دون أن يكون أي من الرقمين خاطئًا. ما الذي يقيسه كل منهما، وما الذي يثيره، وما الذي يثبته الرقم المرتفع وما الذي لا يثبته.

يظهر تقرير وفيه رقمان: درجة تشابه تبلغ 3% ودرجة ذكاء اصطناعي تبلغ 88%. والفهم الطبيعي هو أنهما لا بد أن يقيسا الشيء نفسه، لذا ينبغي أن يعني الرقم المنخفض أن الرقم المرتفع على الأرجح خاطئ أيضاً. لكن الأمر لا يعمل بهذه الطريقة. إن Turnitin similarity vs AI score هو مقارنة بين نظامين منفصلين يتحققان من شيئين منفصلين، ويمكن أن يحصل الإرسال على درجة منخفضة في أحدهما ودرجة مرتفعة في الآخر من دون أن يكون أي من الرقمين خطأ.
هذا النظام أقدم من نظام الذكاء الاصطناعي، وقد صُمم لاكتشاف النص الذي يطابق شيئاً موجوداً بالفعل. وهو أحدث، وأُضيف إلى Similarity Report نفسه بوصفه قياساً مستقلاً خاصاً به، وصُمم لتقدير ما إذا كان النثر يبدو مولداً آلياً بغض النظر عما إذا كان يطابق أي شيء أصلاً. وهما مستقلان تماماً ولا يؤثر أحدهما في الآخر، وفقاً لـ وثائق Turnitin نفسها. وكل ما عدا ذلك في هذا الجزء.

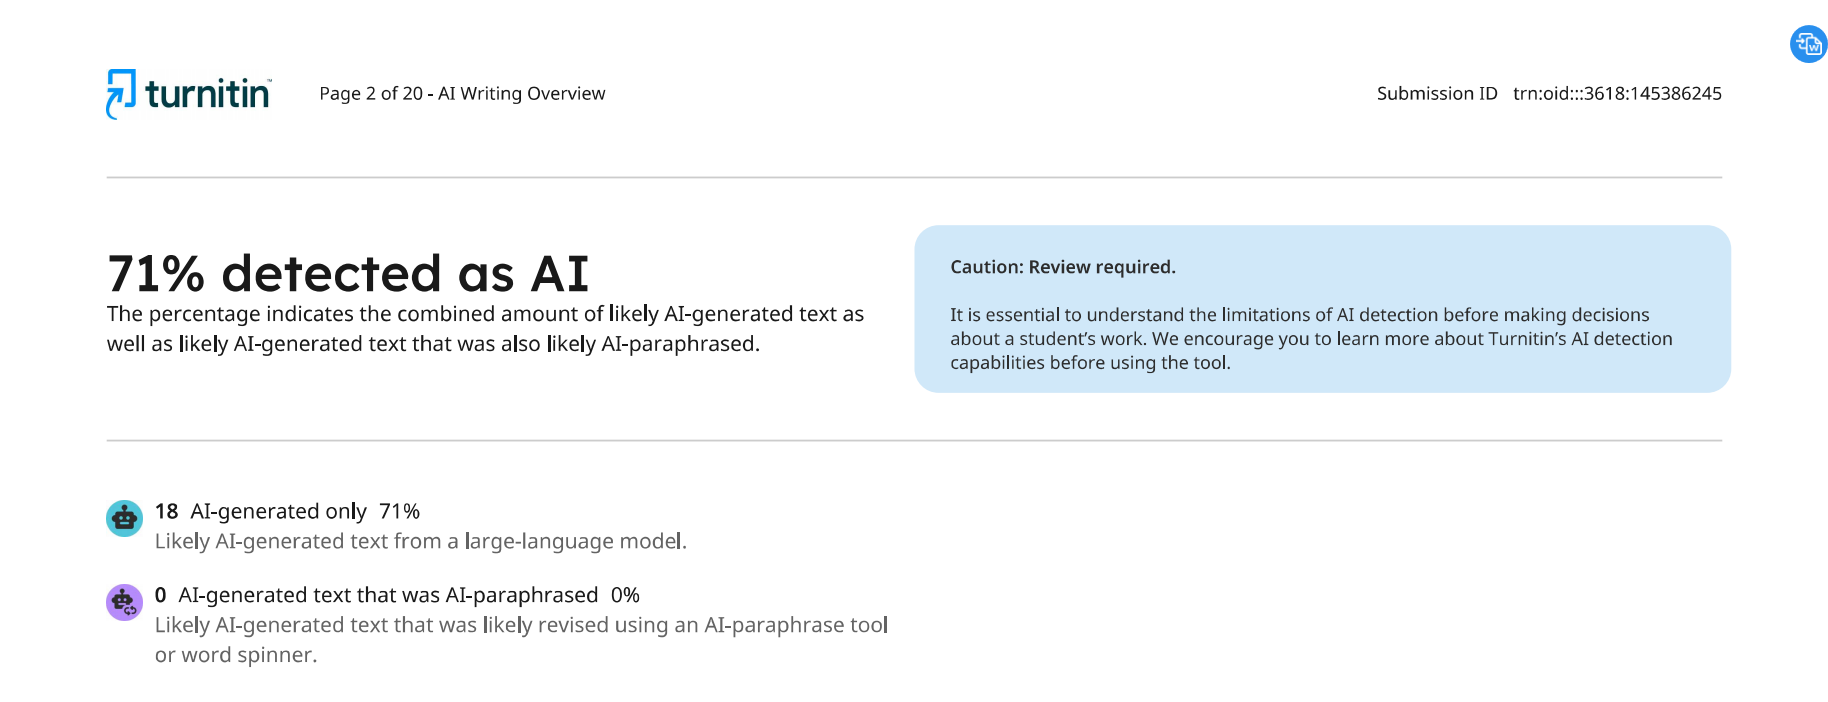
مقارنة Turnitin بين التشابه ودرجة الذكاء الاصطناعي: ما الذي يبلغه كل رقم
تعامل Turnitin هذين الأمرين بوصفهما قياسين مختلفين مدمجين في منتج واحد، لا بوصفهما وجهين لنتيجة واحدة. يقارن تقرير التشابه عملية التسليم بقاعدة بيانات من محتوى الويب والمنشورات الأكاديمية وأوراق الطلاب المقدمة سابقًا، ويعيد النسبة المئوية من نص عملية التسليم التي تطابق شيئًا موجودًا بالفعل في تلك القاعدة. أما اكتشاف الكتابة بالذكاء الاصطناعي فيشغل نموذجًا مختلفًا تمامًا، أضيف إلى التقرير نفسه بوصفه درجة مستقلة خاصة به، وهو نموذج مدرب على الحكم على مدى تشابه نثر مقطع ما مع الكتابة المولدة آليًا، من دون أي إحالة إلى أي قاعدة بيانات خارجية على الإطلاق. وتُعرض الآليات الأوسع لـ كيف يصل مصنف الذكاء الاصطناعي في Turnitin إلى تلك النتيجة في موضع منفصل، وما يهم هنا هو أنه يجيب عن سؤال مختلف عن محرك التشابه الموجود داخل التقرير نفسه.
ما الذي تقيسه درجة التشابه فعليًا
التشابه عملية مطابقة، لا حكم. وتوضح إرشادات Turnitin نفسها بجلاء أن الأداة لا تتحقق من الانتحال. إنها تتحقق من التداخل وتترك التفسير للمدرس الذي يقرأ التقرير. اقتباس موضوع بين علامتي تنصيص على نحو صحيح، أو عبارة في قسم المنهجية مشتركة عبر حقل فرعي كامل، أو قائمة مراجع منسقة بالطريقة التي تنسق بها كل ورقة في المجلة قائمة مراجعها: يمكن لكل ذلك أن يسجل بوصفه تطابقًا، لأن النظام يحسب سلاسل النص المتداخلة بدلًا من الحكم على ما إذا كان هذا التداخل مشروعًا.
ولهذا أيضًا فإن درجة التشابه الصفرية تثبت أقل مما يبدو. فهي تعني أن التسليم لا يحتوي على أي مقطع طويل متصل من النص موجود في مصادر Turnitin المفهرسة في مكان آخر. وهي لا تقول شيئًا عن كيفية إنتاج الجمل الموجودة فيه، لأن إنتاج جملة لا تطابق شيئًا في قاعدة بيانات ليس المهارة نفسها التي يتطلبها إنتاج جملة لن يتنبأ بها نموذج لغوي.
حوّل مقالك إلى صيغة بشرية
حوّل النص الذي استعنت فيه بالذكاء الاصطناعي واجعله يبدو بشريًا، من دون المساس بالكلمات المهمة أو الاستشهادات.
ما الذي تقيسه درجة الذكاء الاصطناعي فعليًا
لا تملك درجة الذكاء الاصطناعي قاعدة بيانات تُقاس عليها. يقرأ مصنف النثر المقدم ويقدّر، انطلاقًا من الأنماط التي تعلمها عبر أمثلة من الكتابة البشرية والكتابة المولدة بواسطة الذكاء الاصطناعي، مدى احتمال أن يكون هذا النثر قد صدر عن نموذج لا عن شخص. ولا يعتمد أي شيء في هذا التقدير على ما إذا كانت الجملة نفسها قد ظهرت من قبل في أي مكان. يمكن أن تكون الجملة فريدة تمامًا، ولم يكتبها أحد من قبل حتى هذا التسليم، ومع ذلك تُقرأ بوصفها نموذجية إحصائيًا لمخرجات الذكاء الاصطناعي إذا كانت اختياراتها اللفظية وإيقاعها تتبع النمط الذي يميل نموذج لغوي إلى إنتاجه.
هذا هو المجال الإحصائي نفسه الذي تغطيه بالكامل الرواية الأوسع في كيف تعمل كواشف الذكاء الاصطناعي فعليًا: قابلية التنبؤ على مستوى الكلمة وإيقاع الجملة، مدموجين في درجة واحدة للمستند. إن نسخة Turnitin من هذا المصنف مملوكة، لكن الفرضية الأساسية، وهي أن النص المولد يميل إلى أن يكون أكثر نمطية إحصائيًا من الكتابة البشرية، هي نفسها التي تعمل تحت كل أداة في هذه الفئة.
| درجة التشابه | درجة AI | |
|---|---|---|
| ما الذي تقيسه | مدى تطابق نص التسليم مع مستندات مفهرسة أخرى | مدى تشابه النثر مع الكتابة النموذجية إحصائيا التي ينتجها AI |
| ما الذي يرفع الرقم | الاقتباسات الطويلة، أو الصياغات الشائعة الخاصة بالمجال، أو المواد المعاد استخدامها، أو التطابق مع تسليم سابق | الإيقاع الموحد للجمل والاختيارات المتوقعة للكلمات على نحو ثابت عبر المستند |
| ما الذي لا يثبته الرقم المرتفع | أن النص المتطابق استُخدم على نحو غير صحيح. فالمادة المقتبسة على نحو صحيح قد تُسجل أيضا كتطابق. | أن أي جملة منفردة قد وُلدت بواسطة AI. فالمصنف يقرأ النمط العام للمستند، لا سطرا واحدا بمعزل عن غيره. |
هل يمكن أن تكون الورقة 0 Percent Similarity و 90 Percent AI Score؟
نعم، وهذا الجمع ليس خللا. فالدرجتان تجيبان عن سؤالين مختلفين، لذلك فإن جميع التركيبات الأربع بين الارتفاع والانخفاض ممكنة، وكل واحدة منها تشير إلى شيء مختلف بشأن كيفية إنتاج النص.
- تشابه منخفض، ودرجة AI منخفضة: كتابة أصلية عادية تقرأ أيضا مع تنوع بشري نموذجي. وهذه هي الحالة الشائعة في معظم أعمال الطلاب الأصيلة.
- تشابه منخفض، ودرجة AI مرتفعة: جمل أصلية، غير منسوخة من أي مكان، لكنها تقرأ بوصفها متوقعة إحصائيا على النحو الذي يميل إليه النص المولد. وهذه علامة الكتابة بواسطة AI غير المحررة التي لم يُعد أحد صياغتها من مصدر موجود.
- تشابه مرتفع، ودرجة AI منخفضة: نص يطابق عن قرب مصدرا موجودا مكتوبا بواسطة إنسان، من دون التسطيح الإحصائي الذي يربطه المصنف بالتوليد. نص منسوخ، التقطته الأداة الأقدم لا الأداة الأحدث.
- تشابه مرتفع، ودرجة AI مرتفعة: نص يطابق مصدرا موجودا كان هو نفسه مولدا بواسطة AI، مثل ورقة سبق تسليمها مكتوبة بواسطة AI أو صفحة من نص أنتجه AI ومفهرسة بالفعل من الويب المفتوح.
لا يتطلب أيٌّ من هذه التركيبات شيئًا غير مألوف من جهة البرمجيات. فهي تنتج عن كون أحد النظامين يتحقق من التطابق بينما يتحقق الآخر من النمط، ويمكن لقطعة من النص أن تحمل أيًّا من هاتين الخاصيتين، أو كلتيهما، أو لا تحمل أياً منهما.
ما الذي يثبته ارتفاع درجة AI، وما الذي لا يثبته
درجة AI المرتفعة هي تقدير إحصائي، وليست اعترافًا مستخرجًا من النص. وهي تقول إن النثر أمام المصنف يشبه، في اختياراته اللفظية وإيقاعه، ذلك النوع من الكتابة الذي دُرِّب النموذج على ربطه بتوليد AI. وهي لا تحدد جملة بعينها على أنها مكتوبة آليًا على نحو مؤكد، ولا تعرف شيئًا عن كيفية إنتاج المستند فعليًا، بل فقط عن كيفية قراءته بعد اكتماله. ويتخذ TextPulse الموقف نفسه بشأن أرقامه الخاصة: فما يورده هو Human Score تقديري محسوب من النص أمامه، لا حكمًا بشأن الأداة التي، إن وُجدت، قد مست المستند.
الاستجابة العملية لأيٍّ من الرقمين، درجة تشابه منخفضة أو درجة AI مرتفعة، هي نفسها: التعامل معه بوصفه سببًا للمراجعة الدقيقة، لا نتيجةً تُقبل أو تُرفض من النظرة الأولى. فالمسودات، والملاحظات، وسجل الإصدارات، تشهد على كيفية كتابة المستند فعليًا بطريقة لا يمكن لأي نسبة أن تفعلها، في أي تقرير. ومن أراد أن يعرف ما الذي يستجيب له المصنف فعليًا في مسودته الخاصة، فيمكنه أن يرى النمط نفسه على مستوى الكلمات بنفسه باستخدام free perplexity checker، قبل وقت طويل من توليد أي تقرير.
تغطي free tools collection الخاصة بـ TextPulse الطبقات الإحصائية الأخرى التي يجدر التحقق منها قبل أن تذهب أي مسودة إلى أي مدرس، وليس فقط المقارنتين المذكورتين هنا.
وبعد فصل الرقمين، يصبح السؤال التالي هو ما الذي يُعد درجة Turnitin جيدة. أما بالنسبة إلى الكاشف الآخر الذي يواجهه الطلاب غالبًا، فإن كيف يعمل GPTZero موضح في صفحته الخاصة.
سيستمران الرقمان في الظهور متجاورين في التقرير نفسه، وسيستمر الناس المستعجلون في قراءتهما على أنهما رقم واحد. إن معرفة السؤال الذي يجيب عنه كل واحد منهما فعليًا هي ما يحول زوجًا مربكًا من النسب المئوية إلى قطعتين منفصلتين ومفيدتين من المعلومات.
الأسئلة الشائعة
Turnitin similarity vs AI score يتوقف على ما الذي يفحصه كل منهما. similarity score يبين مقدار ما يطابقه submission من نص موجود بالفعل في قاعدة بيانات Turnitin الخاصة بصفحات الويب والمنشورات وأوراق الطلاب السابقة. أما AI score فهو قياس مستقل منفصل يقدّر مدى قراءة النثر بوصفه مولدًا آليًا، من دون أي إحالة إلى أي قاعدة بيانات على الإطلاق. وتذكر وثائق Turnitin نفسها أن الرقمين لا يؤثر أحدهما في الآخر.
PhD in natural language processing, with years spent building NLP applications end to end. Moe works on text analysis: lexical and syntactic structure, and what separates machine-generated prose from human prose statistically. He has been experimenting with computational linguistics since the early days of NLTK, spaCy and WordNet, and still writes most of his tooling in Python.



