Turnitin Similarity Score বনাম AI Score: দুটি ভিন্ন প্রতিবেদন
একটি similarity score এবং একটি AI score ভিন্ন প্রশ্নের উত্তর দেয়, তাই একটি paper একটিতে কম এবং অন্যটিতে বেশি score করতে পারে, অথচ কোনো সংখ্যাই ভুল নাও হতে পারে। প্রতিটি কী মাপে, কী দ্বারা সক্রিয় হয়, এবং উচ্চ সংখ্যা কী প্রমাণ করে ও কী প্রমাণ করে না।

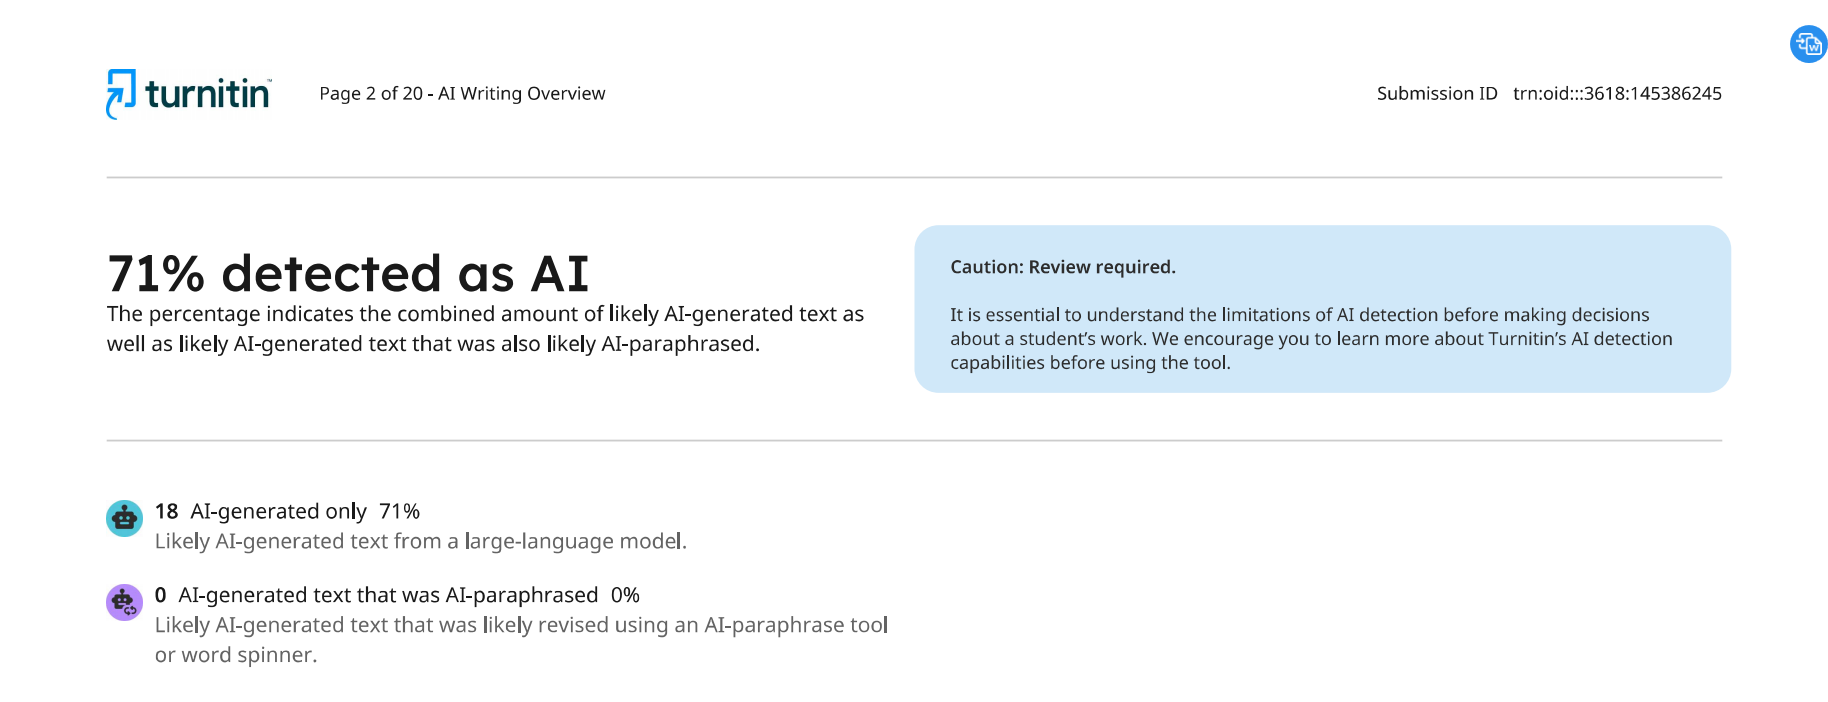
একটি প্রতিবেদনে দুটি সংখ্যা থাকে: 3 শতাংশের একটি similarity score এবং 88 শতাংশের একটি AI score। স্বাভাবিকভাবে মনে হতে পারে, এগুলো নিশ্চয়ই একই জিনিস মাপছে, তাই কম সংখ্যাটির মানে হবে উচ্চ সংখ্যাটিও সম্ভবত ভুল। কিন্তু বিষয়টি তেমন নয়। Turnitin similarity vs AI score হলো দুটি পৃথক সিস্টেমের তুলনা, যেগুলি দুটি পৃথক বিষয় পরীক্ষা করে, এবং একটি জমা low on one and high on the other হতে পারে, কোনো সংখ্যাই ভুল না হয়েও।
এটি AI one-এর চেয়ে পুরোনো, এমন পাঠ্য ধরার জন্য তৈরি যা ইতিমধ্যে বিদ্যমান কিছুর সঙ্গে মিলে যায়। এটি নতুন, একই Similarity Report-এ নিজস্ব স্বাধীন পরিমাপ হিসেবে যোগ করা হয়েছে, যা অনুমান করে গদ্যটি machine-generated কি না, তা কোনো কিছুর সঙ্গে মেলে কি না, তা নির্বিশেষে। Turnitin's own documentation অনুযায়ী, এগুলি সম্পূর্ণ স্বাধীন এবং একে অপরকে প্রভাবিত করে না। এই অংশের বাকি সবকিছু।

Turnitin Similarity বনাম AI Score: প্রতিটি সংখ্যা কী প্রতিবেদন করে
Turnitin এই দুটিকে একটিমাত্র ফলাফলের দুটি দৃষ্টিভঙ্গি না ধরে, এক পণ্যের মধ্যে সংযুক্ত দুটি ভিন্ন পরিমাপ হিসেবে বিবেচনা করে। Similarity Report একটি জমা দেওয়া লেখা web content, academic publications, এবং পূর্বে জমা দেওয়া student papers এর database এর সঙ্গে তুলনা করে, এবং submission এর text এর যে শতাংশ ইতিমধ্যে সেই database এ থাকা কিছুর সঙ্গে মেলে তা ফেরত দেয়। AI writing detection সম্পূর্ণ ভিন্ন একটি model চালায়, যা একই report এ তার নিজস্ব স্বাধীন score হিসেবে যোগ করা থাকে, এবং যা কোনো passage এর prose কতটা machine-generated writing এর সঙ্গে সাদৃশ্যপূর্ণ তা বিচার করার জন্য প্রশিক্ষিত, কোনো external database এর প্রতি একেবারেই কোনো reference ছাড়াই। Turnitin এর AI classifier কীভাবে সেই সংখ্যায় পৌঁছায় তার পূর্ণতর mechanics আলাদাভাবে আলোচিত হয়েছে, এখানে গুরুত্বপূর্ণ বিষয় হলো এটি একই report এর ভেতরে থাকা similarity engine এর থেকে ভিন্ন একটি প্রশ্নের উত্তর দেয়।
Similarity Score আসলে কী পরিমাপ করে
Similarity হলো একটি matching exercise, কোনো judgment নয়। Turnitin এর নিজস্ব guidance স্পষ্টভাবে বলে যে tool টি plagiarism পরীক্ষা করে না। এটি overlap পরীক্ষা করে এবং interpretation instructor এর ওপর ছেড়ে দেয়, যিনি report পড়ছেন। সঠিকভাবে আলাদা করা একটি quotation, একটি methods-section phrase যা একটি সম্পূর্ণ subfield জুড়ে ভাগাভাগি হয়, একটি reference list যা journal এর প্রতিটি paper যেভাবে তার reference list format করে সেইভাবে format করা, এগুলোর সবই match হিসেবে register করতে পারে, কারণ system টি overlap বৈধ কি না তা বিচার না করে text এর overlapping strings গণনা করে।
এটিও কারণ যে শূন্য similarity score যতটা মনে হয়, ততটা প্রমাণ করে না। এর অর্থ হলো, জমা দেওয়া লেখাটিতে Turnitin-এর indexed sources-এ অন্য কোথাও পাওয়া যায় এমন দীর্ঘ, অবিচ্ছিন্ন কোনো পাঠাংশ নেই। এটি এই বিষয়ে কিছুই বলে না যে সেখানে থাকা বাক্যগুলো কীভাবে তৈরি হয়েছে, কারণ database-এ কোনো কিছুর সঙ্গেই মেলে না এমন একটি বাক্য তৈরি করা, এমন একটি বাক্য তৈরি করার মতো দক্ষতা নয়, যা একটি language model পূর্বানুমান করত না।
আপনার নিজস্ব পেপারকে মানবসদৃশ করুন
আপনার AI-সহায়তাপ্রাপ্ত লেখাকে রূপান্তর করুন এবং গুরুত্বপূর্ণ শব্দ বা উদ্ধৃতি স্পর্শ না করে সেটিকে মানবসদৃশ শোনান।
AI Score আসলে কী পরিমাপ করে
AI score-এর সঙ্গে তুলনা করার জন্য কোনো database নেই। একটি classifier জমা দেওয়া গদ্য পড়ে এবং, মানব ও AI-generated লেখার উদাহরণ জুড়ে সে যে pattern শিখেছে তার ভিত্তিতে, সেই গদ্যটি কোনো ব্যক্তির তুলনায় একটি model থেকে আসার সম্ভাবনা কতটা, তা অনুমান করে। সেই অনুমানটি এই বিষয়ে নির্ভর করে না যে নির্দিষ্ট বাক্যটি আগে কখনও কোথাও দেখা গেছে কি না। একটি বাক্য সম্পূর্ণ অনন্য হতে পারে, এই submission পর্যন্ত কেউ কখনও টাইপ না-ও করে থাকতে পারে, তবু যদি তার শব্দচয়ন ও ছন্দ একটি language model সাধারণত যে pattern তৈরি করে তার অনুসরণ করে, তবে সেটি পরিসংখ্যানগতভাবে AI output-এর সাধারণ উদাহরণ হিসেবে পড়া যেতে পারে।
এটি একই পরিসংখ্যানগত ক্ষেত্র, যা how AI detectors actually work সম্পর্কে বিস্তৃত আলোচনায় সম্পূর্ণভাবে অন্তর্ভুক্ত হয়েছে, শব্দ-স্তরের predictability এবং বাক্য-স্তরের ছন্দ, যা একত্রে একটি document score-এ রূপ নেয়। Turnitin-এর classifier-এর সংস্করণটি proprietary, কিন্তু অন্তর্নিহিত ধারণাটি, যে generated text মানব লেখার তুলনায় পরিসংখ্যানগতভাবে বেশি সাধারণ হতে থাকে, সেটিই এই শ্রেণির প্রতিটি tool-এর নিচে কাজ করে।
| সাদৃশ্য স্কোর | AI স্কোর | |
|---|---|---|
| এটি কী পরিমাপ করে | জমা দেওয়া লেখার কতটা অংশ অন্যান্য সূচিবদ্ধ নথির সঙ্গে মেলে | গদ্যটি পরিসংখ্যানগতভাবে সাধারণ AI-উৎপাদিত লেখার সঙ্গে কতটা ঘনিষ্ঠভাবে সাদৃশ্যপূর্ণ |
| উচ্চ সংখ্যা কী দ্বারা সক্রিয় হয় | দীর্ঘ উদ্ধৃতি, ক্ষেত্র-নির্দিষ্ট সাধারণ বাক্যাংশ, পুনঃব্যবহৃত উপাদান, অথবা পূর্ববর্তী জমাদানের সঙ্গে মিল | সমগ্র নথিজুড়ে একরূপ বাক্যছন্দ এবং ধারাবাহিকভাবে পূর্বানুমেয় শব্দচয়ন |
| উচ্চ সংখ্যা কী প্রমাণ করে না | যে মেলানো পাঠ্যটি অনুপযুক্তভাবে ব্যবহৃত হয়েছিল। সঠিকভাবে উদ্ধৃত উপাদানও মিল হিসেবে নথিভুক্ত হতে পারে। | যে কোনো একক বাক্য AI দ্বারা উৎপন্ন হয়েছিল। শ্রেণিবিন্যাসকারী নথির সামগ্রিক ধরণ পড়ে, একক লাইনকে বিচ্ছিন্নভাবে নয়। |
একটি প্রবন্ধে কি 0 শতাংশ সাদৃশ্য এবং 90 শতাংশ AI স্কোর থাকতে পারে?
হ্যাঁ, এবং এই সংমিশ্রণটি কোনো ত্রুটি নয়। দুটি স্কোর ভিন্ন প্রশ্নের উত্তর দেয়, তাই উচ্চ এবং নিম্নের চারটি সংমিশ্রণই সম্ভব, এবং প্রতিটি সংমিশ্রণ পাঠ্যটি কীভাবে তৈরি হয়েছে সে সম্পর্কে ভিন্ন কিছু নির্দেশ করে।
- নিম্ন সাদৃশ্য, নিম্ন AI স্কোর: সাধারণ মৌলিক লেখা, যা মানবিক স্বাভাবিক বৈচিত্র্যসহও পড়া যায়। অধিকাংশ প্রকৃত শিক্ষার্থীর কাজের ক্ষেত্রে এটি সাধারণ অবস্থা।
- নিম্ন সাদৃশ্য, উচ্চ AI স্কোর: মৌলিক বাক্য, কোথাও থেকে অনুলিপি করা নয়, কিন্তু পরিসংখ্যানগতভাবে পূর্বানুমেয়ভাবে পড়া যায়, যেমন উৎপন্ন পাঠ্য সাধারণত পড়ে। এটি অসম্পাদিত AI লেখার বৈশিষ্ট্য, যা কেউ বিদ্যমান কোনো উৎস থেকে পুনর্বাক্যায়ন করেনি।
- উচ্চ সাদৃশ্য, নিম্ন AI স্কোর: পাঠ্যটি বিদ্যমান মানব-রচিত উৎসের সঙ্গে ঘনিষ্ঠভাবে মেলে, কিন্তু শ্রেণিবিন্যাসকারী যে পরিসংখ্যানগত সমতলতা উৎপাদনের সঙ্গে যুক্ত করে তা নেই। অনুলিপিকৃত পাঠ্য, যা নতুন সরঞ্জামের বদলে পুরোনো সরঞ্জাম দ্বারা ধরা পড়েছে।
- উচ্চ সাদৃশ্য, উচ্চ AI স্কোর: পাঠ্যটি এমন একটি বিদ্যমান উৎসের সঙ্গে মেলে, যা নিজেই AI-উৎপাদিত ছিল, যেমন পূর্বে জমা দেওয়া AI-লিখিত প্রবন্ধ বা AI-উৎপাদিত পাঠ্যের একটি পৃষ্ঠা, যা ইতিমধ্যে উন্মুক্ত ওয়েব থেকে সূচিবদ্ধ হয়েছে।
এই সংমিশ্রণগুলোর কোনোটির জন্যই সফটওয়্যার দিক থেকে কোনো অস্বাভাবিক কিছুর প্রয়োজন হয় না। এগুলো এই সত্য থেকে উদ্ভূত যে একটি সিস্টেম মিল খোঁজে এবং অন্যটি একটি প্যাটার্ন খোঁজে, আর একটি পাঠ্যাংশ এই দুই বৈশিষ্ট্যের যেকোনো একটি, উভয়টি, অথবা কোনোটিই বহন করতে পারে।
একটি উচ্চ AI স্কোর কী প্রমাণ করে, এবং কী প্রমাণ করে না
একটি উচ্চ AI স্কোর একটি পরিসংখ্যানগত অনুমান, পাঠ্য থেকে বের করে আনা কোনো স্বীকারোক্তি নয়। এটি বলে যে শ্রেণিবিন্যাসকারীর সামনে থাকা গদ্যটি, তার শব্দচয়ন ও ছন্দে, সেই ধরনের লেখার সঙ্গে সাদৃশ্যপূর্ণ, যেটিকে মডেলটি AI উৎপাদনের সঙ্গে যুক্ত করতে প্রশিক্ষিত হয়েছিল। এটি কোনো নির্দিষ্ট বাক্যকে নিশ্চিতভাবে যন্ত্রলিখিত বলে শনাক্ত করে না, এবং নথিটি বাস্তবে কীভাবে তৈরি হয়েছে সে সম্পর্কে কিছুই জানে না, কেবল এটি সম্পূর্ণ হওয়ার পর কেমন পড়ে তা জানে। TextPulse নিজস্ব সংখ্যাগুলোর বিষয়ে একই অবস্থান নেয়, এটি যা জানায় তা হলো তার সামনে থাকা পাঠ্য থেকে গণনা করা একটি আনুমানিক Human Score, কোন টুল, যদি কোনোটি থাকে, নথিটিকে স্পর্শ করেছে সে বিষয়ে কোনো রায় নয়।
এই দুই সংখ্যার যেকোনোটির ক্ষেত্রেই, একটি নিম্ন similarity score বা একটি উচ্চ AI score, ব্যবহারিক প্রতিক্রিয়া একই, এটিকে আরও কাছ থেকে দেখার কারণ হিসেবে নিন, চোখের দেখায় মেনে নেওয়া বা বাতিল করার মতো সিদ্ধান্ত হিসেবে নয়। খসড়া, নোট, এবং version history একটি নথি বাস্তবে কীভাবে লেখা হয়েছে তা এমনভাবে জানায়, যা কোনো শতাংশ কখনোই জানাতে পারে না, উভয় প্রতিবেদনের ক্ষেত্রেই। কোনো classifier আসলে তাদের নিজস্ব খসড়ায় কীতে প্রতিক্রিয়া দিচ্ছে তা জানতে আগ্রহী যে কেউ, কোনো report তৈরি হওয়ার অনেক আগেই, একটি free perplexity checker দিয়ে নিজেরাই একই শব্দস্তরের pattern দেখতে পারেন।
TextPulse-এর free tools collection খসড়াটি কোনো instructor-এর কাছে যাওয়ার আগে যাচাই করার মতো অন্যান্য statistical layer-গুলোও অন্তর্ভুক্ত করে, এখানে তুলনা করা দুটি কেবল সেগুলো নয়।
দুটি সংখ্যা আলাদা হয়ে গেলে, পরবর্তী প্রশ্ন হলো কীকে একটি ভালো Turnitin score ধরা হয়। শিক্ষার্থীরা সবচেয়ে বেশি যে অন্য detector-এর মুখোমুখি হয়, তার ক্ষেত্রে GPTZero কীভাবে কাজ করে তা আলাদা পৃষ্ঠায় ব্যাখ্যা করা হয়েছে।
দুটি সংখ্যা একই প্রতিবেদনে পাশাপাশি অবস্থান করতে থাকবে, এবং তাড়াহুড়ো করা মানুষ এগুলিকে একটিই সংখ্যা হিসেবে পড়তে থাকবে। কোন প্রশ্নের উত্তর প্রতিটি সংখ্যা আসলে দিচ্ছে, তা জানা থাকলে বিভ্রান্তিকর দুটি শতাংশকে দুটি পৃথক, উপযোগী তথ্যখণ্ডে রূপান্তর করা যায়।
সচরাচর জিজ্ঞাসিত প্রশ্ন
Turnitin similarity বনাম AI score নির্ভর করে প্রতিটি কী পরীক্ষা করে তার ওপর। similarity score জানায়, একটি submission-এর কতটা অংশ Turnitin-এর web pages, publications, এবং past student papers-এর database-এ আগে থেকেই থাকা text-এর সঙ্গে মেলে। AI score একটি পৃথক, স্বতন্ত্র measurement, যা অনুমান করে prose কতটা machine-generated-এর মতো পড়ে, এবং এতে কোনো database-এর প্রতি কোনো reference থাকে না। Turnitin-এর নিজস্ব documentation বলে, এই দুটি figure একে অপরকে প্রভাবিত করে না.
PhD in natural language processing, with years spent building NLP applications end to end. Moe works on text analysis: lexical and syntactic structure, and what separates machine-generated prose from human prose statistically. He has been experimenting with computational linguistics since the early days of NLTK, spaCy and WordNet, and still writes most of his tooling in Python.



