Turnitin Similarity Score so với AI Score: Hai báo cáo khác nhau
Điểm tương đồng và điểm AI trả lời những câu hỏi khác nhau, vì vậy một bài có thể có điểm thấp ở một số và cao ở số kia mà không số nào sai. Mỗi số đo lường gì, điều gì kích hoạt nó, và một con số cao chứng minh điều gì và không chứng minh điều gì.

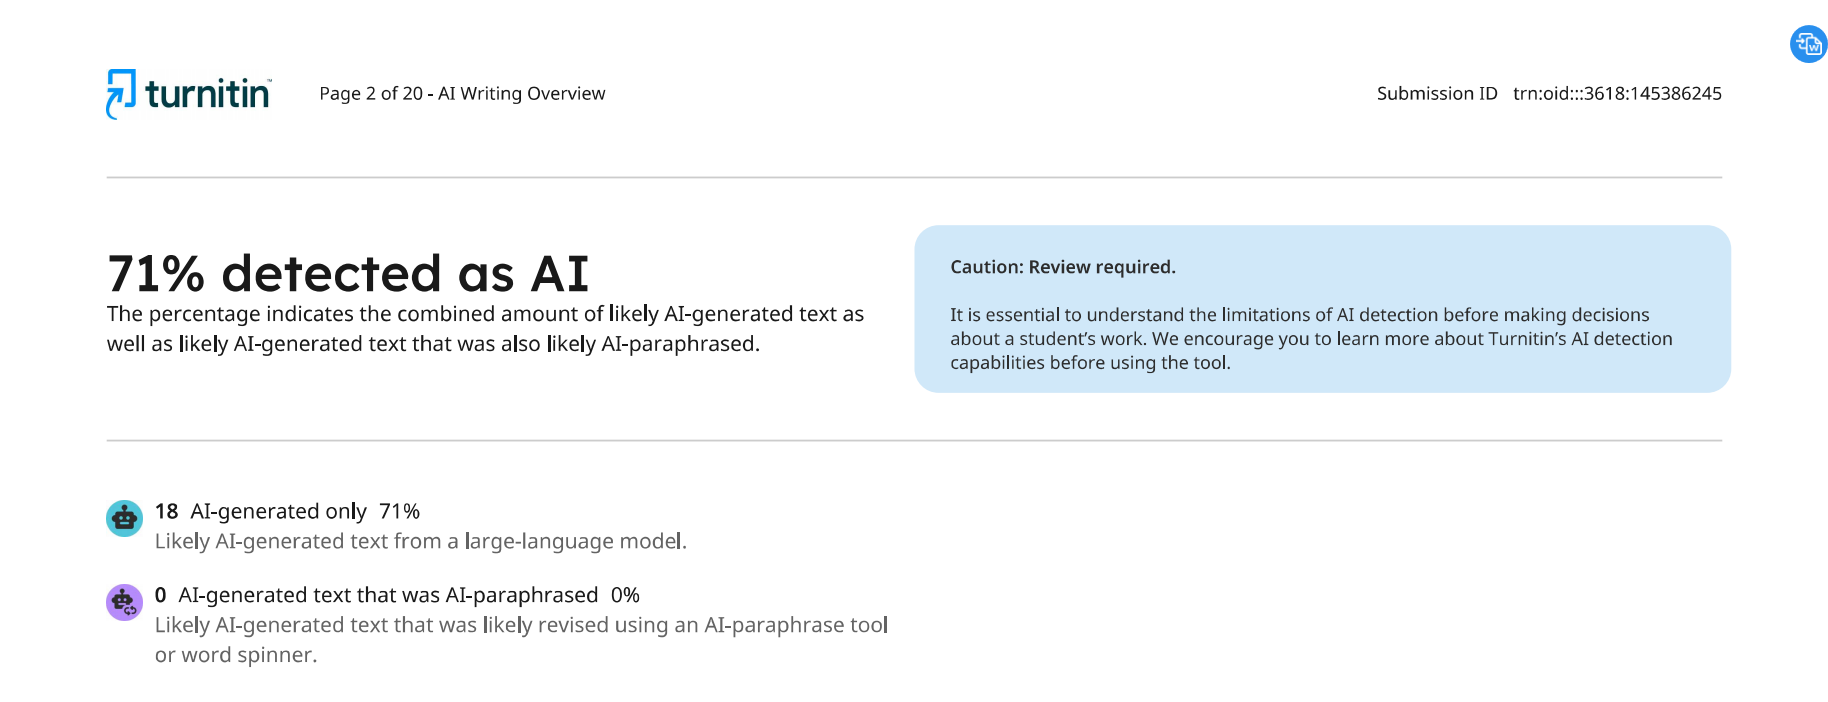
Một báo cáo xuất hiện với hai con số: điểm tương đồng là 3 phần trăm và điểm AI là 88 phần trăm. Cách hiểu tự nhiên là chúng hẳn đang đo cùng một thứ, nên con số thấp phải có nghĩa là con số cao cũng có lẽ sai. Nhưng không phải vậy. Turnitin similarity vs AI score là sự so sánh giữa hai hệ thống riêng biệt, kiểm tra hai thứ riêng biệt, và một bài nộp có thể có điểm thấp ở hệ thống này và điểm cao ở hệ thống kia mà không có con số nào là sai.
Nó ra đời sớm hơn hệ thống AI, được xây dựng để phát hiện văn bản khớp với một nội dung đã tồn tại. Nó mới hơn, được bổ sung vào cùng Similarity Report như một phép đo độc lập riêng, được xây dựng để ước tính liệu văn xuôi có đọc như do máy tạo ra hay không, bất kể nó có khớp với bất cứ thứ gì hay không. Theo tài liệu chính thức của Turnitin, hai hệ thống này hoàn toàn độc lập và không ảnh hưởng lẫn nhau. Mọi điều khác trong phần này.

Turnitin Similarity so với AI Score: Mỗi con số báo cáo điều gì
Turnitin xem hai chỉ số này là hai phép đo khác nhau được gộp trong cùng một sản phẩm, chứ không phải hai cách nhìn của cùng một kết quả. Similarity Report so sánh một bài nộp với cơ sở dữ liệu gồm nội dung web, các ấn phẩm học thuật và các bài luận của sinh viên đã nộp trước đó, rồi trả về tỷ lệ phần trăm văn bản của bài nộp trùng khớp với một nội dung nào đó đã có trong cơ sở dữ liệu ấy. Phát hiện bài viết AI vận hành bằng một mô hình hoàn toàn khác, được thêm vào cùng báo cáo đó như một điểm số độc lập, được huấn luyện để đánh giá mức độ văn xuôi của một đoạn văn giống với văn bản do máy tạo ra đến đâu, hoàn toàn không tham chiếu đến bất kỳ cơ sở dữ liệu bên ngoài nào. Cơ chế đầy đủ hơn của cách bộ phân loại AI của Turnitin đi đến con số đó được trình bày riêng, điều quan trọng ở đây là nó trả lời một câu hỏi khác với công cụ similarity nằm trong cùng báo cáo.
Similarity Score thực sự đo lường điều gì
Similarity là một phép đối chiếu, không phải một phán đoán. Hướng dẫn chính thức của Turnitin nói rõ rằng công cụ này không kiểm tra đạo văn. Nó kiểm tra sự trùng lặp và để cho giảng viên đọc báo cáo tự diễn giải. Một trích dẫn được đặt đúng quy cách, một cụm từ trong phần phương pháp được dùng chung trên toàn bộ một phân ngành, một danh mục tài liệu tham khảo được định dạng theo cách mà mọi bài báo trong tạp chí đều định dạng danh mục tài liệu tham khảo của mình, tất cả đều có thể được ghi nhận là một kết quả khớp, vì hệ thống đếm các chuỗi văn bản chồng lấn thay vì phán xét liệu sự chồng lấn đó có hợp lệ hay không.
Đó cũng là lý do vì sao điểm tương đồng bằng không chứng minh ít hơn vẻ bề ngoài của nó. Nó có nghĩa là bài nộp không chứa một đoạn văn dài, liền mạch nào được tìm thấy ở các nguồn đã được lập chỉ mục khác của Turnitin. Nó không nói gì về cách các câu có trong đó được tạo ra, vì việc tạo ra một câu không khớp với bất cứ điều gì trong cơ sở dữ liệu không phải là cùng một kỹ năng với việc tạo ra một câu mà một mô hình ngôn ngữ sẽ không dự đoán được.
Nhân hóa bài viết của bạn
Biến đổi văn bản có hỗ trợ AI của bạn và làm cho nó nghe tự nhiên như do con người viết, mà không chạm vào các từ quan trọng hoặc trích dẫn.
Điểm AI Thực Sự Đo Lường Điều Gì
Điểm AI không có cơ sở dữ liệu nào để đối chiếu. Một bộ phân loại đọc đoạn văn được nộp và ước tính, từ các mẫu mà nó đã học được trên các ví dụ về văn bản do con người và AI tạo ra, mức độ có khả năng đoạn văn đó xuất phát từ một mô hình hơn là từ một người. Không có gì trong ước tính đó phụ thuộc vào việc câu chính xác ấy đã từng xuất hiện ở đâu đó trước đây hay chưa. Một câu có thể hoàn toàn độc nhất, chưa từng được ai gõ cho đến bài nộp này, nhưng vẫn được đọc là điển hình về mặt thống kê của đầu ra AI nếu lựa chọn từ ngữ và nhịp điệu của nó đi theo mẫu mà một mô hình ngôn ngữ có xu hướng tạo ra.
Đây cũng là cùng một vùng thống kê được trình bày đầy đủ trong phần tường thuật rộng hơn về cách các bộ phát hiện AI thực sự hoạt động: khả năng dự đoán ở cấp độ từ và nhịp điệu ở cấp độ câu, được gộp lại thành một điểm số của tài liệu. Phiên bản bộ phân loại đó của Turnitin là độc quyền, nhưng tiền đề nền tảng, rằng văn bản được tạo ra có xu hướng điển hình về mặt thống kê hơn văn bản do con người viết, là cùng một tiền đề vận hành bên dưới mọi công cụ trong nhóm này.
| Điểm tương đồng | Điểm AI | |
|---|---|---|
| Điều nó đo lường | Mức độ văn bản của bài nộp khớp với các tài liệu đã được lập chỉ mục khác | Mức độ văn xuôi giống với kiểu viết do AI tạo ra thường gặp về mặt thống kê |
| Điều gì kích hoạt một con số cao | Các trích dẫn dài, cách diễn đạt phổ biến trong lĩnh vực, nội dung được dùng lại, hoặc sự khớp với một bài nộp trước đó | Nhịp câu đồng đều và lựa chọn từ ngữ luôn có thể dự đoán trên toàn bộ tài liệu |
| Điều mà một con số cao không chứng minh | Rằng đoạn văn bản khớp đã được sử dụng không đúng cách. Tài liệu được trích dẫn đúng cách vẫn có thể được ghi nhận là một sự khớp. | Rằng bất kỳ câu đơn lẻ nào được tạo ra bởi AI. Bộ phân loại đọc mô hình tổng thể của tài liệu, không phải một dòng riêng lẻ. |
Một bài viết có thể có 0 Percent Similarity và 90 Percent AI Score không?
Có, và sự kết hợp này không phải là lỗi. Hai điểm số trả lời những câu hỏi khác nhau, vì vậy cả bốn tổ hợp cao và thấp đều có thể xảy ra, và mỗi tổ hợp hàm ý một điều khác nhau về cách văn bản được tạo ra.
- Tương đồng thấp, điểm AI thấp: bài viết nguyên bản thông thường, đồng thời cũng có cách đọc với biến thiên điển hình của con người. Đây là trường hợp phổ biến đối với hầu hết bài làm thực sự của sinh viên.
- Tương đồng thấp, điểm AI cao: các câu nguyên bản, không sao chép từ bất kỳ đâu, nhưng đọc lên có tính dự đoán về mặt thống kê theo cách mà văn bản được tạo ra thường có. Dấu hiệu của văn bản AI chưa được chỉnh sửa mà không ai diễn giải lại từ một nguồn có sẵn.
- Tương đồng cao, điểm AI thấp: văn bản khớp chặt với một nguồn do con người viết đã có sẵn, nhưng không có sự phẳng về mặt thống kê mà bộ phân loại gắn với quá trình tạo sinh. Văn bản sao chép, bị công cụ cũ hơn phát hiện thay vì công cụ mới hơn.
- Tương đồng cao, điểm AI cao: văn bản khớp với một nguồn có sẵn mà bản thân nguồn đó cũng do AI tạo ra, chẳng hạn một bài viết do AI viết đã được nộp trước đó hoặc một trang văn bản do AI tạo ra đã được lập chỉ mục từ web mở.
Không có tổ hợp nào trong số này đòi hỏi điều gì bất thường ở phía phần mềm. Chúng xuất phát từ thực tế rằng một hệ thống kiểm tra sự khớp, còn hệ thống kia kiểm tra một mẫu hình, và một đoạn văn bản có thể mang một trong hai thuộc tính đó, cả hai, hoặc không thuộc tính nào.
Điểm AI Cao Chứng Minh Điều Gì, Và Không Chứng Minh Điều Gì
Một điểm AI cao là một ước lượng thống kê, không phải là một lời thú nhận bị trích xuất từ văn bản. Nó cho biết văn xuôi trước bộ phân loại giống, ở lựa chọn từ ngữ và nhịp điệu, kiểu viết mà mô hình đã được huấn luyện để liên hệ với việc tạo sinh bằng AI. Nó không xác định một câu cụ thể là chắc chắn do máy viết, và nó không biết gì về việc tài liệu thực sự được tạo ra như thế nào, mà chỉ biết nó được đọc ra sao sau khi hoàn tất. TextPulse giữ cùng quan điểm về các con số của chính mình, điều nó báo cáo là một Human Score ước tính được tính từ văn bản trước mặt nó, không phải là một phán quyết về việc công cụ nào, nếu có, đã chạm vào tài liệu.
Phản ứng thực tế đối với bất kỳ con số nào trong hai con số đó, một điểm tương đồng thấp hoặc một điểm AI cao, đều giống nhau, hãy xem đó là lý do để xem xét kỹ hơn, chứ không phải là một kết luận để chấp nhận hay bác bỏ ngay từ cái nhìn đầu tiên. Bản nháp, ghi chú và lịch sử phiên bản cho thấy tài liệu thực sự đã được viết như thế nào theo một cách mà một tỷ lệ phần trăm không bao giờ có thể, ở cả hai báo cáo. Bất kỳ ai tò mò về điều mà một bộ phân loại thực sự đang phản ứng trong bản nháp của chính mình đều có thể tự xem cùng một mẫu hình ở cấp độ từ với một free perplexity checker, từ rất lâu trước khi bất kỳ báo cáo nào được tạo ra.
Bộ free tools collection của TextPulse bao gồm các lớp thống kê khác đáng kiểm tra trước khi một bản nháp đi đến tay giảng viên, không chỉ hai công cụ được so sánh ở đây.
Sau khi hai con số được tách ra, câu hỏi tiếp theo là điểm Turnitin nào được xem là tốt. Đối với bộ phát hiện còn lại mà sinh viên thường gặp nhất, GPTZero hoạt động như thế nào được trình bày trên trang riêng của nó.
Hai con số sẽ tiếp tục nằm cạnh nhau trên cùng một báo cáo, và chúng sẽ tiếp tục bị những người vội vàng đọc như thể là một con số duy nhất. Biết được mỗi con số thực sự đang trả lời câu hỏi nào chính là điều biến một cặp phần trăm gây nhầm lẫn thành hai mẩu thông tin riêng biệt, hữu ích.
Câu hỏi thường gặp
Turnitin similarity vs AI score phụ thuộc vào việc mỗi công cụ kiểm tra điều gì. Điểm tương đồng báo cáo bao nhiêu phần của bài nộp khớp với văn bản đã có trong cơ sở dữ liệu của Turnitin gồm các trang web, ấn phẩm và bài làm sinh viên trước đó. AI score là một phép đo riêng biệt, độc lập, ước tính mức độ văn xuôi đọc giống văn bản do máy tạo ra đến đâu, hoàn toàn không tham chiếu đến bất kỳ cơ sở dữ liệu nào. Tài liệu chính thức của Turnitin nêu rõ hai con số này không ảnh hưởng lẫn nhau.
PhD in natural language processing, with years spent building NLP applications end to end. Moe works on text analysis: lexical and syntactic structure, and what separates machine-generated prose from human prose statistically. He has been experimenting with computational linguistics since the early days of NLTK, spaCy and WordNet, and still writes most of his tooling in Python.



