Jak działa GPTZero
GPTZero rozsławił perplexity i burstiness, a potem po cichu z nich zrezygnował. Oto, co jego klasyfikator mierzy teraz, co rzeczywiście pokazuje raport i gdzie narzędzie samo wskazuje swoje ograniczenia.

Wpisz w pasku wyszukiwania frazę „how gptzero works”, a większość tego, co pojawia się w wynikach, nadal opisuje perplexity i burstiness, dwie statystyki, które sam założyciel firmy uczynił sławnymi w pierwszych tygodniach po premierze ChatGPT. Ten opis był trafny w styczniu 2023 roku. Od tamtej pory nie był trafny, od jesieni tego roku, kiedy własna dokumentacja GPTZero mówi, że firma zastąpiła tę metodę czymś zupełnie innym. Różnica między tym, co narzędzie robiło w momencie uruchomienia, a tym, co robi teraz, jest na tyle duża, że większość wyjaśnień krążących do dziś opisuje produkt, który już nie istnieje.
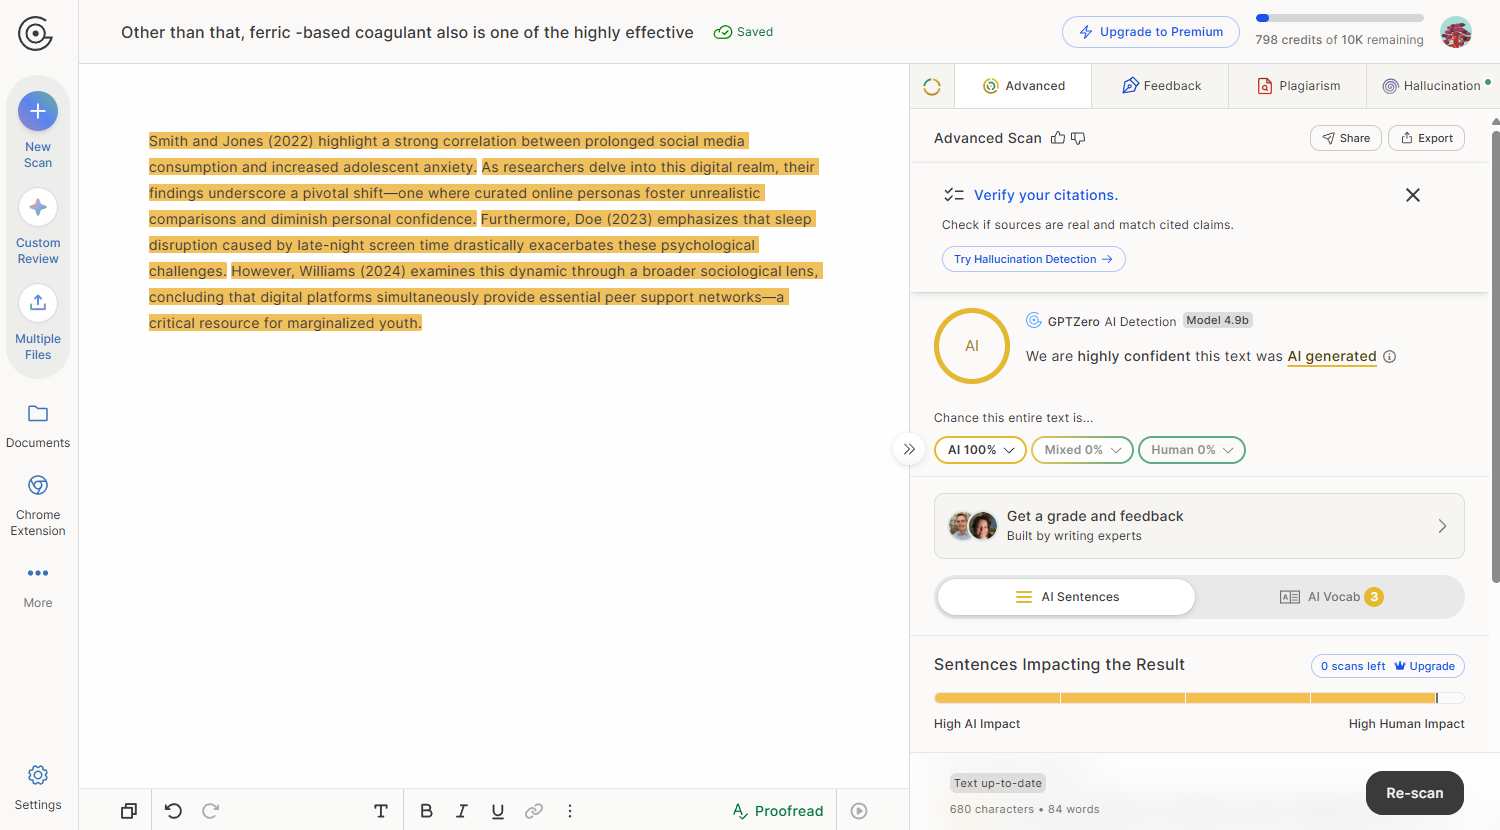
Dziś GPTZero uruchamia klasyfikator na poziomie zdanie po zdaniu na dużym, mieszanym zbiorze tekstów generowanych przez ludzi i generowanych przez sztuczną inteligencję, zamiast obliczać perplexity. Dziś GPTZero nadal podaje jedną, główną liczbę, ale działania arytmetyczne są inne. Podświetlanie na poziomie zdań pod główną liczbą ma również inne znaczenie niż w 2023 roku. Obie wersje tej historii warto znać: ta, która uczyniła te terminy sławnymi, oraz ta, która faktycznie działa dziś.
Historia: Jak Perplexity i Burstiness Uczyniły GPTZero Sławnym
2 stycznia 2023 roku ówczesny student Princeton Edward Tian opublikował publiczną wersję demonstracyjną GPTZero, zaledwie kilka tygodni po tym, jak pojawił się ChatGPT. Jego oryginalna strona wyjaśniająca opisuje, jak wykorzystał dwie statystyki zapożyczone z modelowania języka do wykrywania, kiedy model językowy napisał coś. Perplexity to wynik określający, jak bardzo model referencyjny był zaskoczony doborem słów w tekście. Burstiness to nazwa GPTZero na to, jak bardzo to zaskoczenie wahało się w obrębie dokumentu. Te strony wyjaśniające są powodem, dla którego oba słowa w ogóle weszły do codziennej rozmowy o pisaniu przez AI. Większość osób, które dziś potrafią zdefiniować perplexity lub burstiness, nauczyła się tych terminów z GPTZero, a nie z podręcznika.
Sama mechanika była prosta do opisania. Przepuść fragment przez model językowy referencyjny, a proza, którą model uznaje za wysoce przewidywalną, o niskim perplexity, będzie czytana jako typowa dla maszyny, ponieważ generowanie zwykle faworyzuje najbardziej prawdopodobne kolejne słowo zamiast tego zaskakującego. Własna, już wycofana dokumentacja GPTZero opublikowała nawet zasadę ogólną: wynik perplexity powyżej 85 oznaczał, że bardziej prawdopodobne jest, iż tekst jest ludzki, niż maszynowy. Ten próg pochodził od jednego dostawcy, na jednym modelu, w jednym momencie w czasie, a GPTZero samo już za nim nie stoi.
Jak działa GPTZero teraz: klasyfikator na poziomie zdania
Centrum wsparcia GPTZero stwierdza to wprost: „Od jesieni 2023 roku GPTZero nie używa już perplexity i burstiness do wykrywania AI, ponieważ przeszliśmy na architekturę opartą na uczeniu głębokim”. Jej aktualna strona technologii potwierdza, że przejście jest całkowite. Opisuje „podejście end-to-end oparte na uczeniu głębokim, wytrenowane na zbiorach tekstów z sieci, edukacji oraz wygenerowanych przez AI z różnych LLM”, w którym „model klasyfikujący zdanie po zdaniu wyznacza prawdopodobieństwo i poziom pewności, że tekst został utworzony przez AI”. Perplexity i burstiness nie pojawiają się na tej stronie nigdzie.
Od tego czasu dodano również warstwę obronną, Paraphraser Shield, zbudowaną w celu wychwytywania tekstu AI, który został uruchomiony przez narzędzie do przepisywania, aby ominąć wykrywanie. Można wkleić tekst, przesłać dokumenty Word, pliki PDF oraz pliki obrazów, a także do pięćdziesięciu plików naraz. Cała ta infrastruktura nie ma nic wspólnego z liczeniem, jak często model referencyjny zgadłby to samo słowo.
Co tak naprawdę pokazuje raport GPTZero
Wynik GPTZero składa się z trzech części: klasyfikacji AI, człowiek lub mieszane, procentu wyrażającego prawdopodobieństwo modelu, że dokument został napisany przez AI, oraz etykiety zaufania opisującej, jak wiarygodne jest to konkretne przewidywanie. Etykieta ma większe znaczenie, niż mogłoby się wydawać. GPTZero wiąże „wysoce wiarygodne” z poziomem błędu poniżej 2 procent oraz „niskie zaufanie” z poziomem błędu 14 procent lub wyższym, na tyle szerokim zakresie, że ten sam procent nagłówka może mieć bardzo różną wagę w zależności od raportu.
Płatne skany dodają podświetlanie na poziomie zdań i warto je czytać poprawnie. GPTZero opisuje podświetlone zdania jako te, które w sposób nieproporcjonalny wpływają na wynik ogólny, a nie jako listę zarzutów wobec poszczególnych linii. Zdanie może pozostać niepodświetlone, a mimo to ukształtować wynik, ponieważ klasyfikator odczytuje dokument jako całość, a nie głosuje zdanie po zdaniu.
| Element raportu | Co ci mówi |
|---|---|
| Klasyfikacja | Pojedyncza etykieta: AI, człowiek lub mieszane |
| Wynik prawdopodobieństwa AI | Procent odzwierciedlający, jak prawdopodobne model ocenia, że dokument został napisany przez AI |
| Etykieta zaufania | Od wysoce wiarygodne, przy poziomie błędu poniżej 2 procent, do niskie zaufanie, 14 procent lub wyższe |
| Podświetlanie zdań | Oznacza zdania wnoszące największy wkład do wyniku w Advanced Scan, a nie każde zdanie powiązane z nim |
Żaden z tych elementów raportu nie istniał w obecnej formie, gdy wyjaśnienie dotyczące perplexity i burstiness było jeszcze publicznym opisem samego siebie przez GPTZero. Interfejs zmienił się wraz z metodą.
Humanizuj własną pracę
Przekształć tekst wspomagany przez AI i spraw, by brzmiał naturalnie, bez naruszania ważnych słów ani cytowań.
Dlaczego opis Perplexity i Burstiness wciąż krąży
Oryginalne wyjaśnienie GPTZero nadal jest dostępne online, nadal jest indeksowane i nadal stanowi jedno z czytelniejszych ogólnych opisów tego, jak perplexity i burstiness działają jako pojęcia. Wyszukiwarki i inne strony wciąż je cytują, a niektóre wskazują na szeroko udostępnioną recenzję z 2026 roku, twierdzącą, że narzędzie nadal uruchamia warstwę perplexity i burstiness cicho obok swojego klasyfikatora. Obecne strony GPTZero, strona technologii oraz oba artykuły pomocy mówią coś przeciwnego: terminy zostały wycofane, a nie jedynie ukryte w tle. Strona opisująca pojęcie w ujęciu abstrakcyjnym nie jest tym samym, co strona opisująca obecną metodę tego narzędzia, a traktowanie tych dwóch jako zamiennych jest w największym stopniu powodem, dla którego nieporozumienie utrzymało się trzy lata po dacie wygaśnięcia.
Ma to znaczenie wykraczające poza ciekawostki. Student lub współpracownik, któremu polecono obniżyć perplexity lub rozłożyć długość zdań konkretnie po to, by pokonać GPTZero, otrzymuje poradę skierowaną do wersji produktu, która przestała działać w 2023 roku. To, co przesuwa klasyfikator zdań, jest pokrewnym, ale innym pytaniem, bliższym szerszemu opisowi tego, jak AI detektory faktycznie działają, niż któremukolwiek z tych statystyk osobno. GPTZero nie przestało ich mierzyć, według własnych informacji znajdują się one wśród siedmiu wskaźników zasilających aktualny model, ale przestały być tym, co decyduje o odpowiedzi.
Co GPTZero mówi, że nie potrafi zrobić
Publikowane przez GPTZero benchmarki są mniej więcej tak mocne, jak to, co dostawca jest prawdopodobnie skłonny opublikować na temat własnego produktu. Firma podaje „wskaźnik dokładności na poziomie 99% przy wykrywaniu tekstu generowanego przez AI w porównaniu z pisaniem ludzkim”, stwierdza „utrzymujemy fałszywie dodatni wskaźnik GPTZero na nie więcej niż 1% podczas oceny tekstu AI w porównaniu z tekstem ludzkim” oraz odnotowuje „wskaźnik dokładności na poziomie 96,5%” w zgłoszeniach łączących pisanie AI i ludzkie, obok 1,1 procent na esejach TOEFL, powszechnym odpowiedniku dla pisania w języku angielskim przez osoby niebędące rodzimymi użytkownikami. Te liczby pochodzą z własnej oceny GPTZero, opublikowanej w styczniu 2025 roku, bez przywołania na stronie raportującej je niezależnej replikacji. Ta sama strona odrzuca też twierdzenie, po które sięga większość dostawców, stwierdzając, że „nie ma nigdy gwarancji na poziomie 100%” oraz że każdy, kto twierdzi inaczej, prawdopodobnie ma błąd w swoich danych lub w metodzie oceny.
Własna strona ograniczeń GPTZero jest bardziej szczegółowa niż dane marketingowe. Firma stwierdza, że dokładność poprawia się wraz z dostarczaniem większej ilości tekstu i spada na poziomie zdania oraz akapitu w porównaniu z pełnym dokumentem. Podaje, że jej dane treningowe to w większości tekst prozą w języku angielskim dla dorosłych, więc tekst, który odbiega od tego wzorca, jest trudniej sklasyfikować w sposób wiarygodny. Stwierdza, że klasyfikator nie jest trenowany pod kątem wykrywania tekstu AI, który został w znacznym stopniu zmodyfikowany po wygenerowaniu. I stwierdza wprost, że inne pisanie generowane maszynowo lub wysoce proceduralne, nie tylko output czatbota, może zostać oznaczone w ten sam sposób.
To wszystko nie jest powodem, by traktować liczbę GPTZero jako kwestię bezdyskusyjną, i nie jest to jedyny detektor, którego warto się nauczyć rozumieć we własnych kategoriach. Czytelnicy, którzy są ciekawi, na co faktycznie reaguje taki klasyfikator, mogą zobaczyć wersję tego wzorca na własne potrzeby za pomocą darmowego sprawdzania perplexity lub darmowego sprawdzania burstiness, dwóch elementów pełniejszego zestawu darmowych narzędzi obejmującego pozostałe warstwy statystyczne, na których opiera się raport tego typu.
Dwie statystyki nagłówkowe GPTZero mają własne strony: co mierzy perplexity w wykrywaniu AI oraz arytmetyka prawdopodobieństwa tokena, która wytwarza obie te liczby.
Narzędzie, które jest gotowe nazywać własne ślepe punkty z taką precyzją, zasługuje na większe zaufanie niż takie, które twierdzi, że ich nie ma, a następny niezrozumiany procent w raporcie jest dobrym miejscem, aby zacząć pytać, jaki rodzaj narzędzia go wytworzył.
Co wykazały nasze własne badania
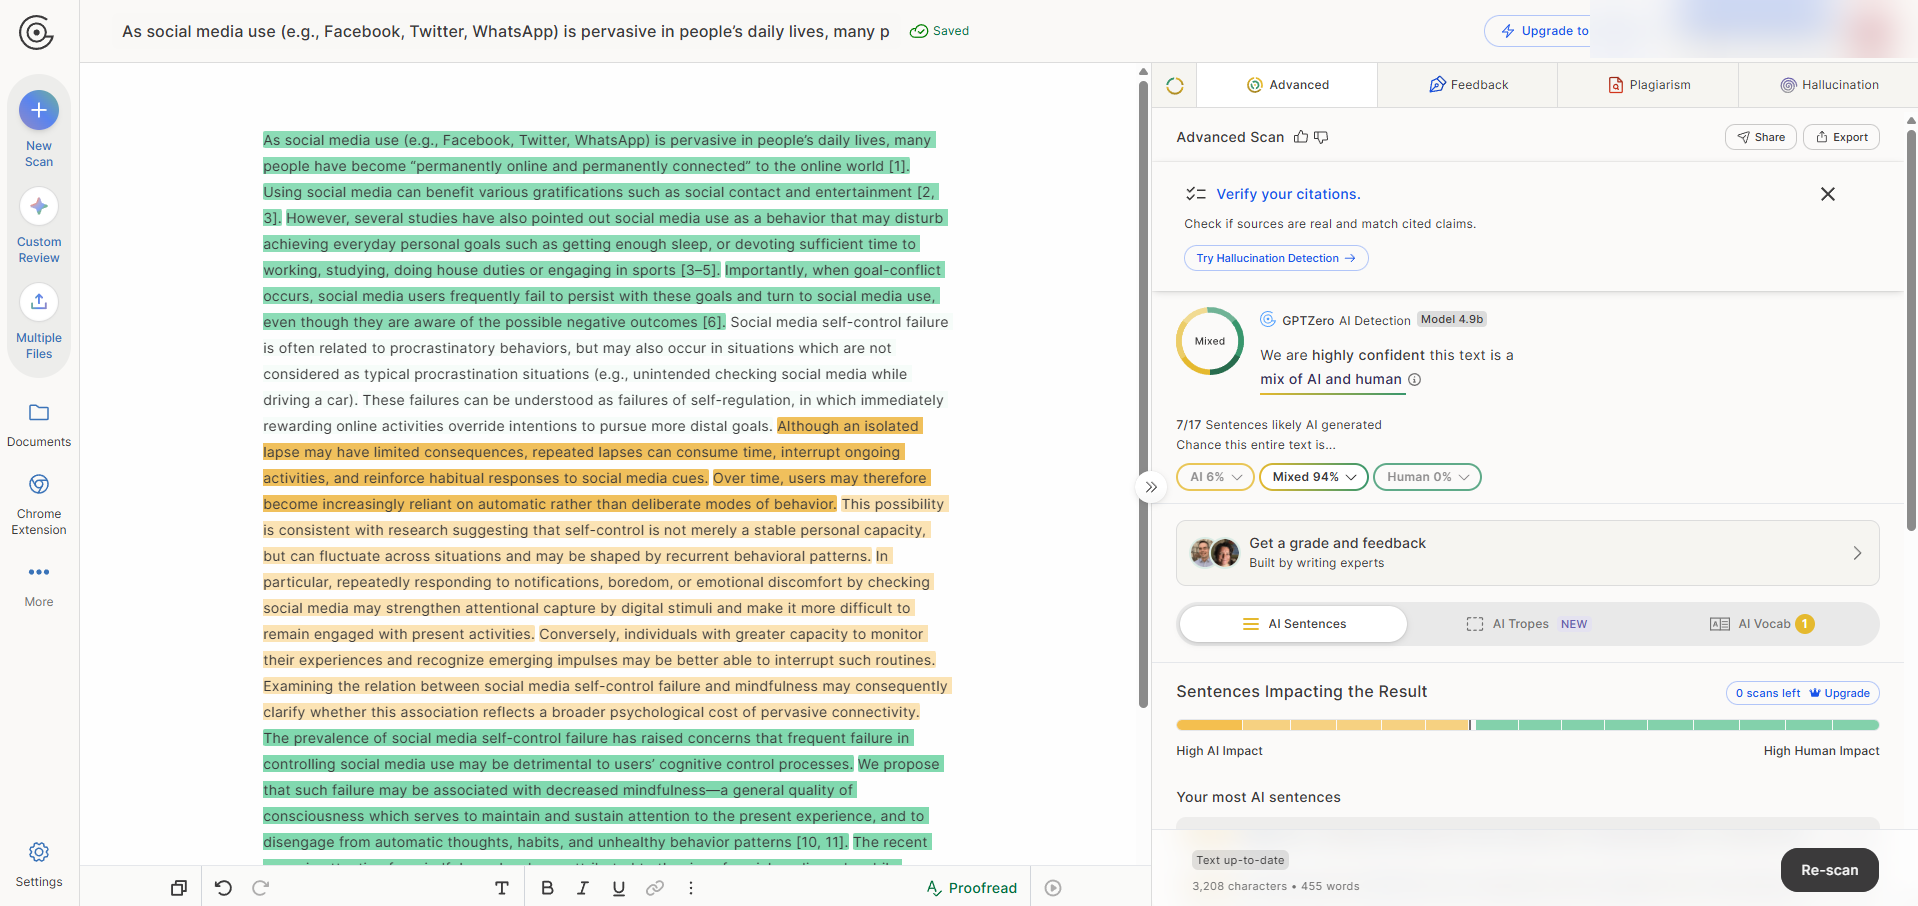
W badaniu zgodności detektorów TextPulse Research dziewięć komercyjnych detektorów AI oceniło te same 90 tekstów akademickich. Jednym z nich był hybrydowy tekst o długości 455 słów: napisany przez człowieka wstęp i zakończenie wokół środkowej części 168 słów wygenerowanej przez AI. GPTZero ocenił ten tekst na 41.2% AI, podczas gdy werdykty pozostałych narzędzi dla tych samych słów wahały się od 0% do 95.7% AI. Pełny artykuł, korpus i macierz wyników wszystkich narzędzi są otwarcie dostępne na TextPulse Research.
Najczęściej zadawane pytania
Nie. Centrum pomocy GPTZero podaje, że firma przestała używać perplexity i burstiness do wykrywania od jesieni 2023 roku, po przejściu na klasyfikator głębokiego uczenia. Jego obecna strona technologiczna opisuje model klasyfikacji zdanie po zdaniu i nie wspomina o żadnym z tych terminów. Ten opis nadal krąży, ponieważ własne objaśnienie GPTZero z 2023 roku spopularyzowało oba słowa, zanim metoda została zmieniona.
PhD in natural language processing, with years spent building NLP applications end to end. Moe works on text analysis: lexical and syntactic structure, and what separates machine-generated prose from human prose statistically. He has been experimenting with computational linguistics since the early days of NLTK, spaCy and WordNet, and still writes most of his tooling in Python.



