GPTZero چگونه کار میکند
GPTZero perplexity و burstiness را مشهور کرد، سپس هر دو را بیسروصدا کنار گذاشت. در اینجا میبینید طبقهبند آن اکنون چه چیزی را میسنجد، یک گزارش واقعاً چه چیزی را نشان میدهد، و خود ابزار محدودیتهایش را کجا بیان میکند.

عبارت «how gptzero works» را در یک نوار جستجو وارد کنید و بیشتر نتایجی که برمی گردد هنوز همان توصیفی را ارائه می دهند که درباره perplexity و burstiness است، دو آماری که بنیان گذار خود آن را در هفته های نخست پس از انتشار ChatGPT مشهور کرد. این توصیف در ژانویه 2023 دقیق بود. از آن زمان، دیگر دقیق نبوده است، از پاییز همان سال، زمانی که مستندات خود GPTZero می گوید شرکت آن روش را با چیزی کاملا متفاوت جایگزین کرده است. فاصله میان کاری که این ابزار در زمان عرضه انجام می داد و کاری که اکنون انجام می دهد آن قدر زیاد است که بیشتر توضیحاتی که امروز هنوز در گردش هستند، محصولی را توصیف می کنند که دیگر وجود ندارد.
امروز، GPTZero به جای محاسبه perplexity، روی یک مجموعه بزرگ و ترکیبی از متن های تولیدشده توسط انسان و متن های تولیدشده توسط هوش مصنوعی، یک طبقه بندی کننده جمله به جمله اجرا می کند. GPTZero امروز همچنان یک عدد تیتر واحد ارائه می دهد، اما حساب و کتاب آن متفاوت است. برجسته سازی در سطح جمله که زیر عدد تیتر قرار دارد نیز معنایی متفاوت از آنچه در 2023 داشت دارد. هر دو نسخه از این داستان دانستن ارزش دارند، نسخه ای که اصطلاحات را مشهور کرد، و نسخه ای که واقعا امروز اجرا می شود.
تاریخچه: چگونه perplexity و burstiness GPTZero را مشهور کردند
در 2 ژانویه 2023، ادوارد تیان، دانشجوی سابق پرینستون، یک دمو عمومی از GPTZero منتشر کرد، تنها چند هفته پس از انتشار ChatGPT. صفحه توضیح اولیه او شرح می دهد که چگونه از دو آمار که از مدل سازی زبان وام گرفته شده بودند استفاده کرد تا تشخیص دهد چه زمانی یک مدل زبانی چیزی نوشته است. Perplexity نمره ای است برای این که یک مدل مرجع تا چه حد از انتخاب های واژگانی در متن شگفت زده شده است. Burstiness نام GPTZero برای این است که این میزان شگفتی در طول یک سند چقدر نوسان داشته است. این صفحات توضیح دهنده دلیل ورود هر دو واژه به گفت وگوی روزمره درباره نگارش مبتنی بر هوش مصنوعی هستند. بیشتر افرادی که امروز می توانند perplexity یا burstiness را تعریف کنند، این اصطلاحات را از GPTZero یاد گرفته اند، نه از یک کتاب درسی.
خود سازوکار به سادگی قابل توصیف بود. یک قطعه متن را از یک مدل زبانی مرجع عبور دهید، و نثری که مدل آن را بسیار قابل پیش بینی می یابد، با perplexity پایین، به عنوان متنی که از نظر ماشین معمول است خوانده می شود، زیرا تولید معمولاً کلمه بعدی محتمل را به جای کلمه شگفت آور ترجیح می دهد. مستندات بازنشسته GPTZero حتی یک قاعده سرانگشتی منتشر کرده بود: نمره perplexity بالاتر از 85 به احتمال بیشتر انسانی بودن نسبت به ماشینی بودن می خواند. این آستانه از یک فروشنده، روی یک مدل، در یک مقطع زمانی بود، و خود GPTZero دیگر از آن پشتیبانی نمی کند.
GPTZero چگونه اکنون کار می کند: یک طبقه بندی کننده در سطح جمله
مرکز پشتیبانی GPTZero به صراحت بیان می کند: "از پاییز 2023، GPTZero دیگر از perplexity و burstiness برای تشخیص هوش مصنوعی استفاده نمی کند، زیرا ما به یک معماری مبتنی بر یادگیری عمیق مهاجرت کردیم." صفحه فناوری فعلی آن، تأیید می کند که این تغییر کامل است. این صفحه "یک رویکرد یادگیری عمیق پایان به پایان، آموزش دیده با مجموعه داده های متنی از وب، آموزش، و تولید شده توسط هوش مصنوعی از طیفی از LLMها" را توصیف می کند، که در آن "یک مدل طبقه بندی کننده جمله به جمله، احتمال و میزان اطمینان این که یک متن توسط هوش مصنوعی ایجاد شده است را تعیین می کند". perplexity و burstiness در هیچ جای آن صفحه دیده نمی شوند.
از آن زمان، یک لایه دفاعی هم اضافه شده است، Paraphraser Shield، که برای شناسایی متن تولیدشده توسط هوش مصنوعی طراحی شده است، متنی که از یک ابزار بازنویسی برای دور زدن تشخیص عبور کرده باشد. می توانید متن را وارد کنید، اسناد Word، فایل های PDF و فایل های تصویری را بارگذاری کنید، و تا پنجاه فایل را همزمان. هیچ یک از این زیرساخت ها ربطی به شمارش این ندارد که یک مدل مرجع چند وقت یک بار همان کلمه را حدس می زد.
گزارش GPTZero عملا چه چیزی را به شما نشان می دهد
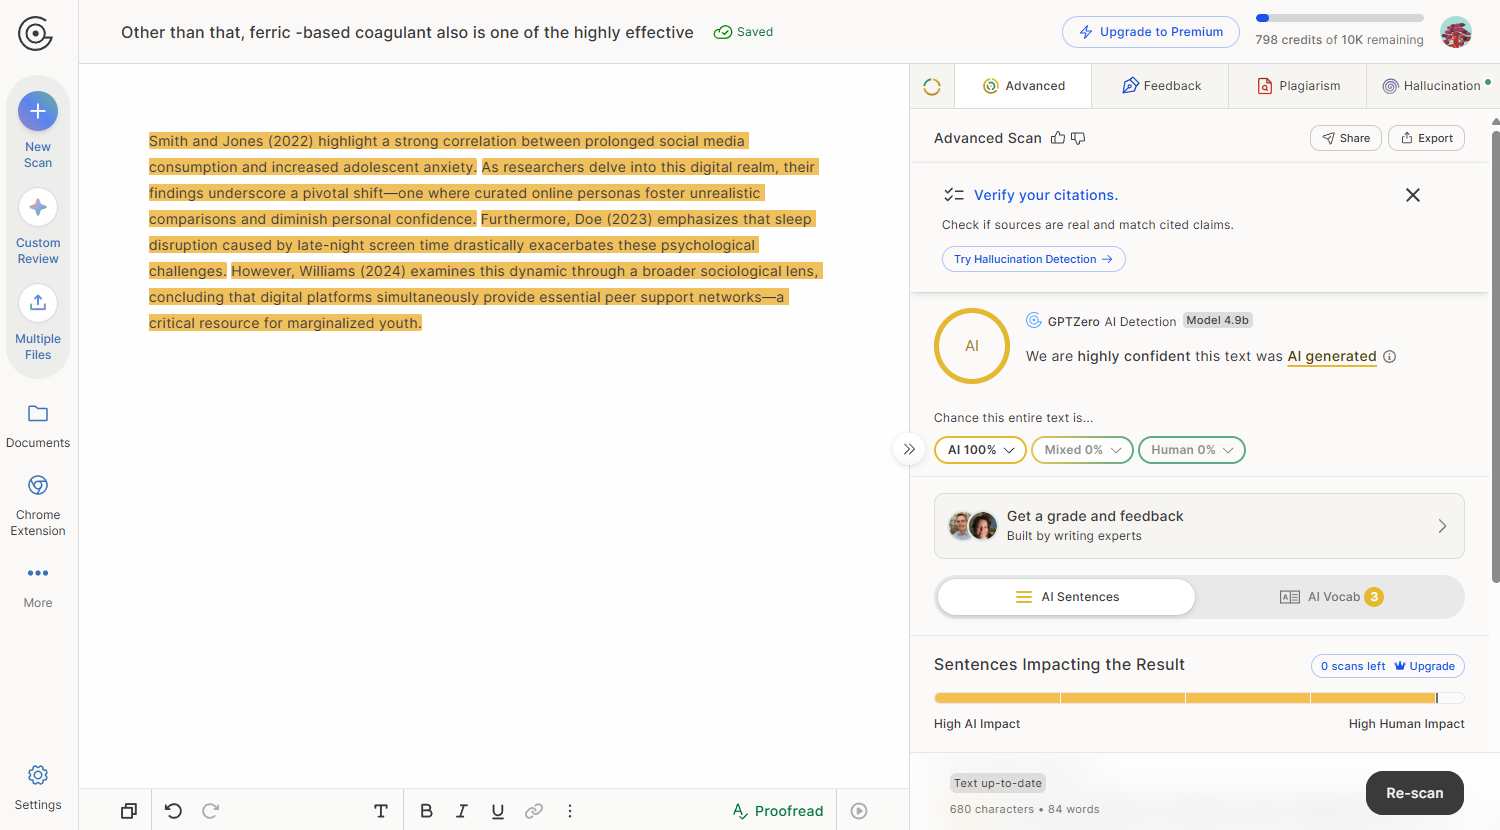
یک نتیجه GPTZero سه بخش دارد: یک طبقه بندی از AI، انسان یا ترکیبی، یک درصد که احتمال مدل را بیان می کند که سند توسط AI نوشته شده باشد، و یک برچسب اطمینان که توصیف می کند پیش بینی مربوط تا چه اندازه قابل اتکا است. این برچسب از چیزی که شاید به نظر برسد مهم تر است. GPTZero عبارت "highly confident" را به نرخ خطای کمتر از 2 درصد و "low confidence" را به نرخ خطای 14 درصد یا بالاتر پیوند می دهد، بازه ای به اندازه کافی گسترده که یک درصد تیتر یکسان بتواند از یک گزارش به گزارش بعدی وزن بسیار متفاوتی داشته باشد.
اسکن های پولی، برجسته سازی در سطح جمله اضافه می کنند، و ارزش دارد آن را درست بخوانید. GPTZero جملات برجسته شده را به عنوان جملاتی توصیف می کند که به طور نامتناسب بر نمره کلی اثر می گذارند، نه فهرستی از اتهام ها علیه خطوط فردی. ممکن است یک جمله برجسته نشود و با این حال نتیجه را شکل داده باشد، زیرا طبقه بندی کننده سند را به عنوان یک کل می خواند، نه اینکه جمله به جمله رای بدهد.
| Report element | What it tells you |
|---|---|
| Classification | یک برچسب واحد: AI، انسان، یا ترکیبی |
| AI probability score | درصدی که بازتاب می دهد مدل تا چه اندازه سند را به عنوان متن تولیدشده توسط AI محتمل می داند |
| Confidence label | از highly confident، با نرخ خطای کمتر از 2 درصد، تا low confidence، 14 درصد یا بالاتر |
| Sentence highlighting | جملاتی را که بیشترین سهم را در نمره در Advanced Scan دارند مشخص می کند، نه هر جمله ای که به آن مرتبط باشد |
هیچ یک از این عناصر گزارش در شکل فعلی خود وجود نداشتند، زمانی که توضیح perplexity-and-burstiness هنوز توصیف عمومی GPTZero از خودش بود. رابط کاربری همراه با روش تغییر کرد.
مقاله خود را انسانیسازی کنید
متنِ کمکگرفته از AI خود را دگرگون کنید و کاری کنید طبیعی به نظر برسد، بدون دست زدن به واژههای مهم یا ارجاعها.
چرا توصیف Perplexity و Burstiness هنوز در گردش است
توضیح اولیه GPTZero هنوز آنلاین است، هنوز نمایه شده است، و هنوز یکی از روشن ترین توصیف های عمومی از این است که Perplexity و Burstiness به عنوان مفاهیم چگونه کار می کنند. موتورهای جست وجو و دیگر سایت ها همچنان آن را نقل می کنند، و برخی به یک بررسی گسترده شده در 2026 اشاره می کنند که ادعا می کند این ابزار همچنان یک لایه Perplexity و Burstiness را به طور آرام در کنار طبقه بندی کننده خود اجرا می کند. صفحات فعلی خود GPTZero، صفحه فناوری و هر دو مقاله پشتیبانی، برعکس را می گویند: این اصطلاحات بازنشسته شده بودند، نه این که صرفا پشت صحنه پنهان شده باشند. صفحه ای که یک مفهوم را به صورت انتزاعی توصیف می کند، با صفحه ای که روش امروزی این ابزار را توصیف می کند یکسان نیست، و رفتار کردن با این دو به عنوان چیزهای قابل جایگزینی، مهم ترین دلیل تداوم این سردرگمی است که سه سال پس از تاریخ انقضایش ادامه یافته است.
این موضوع فراتر از سرگرمی است. به یک دانشجو یا همکار گفته شده است که Perplexity را کاهش دهد یا طول جمله ها را به طور پراکنده تر کند، به طور مشخص برای این که GPTZero را دور بزند، و در واقع توصیه ای به او داده می شود که برای نسخه ای از محصول است که در 2023 اجرای خود را متوقف کرده است. این که چه چیزی یک طبقه بندی کننده جمله را جابه جا می کند، پرسشی مرتبط اما متفاوت است، نزدیک تر به گزارش گسترده تر از این که آشکارسازهای AI واقعا چگونه کار می کنند تا به هر یک از آن آمارها به تنهایی. GPTZero به گفته خودش اندازه گیری آن ها را متوقف نکرده است، آن ها در میان هفت شاخصی قرار دارند که مدل فعلی را تغذیه می کنند، اما دیگر آن ها چیزی نبودند که تصمیم می گرفت پاسخ چیست.
GPTZero می گوید چه کاری را نمی تواند انجام دهد
بنچمارک های منتشرشده توسط GPTZero به همان اندازه قوی است که یک فروشنده به احتمال زیاد درباره محصول خودش منتشر می کند. این شرکت گزارش می کند «نرخ دقت 99% در تشخیص متن تولیدشده توسط هوش مصنوعی در مقایسه با نگارش انسانی» است، می گوید «ما نرخ مثبت کاذب GPTZero را هنگام ارزیابی متن هوش مصنوعی در برابر متن انسانی در حداکثر 1% نگه می داریم»، و «نرخ دقت 96.5%» را برای ارسال هایی ثبت می کند که متن های هوش مصنوعی و نگارش انسانی را با هم ترکیب می کنند، در کنار 1.1 درصد برای مقاله های TOEFL، یک معیار رایج برای نگارش انگلیسی غیرمادری. این اعداد از ارزیابی خود GPTZero می آیند که در ژانویه 2025 منتشر شده است، و در صفحه ای که این اعداد را گزارش می کند هیچ بازتولید مستقل به آن ها استناد نشده است. همان صفحه این ادعایی را که بیشتر فروشندگان به آن متوسل می شوند نیز رد می کند و می گوید «هیچ وقت قرار نیست تضمین 100% وجود داشته باشد» و اینکه هر کسی که ادعا می کند چنین تضمینی وجود دارد احتمالاً در داده هایش یا در روش ارزیابی اش نقصی دارد.
صفحه محدودیت های خود GPTZero از ارقام بازاریابی دقیق تر است. این شرکت بیان می کند که دقت با ارسال متن بیشتر بهبود می یابد و در سطح جمله و پاراگراف نسبت به کل سند کاهش پیدا می کند. همچنین می گوید داده های آموزشی آن عمدتا نثر انگلیسی بزرگسالان است، بنابراین متنی که از این الگو فاصله بگیرد، برای طبقه بندی قابل اعتمادتر دشوارتر است. می گوید طبقه بندی کننده برای شناسایی متن هوش مصنوعی که پس از تولید به شدت تغییر داده شده است آموزش ندیده است. و به صراحت بیان می کند که سایر نگارش های تولیدشده توسط ماشین یا نگارش های بسیار رویه ای، نه فقط خروجی چت بات ها، می توانند به همان شکل پرچم گذاری شوند.
هیچ یک از این موارد دلیل آن نیست که عدد GPTZero را خارج از بحث و تردید بدانیم، و این تنها آشکارساز ارزشمند برای فهمیدن به شرایط خودش نیست. خوانندگانی که کنجکاو هستند بدانند یک طبقه بندی کننده از این نوع عملا به چه چیزهایی پاسخ می دهد، می توانند با یک بررسی گر رایگان perplexity یا یک بررسی گر رایگان burstiness نسخه ای از همین الگو را برای خودشان ببینند، دو مورد از مجموعه ابزارهای رایگان کامل تر که لایه های آماری دیگر را هم پوشش می دهد که گزارشی مانند این بر آن ها تکیه دارد.
دو آمار تیتر GPTZero صفحات جداگانه خود را دارند: آنچه پرپلکسیته در تشخیص هوش مصنوعی اندازه گیری می کند، و حساب احتمالات توکن که هر دو عدد را تولید می کند.
ابزاری که به دقت حاضر است نقاط کور خود را نام ببرد، ارزش اعتماد بیشتری از ابزاری دارد که ادعا می کند هیچ نقطه کوری ندارد، و درصد نامشخص بعدی در یک گزارش جای خوبی برای شروع پرسیدن این است که چه نوع ابزاری آن را تولید کرده است.
یافتههای پژوهش خود ما
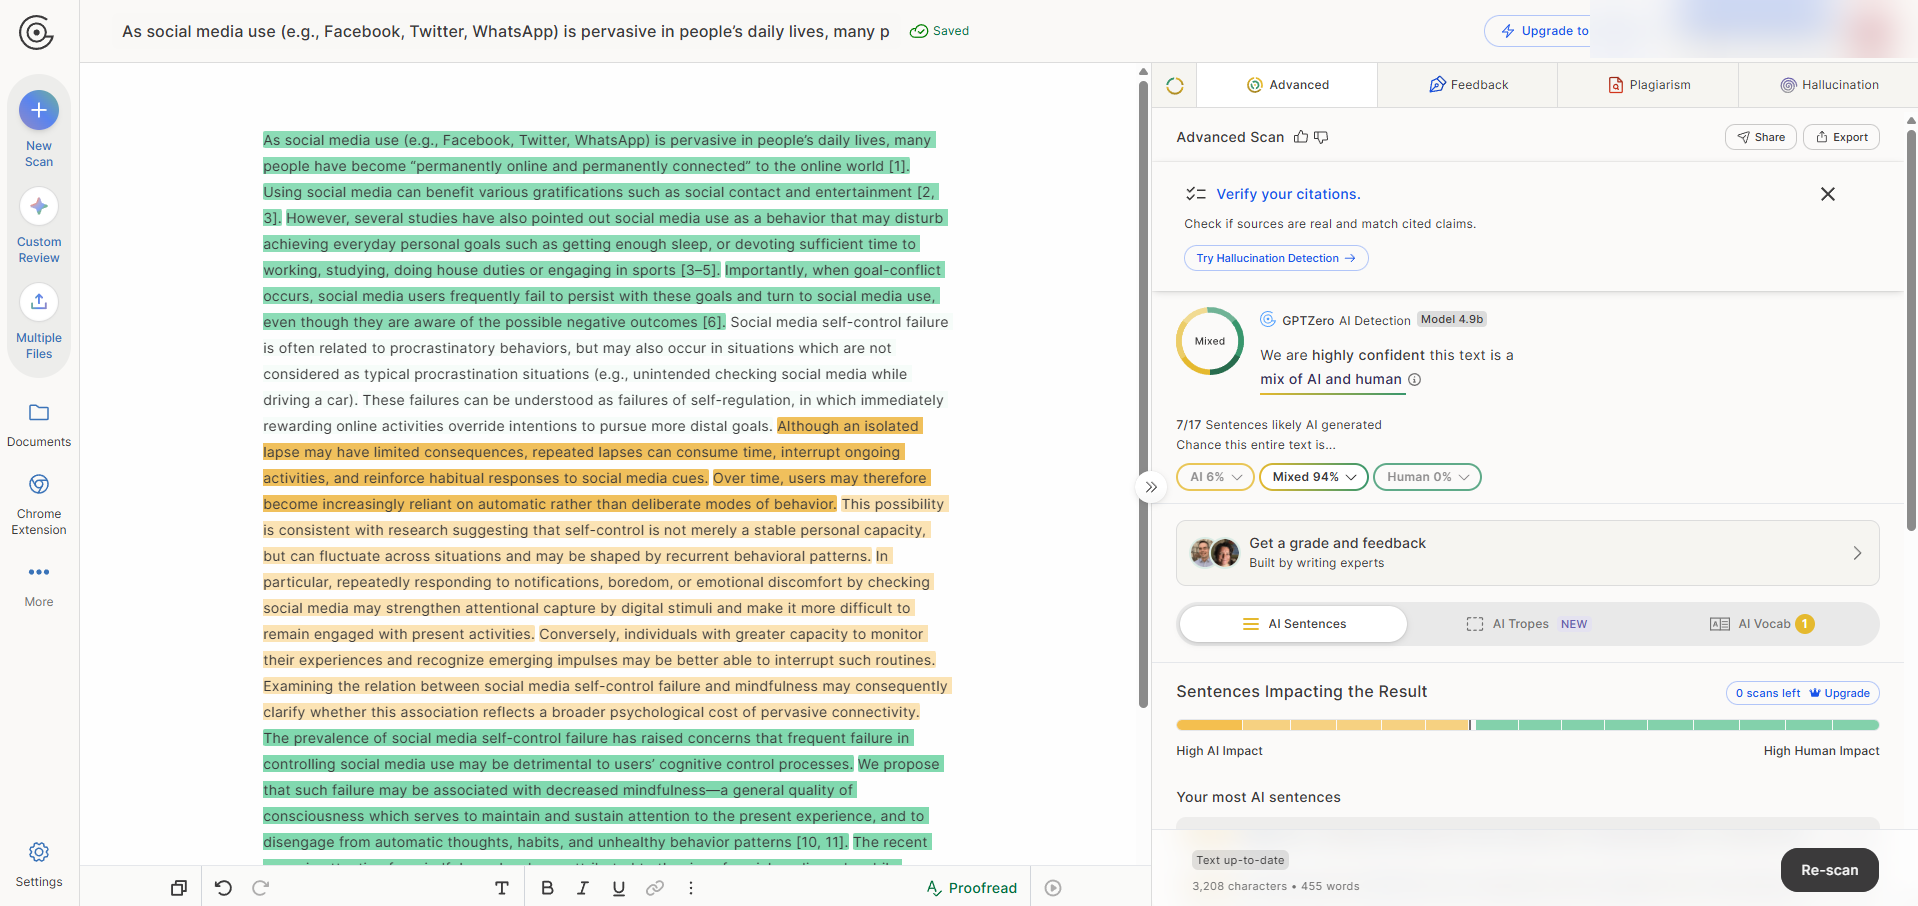
در مطالعه توافق آشکارسازهای TextPulse Research، نه آشکارساز تجاری هوش مصنوعی همان 90 متن دانشگاهی را ارزیابی کردند. یکی از آنها متنی ترکیبی با 455 واژه بود: آغاز و پایانی انسانی پیرامون بخش میانی 168 واژهای تولیدشده با هوش مصنوعی. GPTZero به این متن نمره 41.2% هوش مصنوعی داد، در حالی که داوری ابزارهای دیگر درباره همان واژهها از 0% تا 95.7% متغیر بود. مقاله کامل، پیکره و ماتریس نمرات هر ابزار به صورت آزاد در TextPulse Research در دسترس است.
سؤالات متداول
خیر. مرکز پشتیبانی GPTZero بیان میکند که شرکت از پاییز 2023 استفاده از perplexity و burstiness را برای تشخیص متوقف کرد، پس از آنکه به یک طبقهبند یادگیری عمیق روی آورد. صفحه فناوری کنونی آن یک مدل طبقهبندی جمله به جمله را توصیف میکند و هیچیک از این دو اصطلاح را ذکر نمیکند. این توصیف همچنان در گردش است، زیرا توضیحدهنده 2023 خود GPTZero هر دو واژه را پیش از تغییر روش مشهور کرد.
PhD in natural language processing, with years spent building NLP applications end to end. Moe works on text analysis: lexical and syntactic structure, and what separates machine-generated prose from human prose statistically. He has been experimenting with computational linguistics since the early days of NLTK, spaCy and WordNet, and still writes most of his tooling in Python.



