Turnitin Similarity Score در برابر AI Score: دو گزارش متفاوت
یک similarity score و یک AI score به پرسشهای متفاوتی پاسخ میدهند، بنابراین یک مقاله میتواند در یکی نمره پایین و در دیگری نمره بالا بگیرد، بیآنکه هیچیک از این دو عدد نادرست باشد. هر کدام چه چیزی را میسنجد، چه چیزی آن را فعال میکند، و یک عدد بالا چه چیزی را ثابت میکند و چه چیزی را ثابت نمیکند.

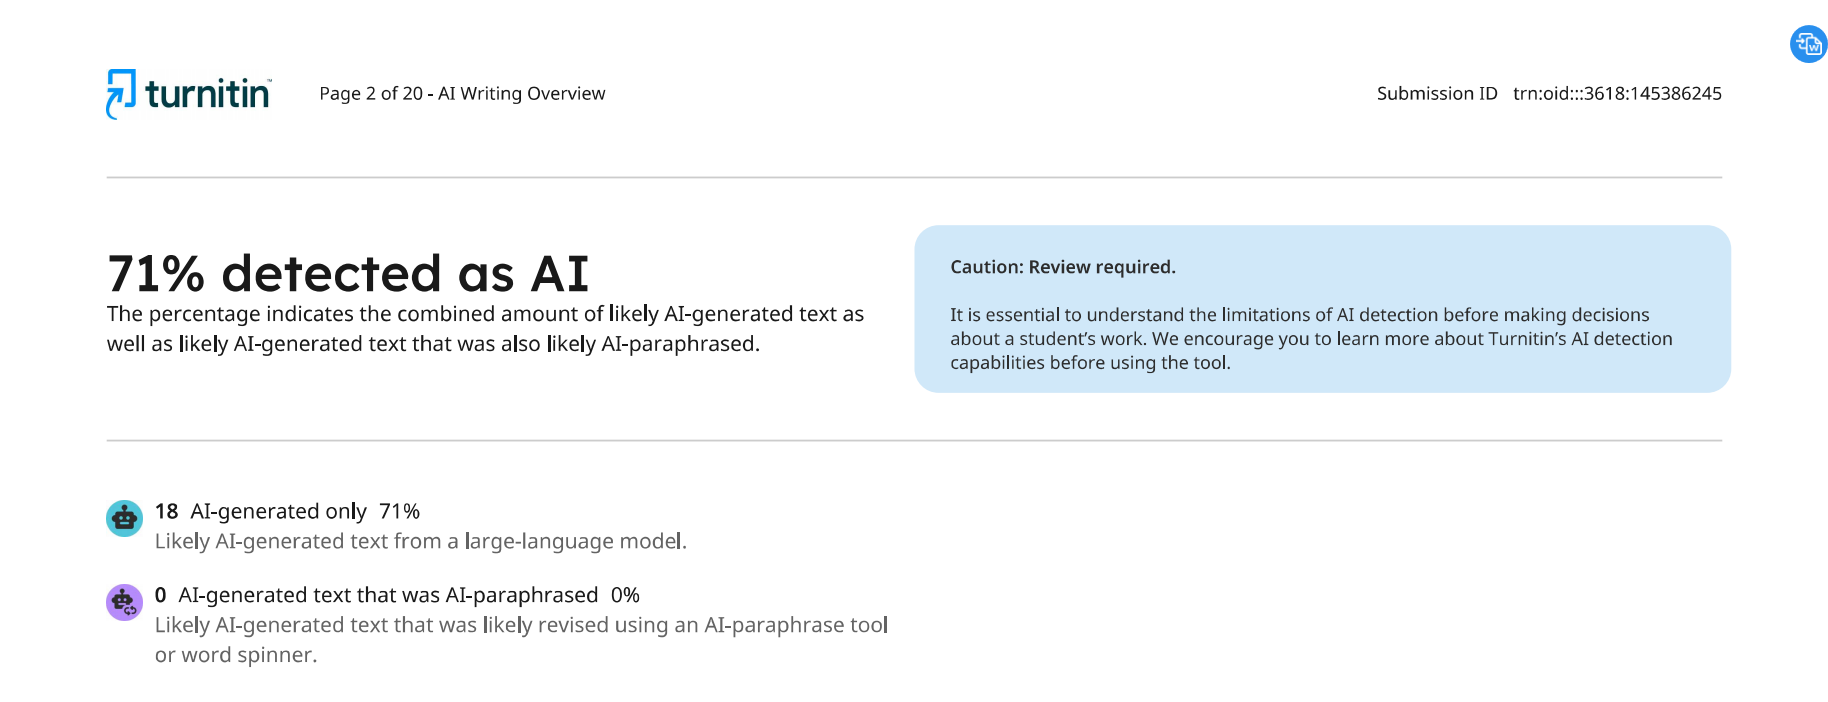
یک گزارش با دو عدد روی آن میرسد: نمره شباهت 3 درصد و نمره AI 88 درصد. برداشت طبیعی این است که باید در حال اندازهگیری یک چیز باشند، پس عدد پایین باید یعنی عدد بالا هم احتمالاً نادرست است. اما اینگونه کار نمیکند. Turnitin similarity vs AI score مقایسهای میان دو سامانه جداگانه است که دو چیز جداگانه را بررسی میکنند، و یک ارسال میتواند در یکی نمره پایین و در دیگری نمره بالا بگیرد، بیآنکه هیچیک از این دو عدد خطا باشد.
این سامانه از سامانه AI قدیمیتر است و برای شناسایی متنی ساخته شده که با چیزی که از پیش وجود دارد تطابق دارد. سامانه AI جدیدتر است و بهعنوان سنجشی مستقل در همان Similarity Report افزوده شده است، و برای برآورد این ساخته شده که آیا نثر شبیه متن تولیدشده توسط ماشین خوانده میشود یا نه، صرفنظر از اینکه اصلاً با چیزی تطابق داشته باشد یا نه. بنا بر مستندات خود Turnitin، این دو کاملاً مستقلاند و بر یکدیگر اثر نمیگذارند. همه چیز دیگر در این نوشته.

Similarity در Turnitin در برابر AI Score: هر عدد چه چیزی را گزارش میکند
Turnitin این دو را بهعنوان دو سنجش متفاوت در نظر میگیرد که در یک محصول واحد گرد آمدهاند، نه دو نمای متفاوت از یک نتیجه. Similarity Report یک ارسال را با پایگاه دادهای از محتوای وب، انتشارات دانشگاهی، و مقالههای دانشجویی که پیشتر ارسال شدهاند مقایسه میکند، و درصدی از متن ارسال را که با چیزی از پیش در آن پایگاه داده مطابقت دارد بازمیگرداند. تشخیص نگارش AI یک مدل کاملاً متفاوت را اجرا میکند که به همان گزارش افزوده شده است و امتیاز مستقل خود را دارد، مدلی که برای سنجش اینکه نثر یک بخش تا چه اندازه به نوشتار تولیدشده توسط ماشین شباهت دارد آموزش دیده است، بدون هیچ ارجاعی به هیچ پایگاه داده خارجی. سازوکار کاملتر اینکه طبقهبند AI در Turnitin چگونه به آن عدد میرسد جداگانه توضیح داده شده است، آنچه در اینجا اهمیت دارد این است که این بخش به پرسشی متفاوت از موتور similarity پاسخ میدهد که در همان گزارش قرار دارد.
Similarity Score در عمل چه چیزی را اندازهگیری میکند
Similarity یک تمرین تطبیق است، نه یک داوری. راهنمای خود Turnitin صریح است که این ابزار plagiarism را بررسی نمیکند. این ابزار همپوشانی را بررسی میکند و تفسیر را به مدرس یا استاد خواننده گزارش واگذار میکند. یک نقلقول که بهدرستی از متن جدا شده باشد، عبارتی در بخش روشها که در سراسر یک زیرشاخه علمی مشترک است، فهرست منابعی که به همان شیوهای قالببندی شده که هر مقاله در آن مجله فهرست منابع خود را قالببندی میکند: همه اینها میتوانند بهصورت یک match ثبت شوند، زیرا سیستم رشتههای همپوشان متن را میشمارد، نه اینکه داوری کند آیا این همپوشانی مشروع است یا نه.
این نیز دلیل دیگری است که چرا نمره شباهتِ صفر کمتر از آنچه به نظر میرسد، اثبات میکند. این یعنی ارسالشده هیچ بخش بلند و پیوستهای از متن را که در منابع نمایهشده Turnitin در جای دیگری یافت شده باشد، در بر ندارد. این نمره هیچ چیز درباره این نمیگوید که جملههای موجود چگونه تولید شدهاند، زیرا تولید جملهای که با هیچ چیز در یک پایگاه داده مطابقت نداشته باشد، همان مهارتی نیست که تولید جملهای را ممکن میکند که یک مدل زبانی آن را پیشبینی نمیکرد.
مقاله خود را انسانیسازی کنید
متنِ کمکگرفته از AI خود را دگرگون کنید و کاری کنید طبیعی به نظر برسد، بدون دست زدن به واژههای مهم یا ارجاعها.
نمره AI در واقع چه چیزی را میسنجد
نمره AI هیچ پایگاه دادهای برای مقایسه ندارد. یک طبقهبند نثرِ ارسالشده را میخواند و بر پایه الگوهایی که از نمونههای نوشتار انسانی و تولیدشده توسط AI آموخته است، برآورد میکند که این نثر تا چه اندازه احتمال دارد از یک مدل آمده باشد نه از یک انسان. هیچ بخشی از این برآورد به این وابسته نیست که آیا همان جمله دقیق پیشتر در جایی ظاهر شده است یا نه. یک جمله میتواند کاملا یکتا باشد، تا پیش از این ارسال هیچکس آن را تایپ نکرده باشد، و با این حال اگر انتخاب واژهها و ریتم آن از الگویی پیروی کند که یک مدل زبانی معمولا تولید میکند، از نظر آماری شبیه خروجی AI به نظر برسد.
این همان قلمرو آماری است که در شرح گستردهترِ اینکه آشکارسازهای AI در عمل چگونه کار میکنند به طور کامل پوشش داده میشود، یعنی پیشبینیپذیری در سطح واژه و ریتم در سطح جمله، که در یک نمره سندی واحد ادغام شدهاند. نسخه Turnitin از آن طبقهبند اختصاصی است، اما فرض بنیادین آن، یعنی اینکه متن تولیدشده از نظر آماری معمولا معمولیتر از نوشتار انسانی است، همان فرضی است که در پسِ هر ابزار این دسته قرار دارد.
| امتیاز شباهت | امتیاز AI | |
|---|---|---|
| چه چیزی را میسنجد | اینکه چه مقدار از متنِ ارسالشده با دیگر اسناد نمایهشده مطابقت دارد | اینکه نثر تا چه اندازه شبیه نوشتارِ آماریِ معمولِ تولیدشده توسط AI است |
| چه چیزی عدد بالا را فعال میکند | نقلقولهای طولانی، عبارتپردازیهای رایجِ خاصِ حوزه، مطالبِ بازاستفادهشده، یا تطابق با یک ارسالِ پیشین | ریتم یکنواختِ جملهها و انتخابهای واژگانیِ بهطور مداوم قابلپیشبینی در سراسر سند |
| آنچه عدد بالا ثابت نمیکند | اینکه متنِ مطابقشده بهطور نادرست استفاده شده است. مطالبی که بهدرستی ارجاع داده شدهاند نیز همچنان میتوانند بهصورت تطابق ثبت شوند. | اینکه هر جملهٔ منفردی توسط AI تولید شده است. این طبقهبند الگوی کلیِ سند را میخواند، نه یک خط را بهصورت جداگانه. |
آیا یک مقاله میتواند 0 درصد شباهت و 90 درصد امتیاز AI داشته باشد؟
بله، و این ترکیب یک اشکال نیست. این دو امتیاز به دو پرسش متفاوت پاسخ میدهند، بنابراین هر چهار ترکیبِ بالا و پایین ممکن است، و هر یک چیزی متفاوت دربارهٔ چگونگی تولید متن دلالت میکند.
- شباهت پایین، امتیاز AI پایین: نوشتارِ اصیلِ معمولی که در عین حال با تنوعِ معمولِ انسانی نیز خوانده میشود. حالت رایج برای بیشتر کارهای واقعیِ دانشجویی.
- شباهت پایین، امتیاز AI بالا: جملههای اصیل، نه کپیشده از هیچجا، که از نظر آماری بهصورت قابلپیشبینی خوانده میشوند، همانگونه که متنِ تولیدشده تمایل دارد. نشانهٔ نوشتارِ AI ویرایشنشدهای که هیچکس آن را از یک منبعِ موجود بازنویسی نکرده است.
- شباهت بالا، امتیاز AI پایین: متنی که با یک منبعِ موجودِ نوشتهشده توسط انسان بهطور نزدیک مطابقت دارد، بدون آن یکنواختیِ آماری که یک طبقهبند با تولید مرتبط میداند. متنِ کپیشده، که ابزارِ قدیمیتر آن را گرفته است نه ابزارِ جدیدتر.
- شباهت بالا، امتیاز AI بالا: متنی که با یک منبعِ موجود مطابقت دارد و خودِ آن منبع نیز AI-تولیدشده بوده است، برای نمونه یک مقالهٔ پیشتر ارسالشدهٔ نوشتهشده توسط AI یا صفحهای از متنِ تولیدشده توسط AI که پیشتر از وبِ باز نمایه شده است.
هیچیک از این ترکیبها از نظر نرمافزاری امر غیرعادیای را ایجاب نمیکند. این نتیجه از این واقعیت برمیآید که یک سامانه بهدنبال تطابق میگردد و دیگری بهدنبال الگو، و یک قطعه متن میتواند هر یک از این ویژگیها را داشته باشد، هر دو را داشته باشد، یا هیچیک را نداشته باشد.
آنچه یک امتیاز بالای AI انجام میدهد، و آنچه اثبات نمیکند
یک امتیاز بالای AI برآوردی آماری است، نه اعترافی که از متن استخراج شده باشد. این امتیاز میگوید نثرِ پیشِ روی طبقهبند، در انتخاب واژهها و ریتم خود، به نوعی از نوشتار شباهت دارد که مدل برای نسبت دادن آن به تولید AI آموزش دیده است. این امتیاز یک جمله مشخص را بهطور قطعی ماشیننوشته تشخیص نمیدهد، و درباره اینکه سند واقعاً چگونه تولید شده است نیز چیزی نمیداند، فقط میداند پس از تکمیل شدن چگونه خوانده میشود. TextPulse درباره اعداد خود نیز همین موضع را دارد: آنچه گزارش میکند یک Human Score برآوردی است که از متنِ پیشِ روی آن محاسبه شده است، نه حکمی درباره اینکه کدام ابزار، اگر اصلاً ابزاری بوده باشد، با سند تماس داشته است.
پاسخ عملی به هر یک از این دو عدد، چه یک similarity score پایین باشد و چه یک AI score بالا، یکسان است: باید آن را دلیلی برای بررسی دقیقتر دانست، نه یافتهای که بتوان آن را در نگاه نخست پذیرفت یا رد کرد. پیشنویسها، یادداشتها، و تاریخچه نسخهها به شیوهای که یک سند واقعاً نوشته شده است اشاره میکنند، به شکلی که هیچ درصدی، در هیچیک از این دو گزارش، هرگز نمیتواند. هر کسی که کنجکاو باشد یک طبقهبند در پیشنویس خودش دقیقاً به چه چیزی واکنش نشان میدهد، میتواند همان الگوی واژهدرسطح را با یک free perplexity checker برای خود ببیند، پیش از آنکه هر گزارشی تولید شود.
مجموعه free tools collection در TextPulse سایر لایههای آماری را که پیش از آنکه یک پیشنویس به دست مدرس برسد ارزش بررسی دارند، پوشش میدهد، نه فقط آن دو موردی را که در اینجا مقایسه شدهاند.
پس از جدا شدن این دو عدد، پرسش بعدی این است که چه چیزی یک Turnitin score خوب به شمار میآید. برای detector دیگری که دانشجویان بیش از همه با آن روبهرو میشوند، GPTZero چگونه کار میکند در صفحهای جداگانه توضیح داده شده است.
این دو عدد همچنان در همان گزارش کنار یکدیگر قرار خواهند داشت و افراد عجول همچنان آنها را بهصورت یک عدد واحد خواهند خواند. دانستن اینکه هر کدام در واقع به کدام پرسش پاسخ میدهد، چیزی است که یک جفت درصد گیجکننده را به دو بخش جداگانه و مفید از اطلاعات تبدیل میکند.
سؤالات متداول
Turnitin similarity در برابر AI score به این برمیگردد که هر کدام چه چیزی را بررسی میکنند. similarity score گزارش میدهد چه مقدار از یک submission با متنی که از پیش در پایگاه داده Turnitin از صفحات وب، publications و past student papers وجود دارد، مطابقت دارد. AI score یک سنجش جداگانه و مستقل است که برآورد میکند نثر تا چه اندازه machine-generated به نظر میرسد، بدون هیچ ارجاعی به هیچ پایگاه دادهای. مستندات خود Turnitin بیان میکند که این دو عدد بر یکدیگر اثر نمیگذارند.
PhD in natural language processing, with years spent building NLP applications end to end. Moe works on text analysis: lexical and syntactic structure, and what separates machine-generated prose from human prose statistically. He has been experimenting with computational linguistics since the early days of NLTK, spaCy and WordNet, and still writes most of his tooling in Python.



