Turnitin類似度スコアとAIスコア, 2つの異なるレポート
類似度スコアとAIスコアは異なる問いに答えるため, ある論文が一方では低く, 他方では高くても, どちらの数値も誤りではあり得ます。各スコアが何を測定するのか, 何がそれを引き起こすのか, そして高い数値が何を証明し, 何を証明しないのかを示します。

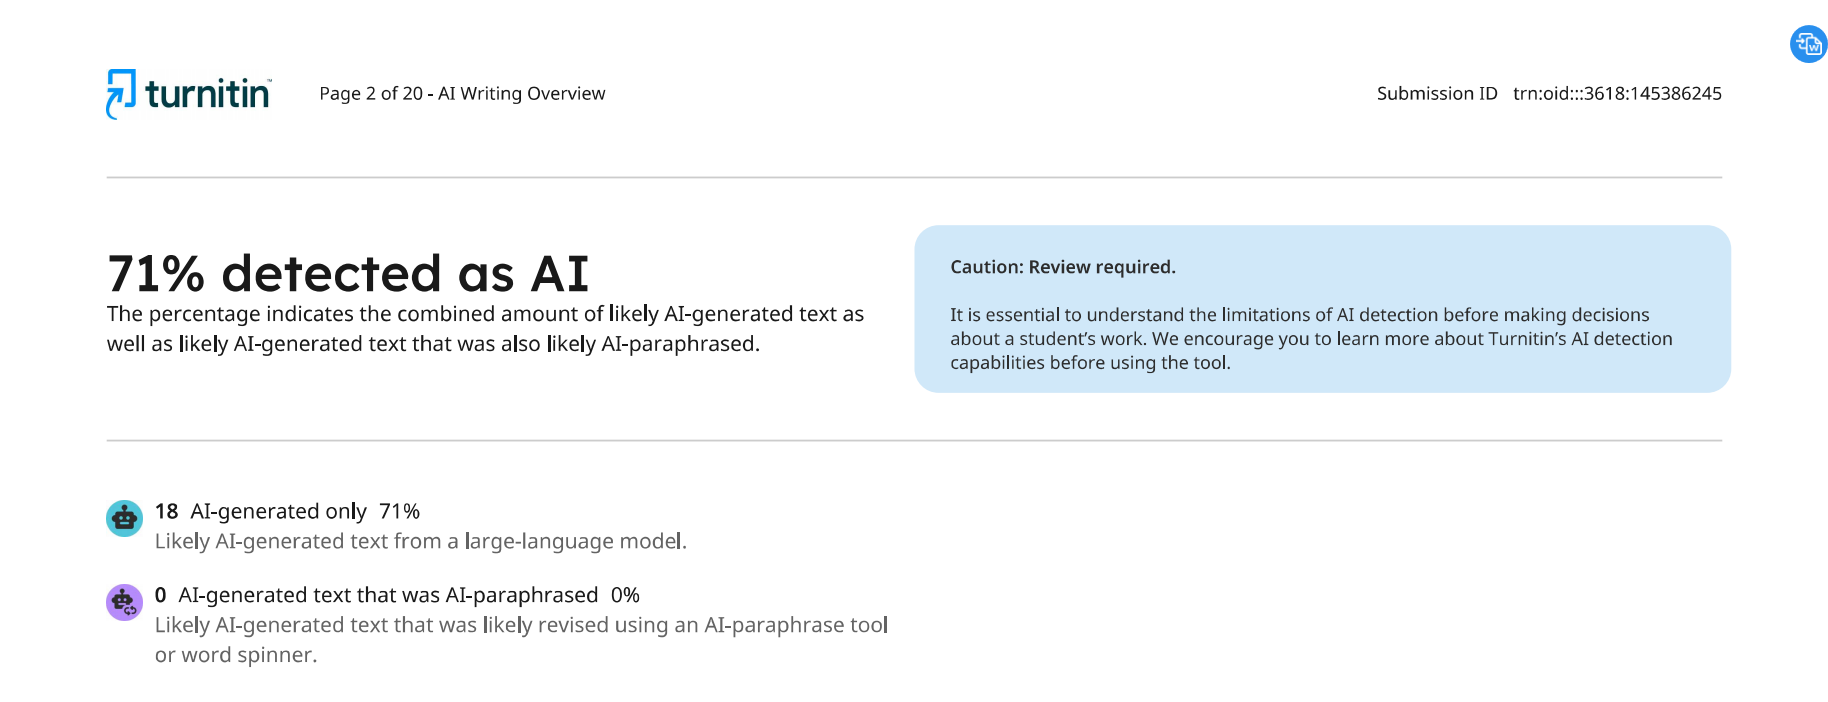
レポートには2つの数値が示されている。類似度スコアは3 percent、AIスコアは88 percentである。自然な読み方では、これらは同じものを測っているはずだと思われるため、低い数値なら高い数値もおそらく誤りだと考えがちである。しかし、そうではない。Turnitin similarity vs AI score は、2つの別個のシステムによる比較であり、それぞれが別のものを確認している。したがって、提出物が一方で低く、他方で高いスコアを示しても、どちらの数値も誤りではあり得る。
これはAIのものより古く、すでに存在するものとテキストが一致するかを検出するために作られた。これはより新しく、同じ Similarity Report に独立した測定として追加され、何かと一致するかどうかにかかわらず、文章が機械生成のように読めるかを推定するために作られた。Turnitinの公式文書によれば、両者は完全に独立しており、互いに影響しない。以下の内容も同様である。

Turnitin SimilarityとAI Scoreの違い, 各数値が示すもの
Turnitinは、この二つを一つの結果の二つの見方ではなく、一つの製品にまとめられた異なる測定として扱う。Similarity Reportは、提出物をウェブコンテンツ、学術出版物、過去に提出された学生論文のデータベースと照合し、提出物のテキストのうち、そのデータベース内の既存資料と一致する割合を返す。AI writing detectionはまったく別のモデルで動作し、同じレポート内に独立したスコアとして追加されている。このモデルは、ある文章の散文が機械生成の文章にどれほど似ているかを判断するよう訓練されており、外部データベースを一切参照しない。TurnitinのAI classifierがその数値に到達する仕組みの詳細は別に扱うが、ここで重要なのは、それが同じレポート内にあるSimilarity engineとは異なる問いに答えているという点である。
Similarity Scoreが実際に測定するもの
Similarityは照合の作業であり、判断ではない。Turnitin自身のガイダンスは、このツールが盗用をチェックしないことを明確に述べている。ツールは重複を確認し、その解釈はレポートを読む教員に委ねる。正しく区切られた引用、ある下位分野全体で共有される方法論の一節、学術誌のすべての論文が同じ形式で記す参考文献一覧, これらはすべて一致として記録されうる。なぜなら、このシステムは重複する文字列を数えるのであって、その重複が正当かどうかを判断するわけではないからである。
それが、類似度スコアがゼロであっても見た目ほどの意味を持たない理由でもある。これは、提出物に Turnitin の索引化されたソースの中で他に見つかる、長く途切れない文章の連続が含まれていないことを意味するにすぎない。そこにある文がどのように生成されたかについては何も示さない。なぜなら、データベース内の何にも一致しない文を生成することは、言語モデルが予測しなかったであろう文を生成することと同じ技能ではないからである。
自分の論文を人間らしくする
重要な語句や引用には手を加えずに、AI支援テキストを変換して自然な人間の文章のようにします。
AI スコアが実際に測定するもの
AI スコアには、照合すべきデータベースがない。分類器は提出された散文を読み、人間による文章と AI によって生成された文章の例を通じて学習したパターンに基づいて、その散文が人間ではなくモデルから生じた可能性がどれほど高いかを推定する。その推定は、当該の文が過去にどこかで正確に現れたことがあるかどうかには一切依存しない。ある文は完全に独自であり、この提出物まで誰も入力したことがなくても、その語の選択とリズムが言語モデルが生成しがちなパターンに従っていれば、統計的には AI 出力に典型的であると読まれうる。
これは、AI 検出器が実際にどのように機能するかについてのより広い説明で全面的に扱われているのと同じ統計的領域である。すなわち、語レベルの予測可能性と文レベルのリズムを、1 つの文書スコアにまとめたものである。Turnitin のこの分類器は独自仕様であるが、生成されたテキストは人間の文章よりも統計的に典型的である傾向があるという根本的な前提は、この種のあらゆるツールの下で働いている同じものである。
| 類似度スコア | AIスコア | |
|---|---|---|
| 何を測定するか | 提出物のテキストのうち、他の索引化された文書と一致する割合 | その散文が、統計的に典型的なAI生成文にどれほど似ているか |
| 高い数値を引き起こすもの | 長い引用、分野特有の一般的な言い回し、再利用された素材、または以前の提出物との一致 | 文書全体にわたる均一な文のリズムと、一貫して予測可能な語の選択 |
| 高い数値が証明しないこと | 一致したテキストが不適切に使用されたこと。適切に引用された素材でも、一致として記録されることがある。 | 単一の文がAIによって生成されたこと。分類器は文書全体のパターンを読み取り、1行を孤立して見るわけではない。 |
論文は0 Percentの類似度と90 PercentのAIスコアを持ちうるか
はい、その組み合わせは不具合ではない。2つのスコアは異なる問いに答えるため、高い値と低い値の4通りの組み合わせがすべて可能であり、それぞれがテキストがどのように作成されたかについて異なる意味を持つ。
- 類似度が低く、AIスコアも低い場合, 通常の独自の文章であり、かつ人間の典型的な変化を伴って読める。多くの真正な学生の課題における一般的なケースである。
- 類似度が低く、AIスコアが高い場合, どこからもコピーされていない独自の文であるが、生成テキストにありがちなように統計的に予測可能に読める。既存の情報源から誰も言い換えていない、未編集のAI執筆の特徴である。
- 類似度が高く、AIスコアが低い場合, 生成と関連づけられる統計的な平板さを伴わずに、既存の人間が書いた情報源と高い一致を示すテキストである。コピーされたテキストであり、より新しいツールではなく、より古いツールによって検出されたものである。
- 類似度が高く、AIスコアも高い場合, 既存の情報源と一致するテキストであり、その情報源自体がAI生成であった。たとえば、以前に提出されたAI執筆の論文や、オープンウェブからすでに索引化されていたAI生成テキストのページである。
これらの組み合わせのいずれも、ソフトウェア側で特別なものを必要としない。これは、一方のシステムが一致を確認し、他方のシステムがパターンを確認するという事実から生じるものであり、テキストの一部は、いずれかの性質、両方の性質、あるいはどちらの性質も持ちうる。
高い AI スコアが証明するもの、証明しないもの
高い AI スコアは統計的推定であり、テキストから引き出された自白ではない。それは、分類器の前にある文章が、その語の選択とリズムにおいて、モデルが AI 生成と結び付けるよう学習した種類の文章に似ていることを示す。特定の文が確実に機械によって書かれたと特定するものではなく、文書が実際にどのように作成されたかについては何も知らない。完成した後にどのように読めるかだけを見ている。TextPulse も自らの数値について同じ立場を取っている。そこが報告するのは、目の前のテキストから算出された推定 Human Score であり、どのツールが、もしあれば、文書に触れたのかについての判定ではない。
低い類似度スコアであれ高い AI スコアであれ、実際の対応は同じである。見た瞬間に受け入れたり退けたりする判断材料ではなく、より詳しく確認する理由として扱うべきである。下書き、メモ、版の履歴は、文書が実際にどのように書かれたかを示すものであり、どちらの報告でも、百分率では決して示せない。分類器が自分の下書きの何に実際に反応しているのかを知りたい人は、報告が生成されるずっと前に、free perplexity checker で同じ語レベルのパターンを自分で確認できる。
TextPulse の free tools collection は、下書きが指導者の目に触れる前に確認する価値のある、他の統計的層も扱っており、ここで比較した 2 つだけではない。
2 つの数値を分けて考えた後、次の問いは what counts as a good Turnitin score である。学生が最もよく出会うもう一方の検出器については、how GPTZero works が別ページで扱われている。
この2つの数値は、同じレポート上で引き続き並んで表示され、急いでいる人には1つの数値として読み取られ続けるでしょう。各数値が実際にはどの問いに答えているのかを知ることが、紛らわしい2つの割合を、別々で有用な2つの情報に変えるのです。
よくある質問
Turnitin類似度 vs AIスコアは, それぞれが何を確認するかにかかっています。類似度スコアは, 提出物のどの程度がTurnitinのウェブページ, 出版物, 過去の学生論文のデータベースに既にあるテキストと一致するかを示します。AIスコアは, 別個の独立した測定であり, 文章が機械生成のようにどの程度読めるかを推定しますが, いかなるデータベースも参照しません。Turnitin自身の文書は, この2つの数値が互いに影響しないと述べています。
PhD in natural language processing, with years spent building NLP applications end to end. Moe works on text analysis: lexical and syntactic structure, and what separates machine-generated prose from human prose statistically. He has been experimenting with computational linguistics since the early days of NLTK, spaCy and WordNet, and still writes most of his tooling in Python.



