Hogyan működik a GPTZero
A GPTZero a perplexity és burstiness fogalmakat tette ismertté, majd csendben mindkettőt elhagyta. Itt olvasható, mit mér most az osztályozója, mit mutat valójában egy jelentés, és hol jelöli meg maga az eszköz a korlátait.

Írja be a keresősávba, hogy „how gptzero works”, és a legtöbb találat még mindig a perplexityről és burstinessről szól, a két statisztikáról, amelyet a vállalat saját alapítója tett híressé az első hetekben a ChatGPT megjelenése után. Ez a leírás 2023 januárjában pontos volt. Azóta, ugyanazon év őszétől nem volt pontos, amikor a GPTZero saját dokumentációja szerint a cég teljesen más módszerre cserélte azt. A különbség aközött, amit a eszköz a kezdetkor csinált, és aközött, amit ma csinál, akkora, hogy a ma is keringő magyarázatok többsége olyan termékről beszél, amely már nem létezik.
Ma a GPTZero mondatról mondatra osztályoz egy nagy, vegyes korpuszon, amely ember által generált és AI által generált szövegeket is tartalmaz, nem pedig egy perplexity-számítást végez. A mai GPTZero továbbra is egyetlen főszámot ad meg, de a számolás más. A főszám alatt megjelenő mondatszintű kiemelés jelentése is más, mint 2023-ban. Mindkét változat ismerete hasznos: az, amely híressé tette a kifejezéseket, és az, amely ténylegesen ma fut.
A történet: Hogyan tette híressé a perplexity és a burstiness a GPTZero-t
2023. január 2-án a korábbi Princeton-hallgató Edward Tian nyilvános bemutatót tett közzé a GPTZero-ról, alig néhány héttel azután, hogy a ChatGPT megjelent. Az eredeti magyarázó oldala leírja, hogyan használt két, a nyelvmodellezésből kölcsönzött statisztikát annak észlelésére, hogy egy nyelvi modell valami olyasmit írt-e, amit a nyelvi modell generált. A Perplexity egy olyan pontszám, amely azt méri, mennyire volt meglepő egy viszonyítási modell számára a szövegben szereplő szavak megválasztása. A Burstiness a GPTZero elnevezése arra, hogy ez a meglepetés mennyire ingadozott egy dokumentumon belül. Ezek a magyarázó oldalak az okai annak, hogy a két szó egyáltalán bekerült a mindennapi beszédbe az AI-írással kapcsolatban. A legtöbben, akik ma meg tudják határozni a perplexityt vagy a burstinesst, nem tankönyvből tanulták meg a kifejezéseket, hanem a GPTZero-ból.
A mechanizmus maga egyszerűen leírható volt. Vigyünk át egy szövegrészletet egy viszonyítási nyelvi modellen, és az a próza, amelyet a modell nagyon kiszámíthatónak talál, alacsony perplexityvel, gépszerűnek hat, mivel a generálás során a valószínűbb következő szó előnyben részesül a meglepővel szemben. A GPTZero saját, már visszavont dokumentációja még egy hüvelykujjszabályt is közzétett: a 85 feletti perplexity-pontszámot nagyobb valószínűséggel emberinek, mint gépinek olvasták. Ez a küszöb egyetlen szolgáltatótól származott, egyetlen modellnél, egy adott időpontban, és a GPTZero maga már nem áll mögötte.
Hogyan működik a GPTZero most: mondatszintű osztályozó
A GPTZero támogatási központja ezt egyértelműen kimondja: „2023 őszétől a GPTZero már nem használja a perplexityt és a burstinesst az AI-észleléshez, mert mélytanuláson alapuló architektúrára váltottunk.” A jelenlegi technológiai oldal pedig megerősíti, hogy a váltás teljes. Leír egy „végponttól végpontig tartó mélytanulási megközelítést, amelyet a weben, az oktatásban és AI által generált szöveges adatkészleteken képeztek ki, különféle LLM-ekből”, amelyben „egy mondatról mondatra történő osztályozó modell meghatározza annak valószínűségét és megbízhatóságát, hogy egy szöveget AI hozott-e létre”. A perplexity és a burstiness ezen az oldalon sehol nem jelenik meg.
Azóta egy további védelmi réteg is bekerült, a Paraphraser Shield, amelyet arra terveztek, hogy az olyan AI-szöveget kiszűrje, amelyet egy átfogalmazó eszközön futtattak át az észlelés kijátszása érdekében. Beilleszthet szöveget, feltölthet Word-dokumentumokat, PDF-eket és képfájlokat, egyszerre legfeljebb ötven fájlt. Ennek az infrastruktúrának semmi köze ahhoz, hogy hányszor találta volna el ugyanazt a szót egy referencia modell.
Mit mutat valójában a GPTZero-jelentés
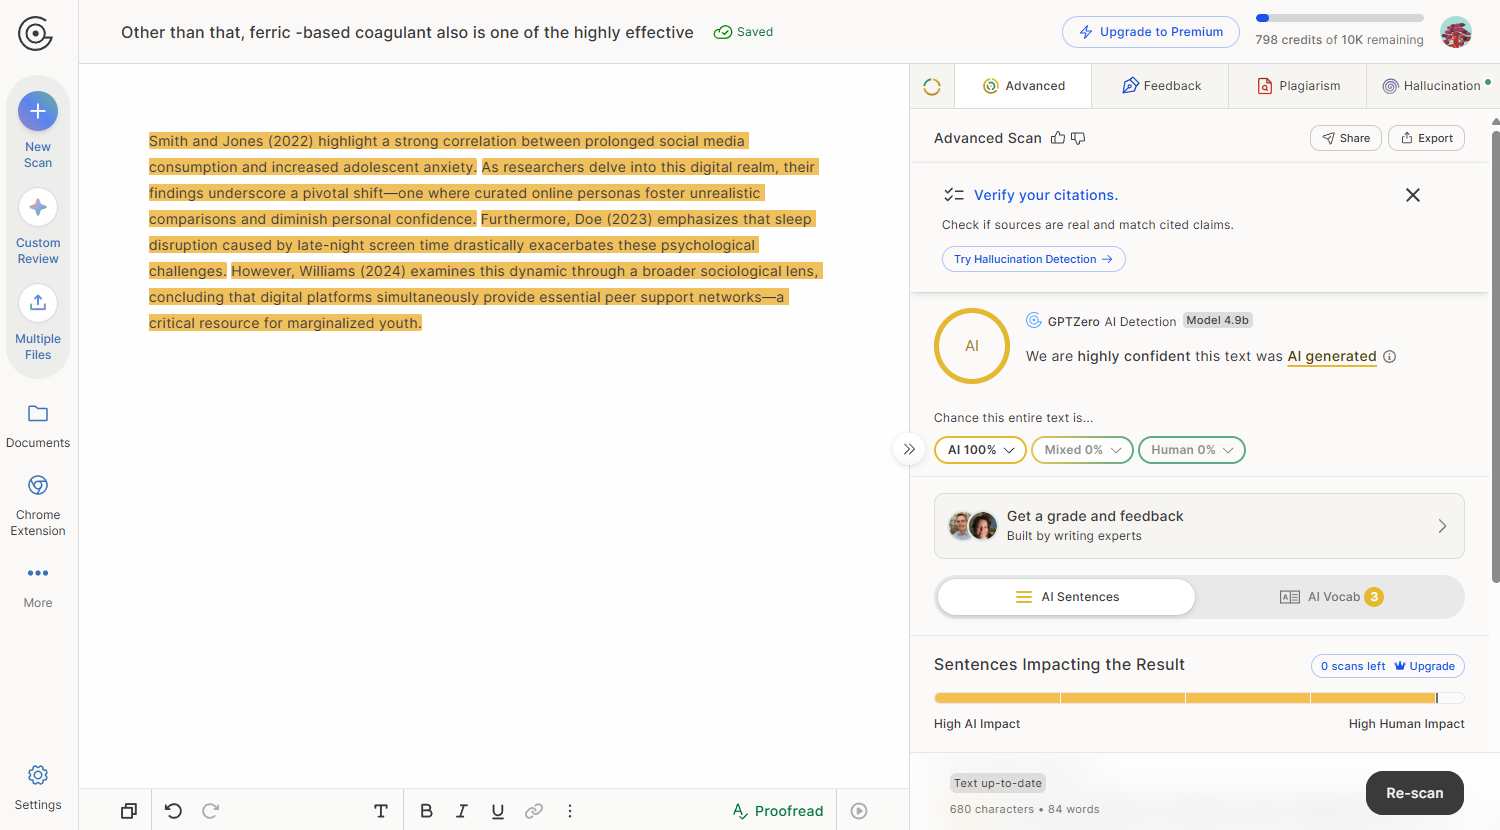
A GPTZero eredmény három részből áll: az AI, emberi vagy vegyes besorolásból, egy százalékos értékből, amely azt fejezi ki, hogy a modell mennyire valószínűnek tartja, hogy a dokumentum AI-val készült, valamint egy bizalmi címkéből, amely leírja, mennyire megbízható az adott előrejelzés. A címke fontosabb, mint amennyire első pillantásra tűnhet. A GPTZero a „nagyon magabiztos” kategóriát 2 százalék alatti hibaarányhoz köti, a „alacsony bizalom” kategóriát pedig 14 százalékos vagy annál magasabb hibaarányhoz, egy olyan széles tartományhoz, amelyben ugyanaz a címszázalék nagyon eltérő súlyt kaphat egyik jelentéstől a másikig.
A fizetős vizsgálatok mondatszintű kiemelést adnak, és érdemes helyesen olvasni. A GPTZero a kiemelt mondatokat úgy írja le, mint amelyek aránytalanul nagy mértékben befolyásolják az összpontszámot, nem pedig mint az egyes sorok elleni vádak listáját. Egy mondat lehet, hogy nem kerül kiemelésre, mégis alakíthatta az eredményt, mert az osztályozó a dokumentum egészét olvassa, nem pedig mondatról mondatra szavaz.
| Jelentés elem | Mit mond Önnek |
|---|---|
| Besorolás | Egyetlen címke: AI, emberi, vagy vegyes |
| AI valószínűségi pontszám | Egy százalékos érték, amely azt tükrözi, hogy a modell mennyire valószínűnek ítéli a dokumentumról, hogy AI-val készült |
| Bizalmi címke | A „nagyon magabiztos” kategóriától, 2 százalék alatti hibaaránnyal, az „alacsony bizalom” kategóriáig, 14 százalék vagy annál magasabb hibaaránnyal |
| Mondatkiemelés | Megjelöli azokat a mondatokat, amelyek a legtöbbet adják a pontszámhoz az Advanced Scan során, nem pedig minden olyan mondatot, amely kapcsolódik hozzá |
Ezek közül egyik jelentéselem sem létezett jelenlegi formájában, amikor a perplexity-and-burstiness magyarázó még a GPTZero saját, nyilvános leírása volt. A felület a módszerrel együtt változott.
Emberibbé tenni saját dolgozatát
Alakítsa át az AI által támogatott szövegét úgy, hogy emberinek hangozzon, anélkül hogy fontos szavakat vagy hivatkozásokat érintene.
Miért kering még mindig a Perplexity és Burstiness leírás
A GPTZero eredeti magyarázó anyaga még mindig elérhető online, még mindig indexelt, és még mindig az egyik legáttekinthetőbb általános leírása annak, hogyan működik a perplexity és a burstiness mint fogalom. A keresőmotorok és más oldalak továbbra is hivatkoznak rá, és egyesek egy széles körben megosztott 2026-os értékelésre mutatnak, amely azt állítja, hogy az eszköz továbbra is csendben egy perplexity és burstiness réteget futtat a klasszifikáló mellett. A GPTZero saját jelenlegi oldalai, a technológiai oldal és mindkét támogatási cikk ezzel szemben mást mondanak: a kifejezéseket visszavonták, nem csupán a háttérben rejtették el. Egy fogalmat elvontan leíró oldal nem ugyanaz, mint egy oldal, amely ennek az eszköznek a jelenkori módszerét írja le, és a kettő felcserélhetőként kezelése az egyik legfőbb oka annak, hogy a zavar három évvel a lejárati időpontja után is fennmaradt.
Ez a trivián túl is számít. Egy diák vagy kolléga azt az útmutatást kapja, hogy csökkentse a perplexity-t, vagy terítse szét a mondathosszakat kifejezetten azért, hogy legyőzze a GPTZero-t, miközben olyan termékváltozatra szabott tanácsot kap, amely 2023-ban leállította a működését. Ami egy mondatklasszifikátort mozdít el, az egy kapcsolódó, de eltérő kérdés, közelebb az ahhoz az általánosabb leíráshoz, hogy az AI detektorok valójában hogyan működnek, mint bármelyik önmagában vett statisztikához. A GPTZero nem hagyta abba ezek mérését, saját beszámolója szerint a jelenlegi modell hét indikátora között vannak, de már nem azok döntik el a választ.
Mit mond a GPTZero, amit nem tud megtenni
A GPTZero által közzétett benchmarkjai nagyjából olyan erősek, amilyet egy szolgáltató várhatóan saját termékéről közzétesz. A vállalat azt jelenti, hogy „99% pontossági arányt” ér el az AI által generált szöveg és a humán írás elkülönítésében, azt mondja, hogy „az értékelés során az AI és a humán szöveg összevetésekor a GPTZero téves pozitív arányát legfeljebb 1% szinten tartjuk”, és „96,5% pontossági arányt” rögzít olyan beküldések esetén, amelyek AI és humán írást vegyítenek, emellett 1,1 százalékot a TOEFL esszéken, ami gyakori helyettesítője a nem anyanyelvi angol írásnak. Ezek az adatok a GPTZero saját értékeléséből származnak, amelyet 2025 januárjában tettek közzé, és azokat bemutató oldalon nem hivatkoznak független replikációra. Ugyanez az oldal vissza is vonja azt az állítást, amelyet a legtöbb szolgáltató hangoztat, mondván, hogy „soha nem lesz 100% garancia”, és hogy aki ennél többet állít, valószínűleg hibát követett el az adataiban vagy az értékelési módszerében.
A GPTZero saját korlátokat ismertető oldala pontosabb, mint a marketingadatok. A vállalat szerint a pontosság javul, ahogy több szöveget küldenek be, és csökken mondatszinten és bekezdésszinten a teljes dokumentumhoz képest. Azt is közli, hogy a képzési adatai többnyire felnőtt angol prózából állnak, ezért az ettől a mintától eltérő szöveget nehezebb megbízhatóan besorolni. Azt állítja, hogy az osztályozót nem arra képezték ki, hogy az AI-szöveget kiszúrja, ha a generálás után azt erősen módosították. És azt is egyértelműen kijelenti, hogy más, gép által generált vagy erősen eljárás jellegű írás, nem csak a chatbot kimenete, ugyanilyen módon jelölhető.
Ez mind nem ok arra, hogy a GPTZero számát megkérdőjelezhetetlennek tekintsük, és nem is ez az egyetlen detektor, amelyet érdemes a saját feltételei szerint megérteni. Azok, akik kíváncsiak arra, hogy egy ilyen osztályozó valójában mire reagál, saját maguk is láthatnak egy változatot abból a mintából egy ingyenes perplexity checker vagy egy ingyenes burstiness checker segítségével, a ingyenes eszközök gyűjteményének két olyan darabjával, amelyek a jelen típusú jelentések által használt további statisztikai rétegeket is lefedik.
A GPTZero két vezető statisztikájának külön oldala van: mit mér a perplexity az AI detektálásban, valamint az a token probability aritmetika, amely mindkét számot előállítja.
Egy olyan eszköz, amely ilyen pontosan megnevezi a saját vakfoltjait, több bizalmat érdemel, mint egy olyan, amely azt állítja, hogy nincsenek, és a jelentésben a következő megmagyarázatlan százalék jó kiindulópont annak feltérképezéséhez, hogy milyen típusú eszköz állította elő.
Mit mutatott a saját kutatásunk
A TextPulse Research detektor-egyezési tanulmányában kilenc kereskedelmi AI-detektor értékelte ugyanazt a 90 akadémiai szöveget. Az egyik egy 455 szavas hibrid szöveg volt: ember írta bevezetés és zárás, közötte 168 szavas, AI által írt középrész. A GPTZero erre a szövegre 41.2% AI értéket adott, miközben a többi eszköz ítélete ugyanezekre a szavakra 0% és 95.7% AI között szórt. A teljes tanulmány, a korpusz és az eszközönkénti pontszámmátrix szabadon elérhető itt: TextPulse Research.
Gyakran ismételt kérdések
Nem. A GPTZero támogatási központja szerint a vállalat 2023 őszétől, a mélytanulási osztályozóra való áttérés után, megszüntette a perplexity és burstiness használatát az észleléshez. A jelenlegi technológiai oldala mondatról mondatra működő osztályozási modellt ír le, és egyik kifejezést sem említi. A leírás azért kering továbbra is, mert a GPTZero saját 2023-as magyarázata a módszer megváltozása előtt mindkét szót népszerűsítette.
PhD in natural language processing, with years spent building NLP applications end to end. Moe works on text analysis: lexical and syntactic structure, and what separates machine-generated prose from human prose statistically. He has been experimenting with computational linguistics since the early days of NLTK, spaCy and WordNet, and still writes most of his tooling in Python.



